3.3 质量控制与标准化
3.3 质量控制与标准化
QC(质量控制)样品是从全部研究样品中各取少量混合而成的"池",它没有生物学个性,因此任何变化都来自系统本身。把 QC 像三明治一样穿插进上机序列,仪器的漂移、信号衰减就变得可见、可量化、可校正。
为什么需要 QC:仪器是活的
一台 LC-MS 连跑 100 针:柱温箱缓慢升温、色谱柱慢慢流失、离子源被基质污染、检测器增益漂移。同一份 QC,第 1 针和第 100 针的峰面积可能差 30%——如果病例组恰好集中在前半段,恭喜你发现了"批次"而不是疾病。
上机序列的正确排布
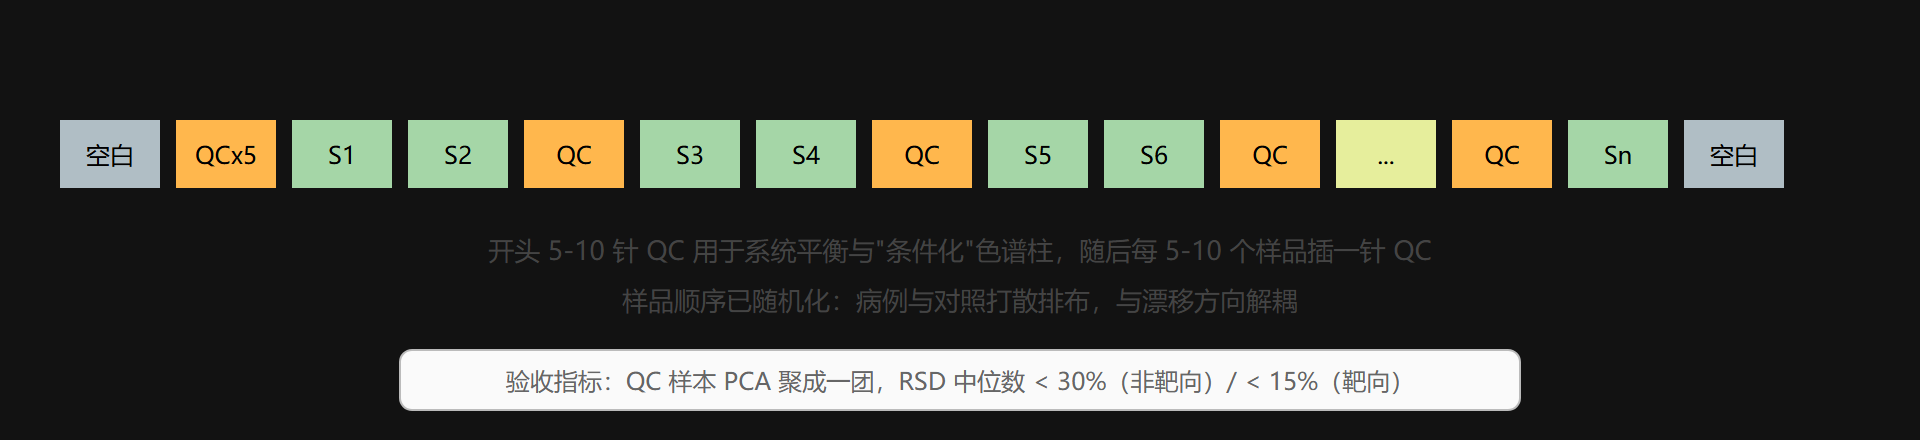
三种质控角色
| 角色 | 做法 | 回答什么问题 |
|---|---|---|
| 过程空白 | 空管走完全流程 | 峰是污染物还是样品成分(塑料管析出物很常见) |
| QC 池 | 全体样品等体积混合 | 系统漂移有多大、能否校正 |
| 内标 | 前处理前加入非内源同位素物 | 每管提取效率的波动 |
内标选同位素标记版本(d4-丙氨酸、C13-棕榈酸)最稳,因为化学行为几乎一致只是质量偏移。成本不够时按化学类别各配一个代表性的。
漂移校正示意
QC 校正常用 LOESS 回归:以进样序号为横轴、QC 峰面积为纵轴拟合漂移曲线,再用它把每个样品"拉回"基线。一段可跑的思路代码:
# qcs: QC峰面积向量, injections: 进样序号, sample_val: 某样品该峰面积 fit <- loess(qcs ~ injections, span = 0.75) drift_at_sample <- predict(fit, newdata = data.frame(injections = inj_i)) corrected <- sample_val * mean(qcs) / drift_at_sample
判断特征峰"能不能救"的通行标准:QC 中相对标准偏差 RSD < 30% 保留,> 30% 的特征整体丢弃——校正救不了本来就测不稳的峰。
⚠️ 常见坑:跨多天、多批提取的数据,先看 QC 的 PCA——如果 QC 按提取日期自动分开,说明批次效应大于生物学差异,必须按批次做校正或把批次作为协变量进模型,硬分析会得到"日期决定疾病"的荒谬结论。
本节要点回顾
- QC 池是系统误差的显影剂:无生物学个性,变化即系统变化
- 序列设计:开头条件化 + 每 5-10 针穿插 + 样品随机
- 三种角色分工:空白查污染、QC 查漂移、内标查提取
- LOESS 校正 + RSD 30% 阈值是非靶向的通行做法
- QC-PCA 先于一切分析:批次聚类是最大的红灯
第 4 章进入仪器本身。
质控样本的三种角色
pooled QC(全部样本等量混合)承担仪器漂移校正与数据质量门槛;内部标准(isotope-labeled IS)承担提取回收与离子化波动的校正;空白对照(溶剂空白、提取空白)承担污染识别(增塑剂 DEHP、PEG 系列是常客)。三者的组合使用规范是:每 8–12 个研究样本插入一个 pooled QC,序列首尾各 5–10 个 QC 用于系统平衡(cond 期不用作统计)。
CV 门槛与信号过滤:一个标准流程
import statistics as st # 模拟某代谢物在 15 个 pooled QC 中的响应值 qc = [1.02, 0.98, 1.05, 1.01, 0.97, 1.08, 1.00, 0.96, 1.03, 1.06, 0.99, 1.02, 1.04, 0.98, 1.01] cv = st.stdev(qc) / st.mean(qc) * 100 print(f"pooled QC 中 CV = {cv:.1f}%") verdict = "保留" if cv < 20 else ("仅定性" if cv < 30 else "剔除") print(f"判定:{verdict}(门槛:靶向<15%,非靶向<20–30%)") # 批内校正后再看:LOESS 随进样顺序拟合 QC 漂移并插值校正样本 drift = [0.95, 0.97, 1.02, 1.05, 1.06] # 前 5 个 QC 的位置漂移趋势 print(f"检测到仪器漂移趋势:{drift[0]:.2f} → {drift[-1]:.2f}," f"需启用 QC-RLSC/LOESS 校正")
标准化的三层含义
层一是仪器层:内标归一化 + 信号漂移校正(QC-RLSC);层二是样本层:肌酐校正(尿液)、总蛋白校正(组织)、干重或细胞数校正(细胞);层三是统计层:中心化、标度化(pareto 或 autoscaling)以平衡高低浓度代谢物的权重。三层不可互相替代——用统计标度化弥补仪器漂移是最常见的误操作,会把系统性漂移"均匀抹进"所有代谢物,污染全部下游结果。每层该用哪种方法,第 5 章预处理节会给出决策树,本节的底线是:QC 的 CV 门槛在未过校正的原始数据上先看一遍,过线了才允许进入下一层。
质控的收尾是报告规范:投稿前准备好四张"质量底牌"图——QC 的主成分分析图(QC 点应聚成一团,散开即批次失控)、全部特征的 CV 分布直方图(标注中位数)、空白扣除的峰清单(列明剔除的污染物)、内标回收率的时间轨迹。四张图放进补充材料,审稿人的第一轮质疑可以减少一半。把质控当成"给数据办的出厂检验",而不是走流程的表格勾选,是实验室成熟度的直观标志。
关于空白对照再多说一层:提取空白(走完全部前处理流程的纯溶剂)能暴露前处理环节引入的污染(塑料离心管的增塑剂、滤膜的聚合物、溶剂中的添加剂),溶剂空白只能暴露仪器残留。两类空白都要在序列中占位,且污染物清单要进数据分析脚本自动过滤——人工记忆剔除在几十个峰的规模尚可,在数百污染峰规模必出错。常见污染物本身就是一份"博物馆":DEHP 及其代谢物来自塑化 PVC,PEG 系列来自去污剂残留,肉豆蔻酸与棕榈酸酯常来自手套与指尖,把这张清单贴在进样室墙上是许多成熟实验室的传统。
内标回收率还应分浓度水平评估:在高、中、低三个加入水平(例如基线的 0.5×、1×、5×)分别计算回收,若三个水平的回收率差异超过 15%,说明存在浓度依赖的基质效应,需重新优化前处理或改用同位素内标组合。 Reporting 时把每批的 RSD 中位数、回收率均值与超出 2 SD 的 QC 样本编号一并写进数据发布包,审稿人对"QC 策略可复核"的期待即得到完整回应。