5.2 代谢物鉴定与注释:给峰起名字
5.2 代谢物鉴定与注释:给峰起名字
非靶向数据里 70% 以上的特征是匿名的。把它们变成名字要过四道证据关(m/z、保留时间、碎裂谱、标准品),代谢组学标准倡议(MSI)据此把置信度分为四级。论文里写"鉴定到"还是"暂定注释",不是措辞问题,是诚实问题。
MSI 四级分级
鉴定置信度阶梯
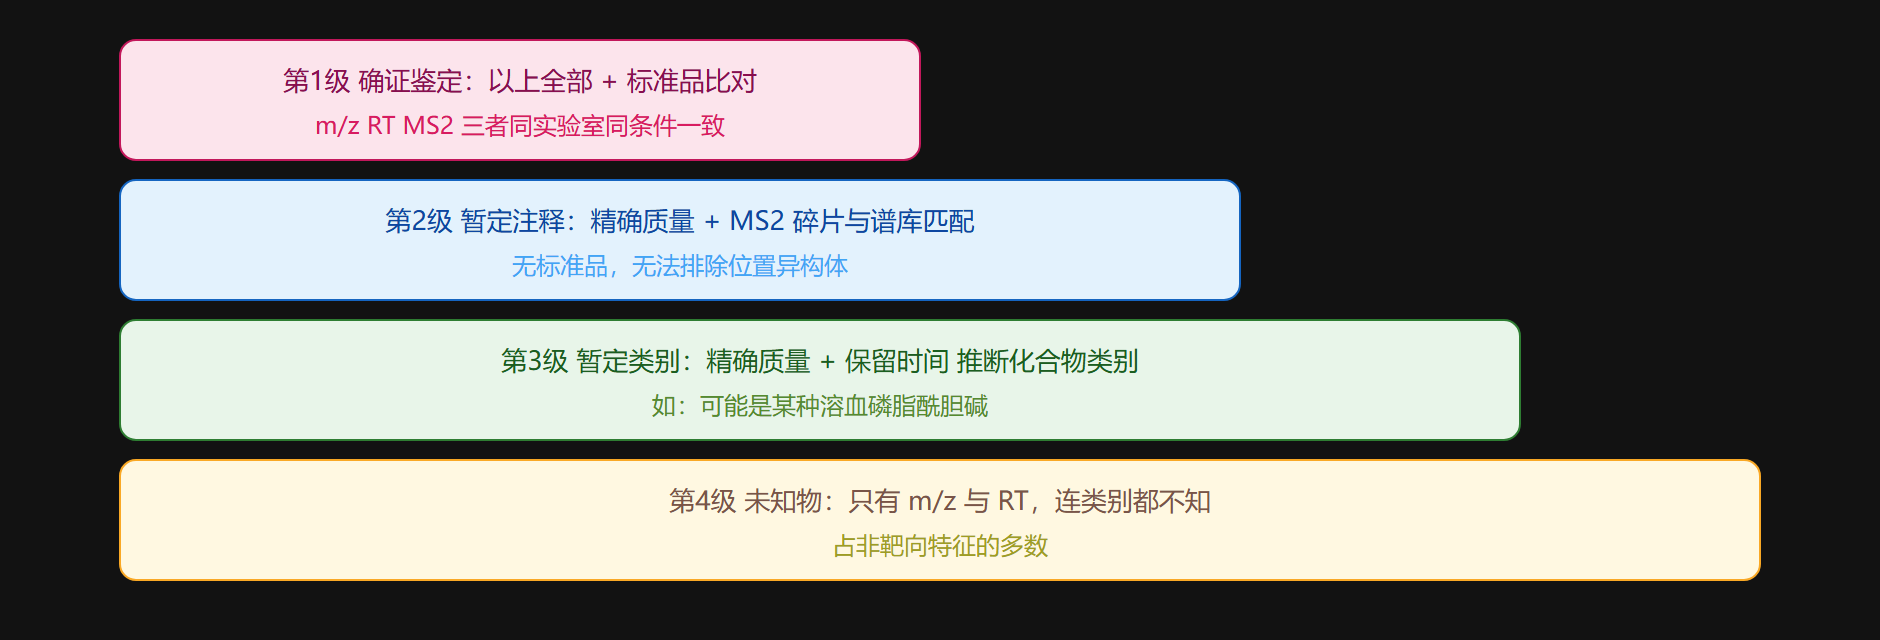
阶梯的形状本身就是教训:成本越低能到达的层级越低。一个课题能把核心差异物推到第 1 级,通常只有十来个;把上百个特征全写成"identified",审稿人一眼识破。
实操工作流
第 2 级注释的标准动作是谱库检索,主流工具与库:SIRIUS/CSI:FingerID(碎片谱预测树)、GNPS 分子网络、HMDB、MassBank、mzCloud。多库交叉比对的伪流程:
# 概念示意:一个特征的注释决策 candidate = search_ms2(mz=351.0578, tol_ppm=5, spectrum=ms2) # 命中列表按打分排序,要人工核对三件事: # 1. 分子式与精确质量是否唯一解释(加合物形式判定对不对) # 2. 诊断碎片是否出现(如胆碱头基碎片 m/z 184) # 3. 保留时间是否符合其极性(脂质链越长 RT 越大,反着来的存疑) confidence = "level_2" if candidate.score > 0.7 and diag_frag_ok else "level_3"
为什么碎裂谱比对难
三点结构性困难:一,同一个 m/z 可能对应几十个合理分子式(质量精度 5 ppm 内仍有歧义);二,位置异构体(脂肪链双键位置)碎裂谱几乎相同;三,实验间碰撞能量不同导致谱图不可直接比——这也是 CCS(4.3 节)和标准化碎裂协议被寄予厚望的原因。
💡 关键直觉:注释结果要当作"带概率的假设"参与下游分析。差异通路富集时,第 2 级注释的代谢物带来的不确定性会传导到结论——把注释级别写进结果表,让读者(和你自己)知道哪些证据是硬的。
本节要点回顾
- 四级阶梯:标准品确证 → MS2 注释 → 类别推断 → 未知物
- 成本决定层级:全数据集第 1 级鉴定不现实,核心差异物值得买标准品
- 多库交叉 + 诊断碎片 + RT 合理性三重人工核对不可省
- 异构体与碎裂条件差异是注释的两大顽疾
- 注释级别必须随表报告,这是数据诚实性的底线
下一节对命好名的矩阵做统计。
置信度的经济学:注释深度与成本的权衡
Level 1 注释每代谢物需要购买标准品、重新进样匹配 RT 与 MS/MS,成本约每代谢物数十至数百元且耗时;全谱 1000 峰全部 Level 1 既不可能也不必要。务实的分诊策略:统计显著且通路相关的少数候选(通常 20–50 个)升到 Level 1,其余保持 Level 2–3 并如实标注。把 Level 2 写成"鉴定"是代谢组学论文被撤稿与更正的高频原因。
分子网络:把注释从孤证变成互证
# 简化分子网络:按 MS/MS 谱相似度(余弦)连边,注释沿边传播 sims = [("M1", "M2", 0.92), ("M2", "M3", 0.88), ("M3", "M4", 0.41), ("M4", "M5", 0.85)] known = {"M1": "溶血磷脂酰胆碱 16:0(Level 1)"} adj = {} for a, b, s in sims: if s > 0.7: adj.setdefault(a, []).append(b); adj.setdefault(b, []).append(a) # BFS 传播:与已知物连通的未知物获得"类似物注释" from collections import deque q, seen = deque(["M1"]), {"M1"} while q: cur = q.popleft() for nxt in adj.get(cur, []): if nxt not in seen: seen.add(nxt) q.append(nxt) print(f"从 M1 出发可传播注释的节点: {sorted(seen)}(M4/M5 被相似度阈值截断)")
分子网络(GNPS 平台)的核心假设是"碎裂谱相似 → 结构相似",于是标准品的注释能沿着网络边缘"借"给邻近未知峰,得到"lipid class 级"的 Level 3 提升与同类家族的系统发现。它的风险同样是误传:一对糖苷异构体可能谱相似但活性迥异,网络注释永远要回到"结构类似"而非"结构相同"的措辞。
注释工作流的开源工具链在 2020 年后趋于成熟:SIRIUS/CSI:FingerID 做分子式与结构预测、CANOPSIS 组合打分、MS-DIAL 内置谱库批量注释。工具组合的典型分工是 MS-DIAL 出峰表与初筛,SIRIUS 对未注释峰深挖,GNPS 做分子网络家族分析。使用要点是保留每条注释的原始证据(匹配谱图、打分、反向与碎片匹配度四个数值),而不是只留最终名称——半年后数据库更新,可回溯的注释能升级,黑箱注释只能作废。
注释的可信度管理最终要落到项目制度上:实验室应维护一份"注释台账",每个被报告的代谢物记录其等级、证据(谱图、打分)、首次确认日期与标准品库存号。论文返修或数据重分析时,台账决定了哪些名字可以直接引用、哪些需要降级表述。没有台账的实验室在数据库半年更新一次的现实下,旧结论的注释会悄然失效却无人察觉——注释不是一次性劳动,而是需要像菌种库一样持续维护的活资产,这一点与第 8 章的数据管理议题直接相连。
置信层级落到报告里应有明确数字:MSI 四级注释中,Level 1(保留时间与标准品匹配)在典型非靶向研究中往往只占 5%–15%,Level 2(基于 MS/MS 谱库匹配)占 20%–40%,其余大量特征停留在 Level 3–4。与其在论文里笼统写"代谢物经鉴定",不如直接给出各级别数量分布表,并注明谱库(mzCloud、GNPS、MassBank)匹配得分阈值与逆匹配情况——这是审稿人判断注释质量最快的一扇窗口。
注释还要面对"同一特征多个候选"的日常:当同位素加合物(M+H 与 M+Na)与聚集体(二聚体)在同一保留时间出现时,应先行去加合物归并,把同源特征折叠为唯一分子后再查库,否则特征表会被同一代谢物的多个条目稀释。惯例流程是按保留时间聚类(±0.05 min)加质量差匹配(21.98 Da 对应钠加合物)两步折叠,并把折叠映射表随数据发布,保证下游统计的特征计数口径一致。