5.3 统计分析与模式识别
5.3 统计分析与模式识别
代谢组学统计的两条腿:单变量分析(逐特征检验,给 p 值与倍数变化)和多变量分析(把上千特征当成整体找模式)。前者回答"哪些分子变了",后者回答"整体谱能不能区分分组"。最大的风险不是方法不够,而是过拟合。
单变量:多重检验校正
几千个特征各做一次 t 检验,α=0.05 时纯噪声也会冒出上百个"显著"。所以校正是硬要求:
library(limma) fit <- lmFit(expr, model.matrix(~ group + batch)) # 批次作为协变量 fit <- eBayes(fit) res <- topTable(fit, number = Inf) res$padj <- p.adjust(res$P.Value, method = "BH") # FDR 校正 sig <- subset(res, padj < 0.05 & abs(logFC) > 0.5) # 显著 + 效应量双重门槛
p 值门槛之外加 logFC(倍数变化)门槛,是在代谢组学里尤其必要的:高丰度代谢物 1.1 倍变化可以极显著但毫无生物学意义,低丰度代谢物 3 倍变化可能 p 值勉强。两个维度一起看,画出火山图。
多变量:无监督先看,有监督后验
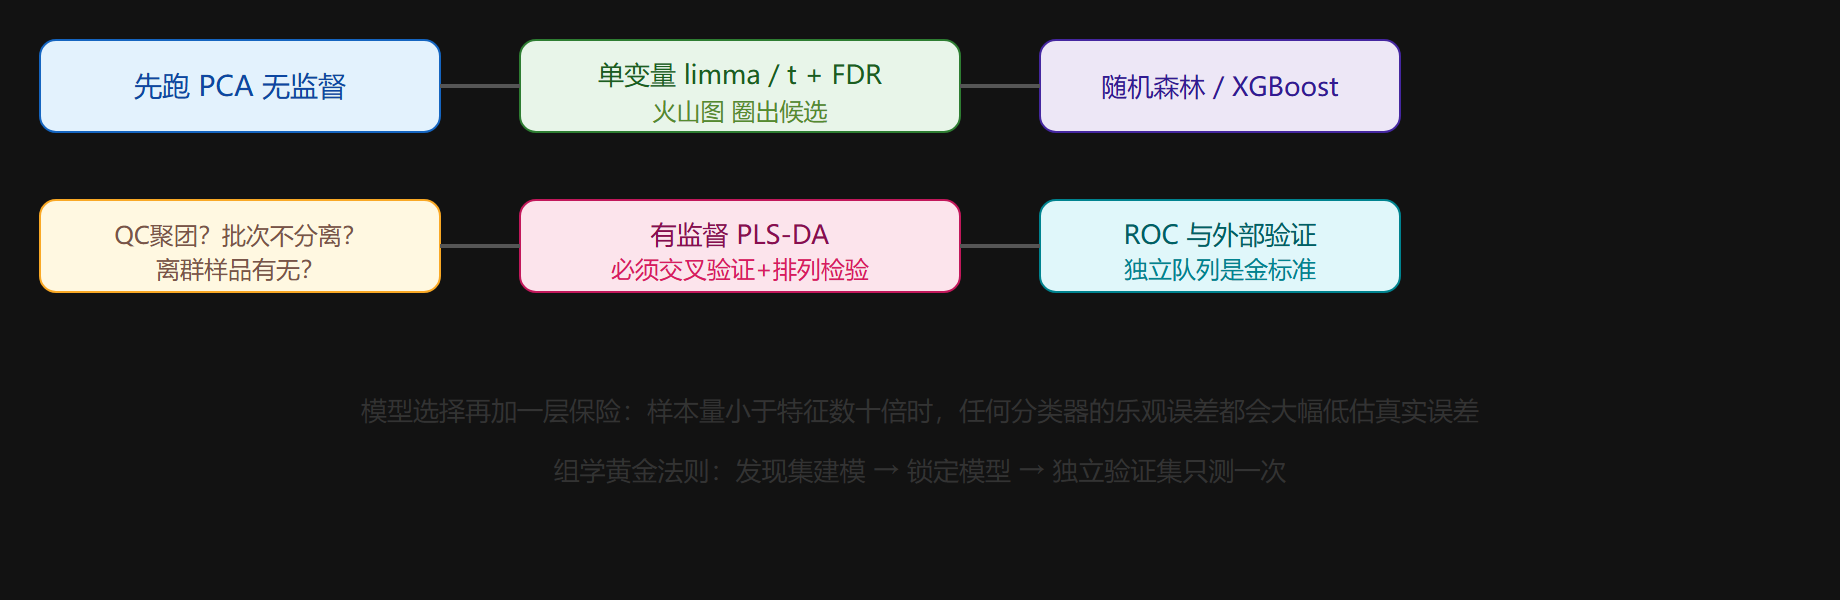
PCA(无监督)第一步永远先做——不是为了找差异,是为了看 QC 是否聚团、批次是否分离、有没有离群样品(见 3.3 节)。PCA 都分不开的组,后面有监督模型的"高精度"多半是假象。
**PLS-DA(有监督)**是代谢组学最常用也最常被滥用的方法。它强迫维度朝分组方向旋转,对纯随机数据也能给出漂亮的分离。唯一的解药是严格的交叉验证纪律:
library(ropls) # 错误示范:全数据拟合后直接报告 R2X/R2Y —— 随机数据也能 R2Y>0.9 # 正确姿势:留一法或分层 5 折交叉验证,报告 Q2 model <- opls(data, group, predI = 2, crossvalI = 7) # 看 Q2(预测能力):Q2 接近甚至超过 0.5 才值得讨论 # 再做 200 次排列检验:随机打乱标签重跑,真模型应显著优于随机分布
统计方法选择决策图
机器学习的位置
随机森林、XGBoost 在特征数远大于样本数的代谢组学上表现好,且自带变量重要性(VIP 的替代品)。但同样逃不过过拟合:嵌套交叉验证(外层评估、内层调参)是最低配置。特征选择必须完全包在交叉验证循环内,否则"信息泄漏"会让 AUC 虚高 0.1 以上。
⚠️ 常见坑三连:①全数据集上选特征再交叉验证(泄漏);②报告训练集精度冒充预测精度;③验证队列与发现队列来自同一天同一批(批次与疾病共线)。每一条都能让论文结论作废。
本节要点回顾
- 单变量:limma/t + BH 校正 + logFC 双门槛,火山图呈现
- PCA 是体检不是分析:QC 聚团、批次、离群三查
- PLS-DA 必须配交叉验证与排列检验,Q2 才是硬指标
- 特征选择包进交叉验证内层,防信息泄漏
- 独立队列验证一次定生死
下一节把差异名单送进通路。
模型选择的过拟合防线
PLS-DA 是代谢组学最常用的判别模型,也最容易过拟合:几十个样本、上千个变量,一个纯噪声数据集也能被 PLS-DA"分类"得漂漂亮亮。防御有三道:置换检验(permutation test,随机打乱标签重跑 200 次,真信号的 Q² 应显著高于置换分布)、交叉验证(LOOCV 或 5 折,报告 Q² 而不只是 R²)、独立验证集(时间或中心上分开的样本)。三道防线里置换检验最便宜也最诚实,任何 PLS-DA 结果没做置换检验都可视为未完成。
| 方法 | 角色 | 关键指标 | 过拟合风险 |
|---|---|---|---|
| PCA | 无监督全景、离群点 | R²X、Hotelling T² | 低 |
| PLS-DA | 有监督分类 | R²Y、Q²、置换检验 | 高 |
| OPLS-DA | 分类加正交过滤 | VIP > 1 的变量 | 高(更易读也更易骗) |
| 随机森林 | 非线性、变量重要性 | OOB 误差 | 中 |
| LASSO/弹性网 | 稀疏特征选择 | λ 的交叉验证 | 中 |
用置换检验给模型"测谎"
import random random.seed(1) # 真实标签的 Q²(来自 5 折交叉验证,示意) q2_real = 0.42 # 置换 200 次的 Q² 分布(均值应接近 0 或为负) perm = [random.gauss(-0.02, 0.06) for _ in range(200)] extreme = sum(1 for q in perm if q >= q2_real) print(f"真实 Q²={q2_real:.2f},置换分布 P(Q²>=真实) = {extreme/200:.3f}") # p<0.05 → 模型捕捉到真信号;若置换 Q² 也常到 0.3+ → 数据里有结构化批次效应
脚本输出的判读要点:置换分布若整体偏高,往往不是"模型好",而是批次或家族结构泄漏了标签——正确的下一步是检查随机化与分层,而非庆祝分类成功。多元统计的每个漂亮图后面都要能回答"这个分离是生物学还是排列顺序"。
单变量与多变量统计的配合是定式而非选择:先用单变量(t 检验/ANOVA 加 BH 校正)列出差异清单,再用 PLS-DA 的 VIP 与随机森林的重要性做第二票,两票皆中的代谢物进入候选——单变量控制假阳性、多变量捕捉组合效应,交集策略比任何单方法都稳。报告时两张图并列为证:火山图(效应量对显著性)与 scores 图(分组分离),缺一即被质疑。
关于样本量与变量数的比例再补一条经验法则:PLS 类模型的稳定样本数应为变量数的数倍以上,或先用单变量与 VIP 把变量预筛到几十个再建模——千余变量配三十样本的建模,无论交叉验证数字多好看都属于高危操作。随机森林对比例更宽容但可解释性弱。真实研究里的稳妥路径是"单变量筛选缩维、多变量建模压缩、独立集验证"三段式,每一段的样本用途预先写进方案,避免"先看数据再挑方法"的选择性偏倚——这与第 3 章的预注册思想一脉相承。
模型性能的汇报也有一条加严版自律:交叉验证混淆矩阵、ROC 曲线与其 95% 置信区间必须来自嵌套交叉验证(外层独立于特征选择与调参),否则准确率会系统性虚高 5%–15%。样本量小于 50 的队列应优先报告置换检验 p 值而非单一的 AUC 数字,因为小样本下 AUC 的抽样波动足以让随机模型偶尔突破 0.8。