6.1 生物医学研究:标志物发现完整复盘
6.1 生物医学研究:标志物发现完整复盘
临床代谢组学的标准剧本是发现-验证两段式:非靶向在小队列捞候选,靶向 MRM 在独立大队列定量验证。本节用一个冠心病研究的完整工作流复盘这条路线,顺带看肿瘤代谢重编程这个当代热点。
复盘:血浆 TMAO 与心血管风险
这是代谢组学史上教科书级的案例,工作流每一步都值得对照本教程前五章。
TMAO 研究工作流全景
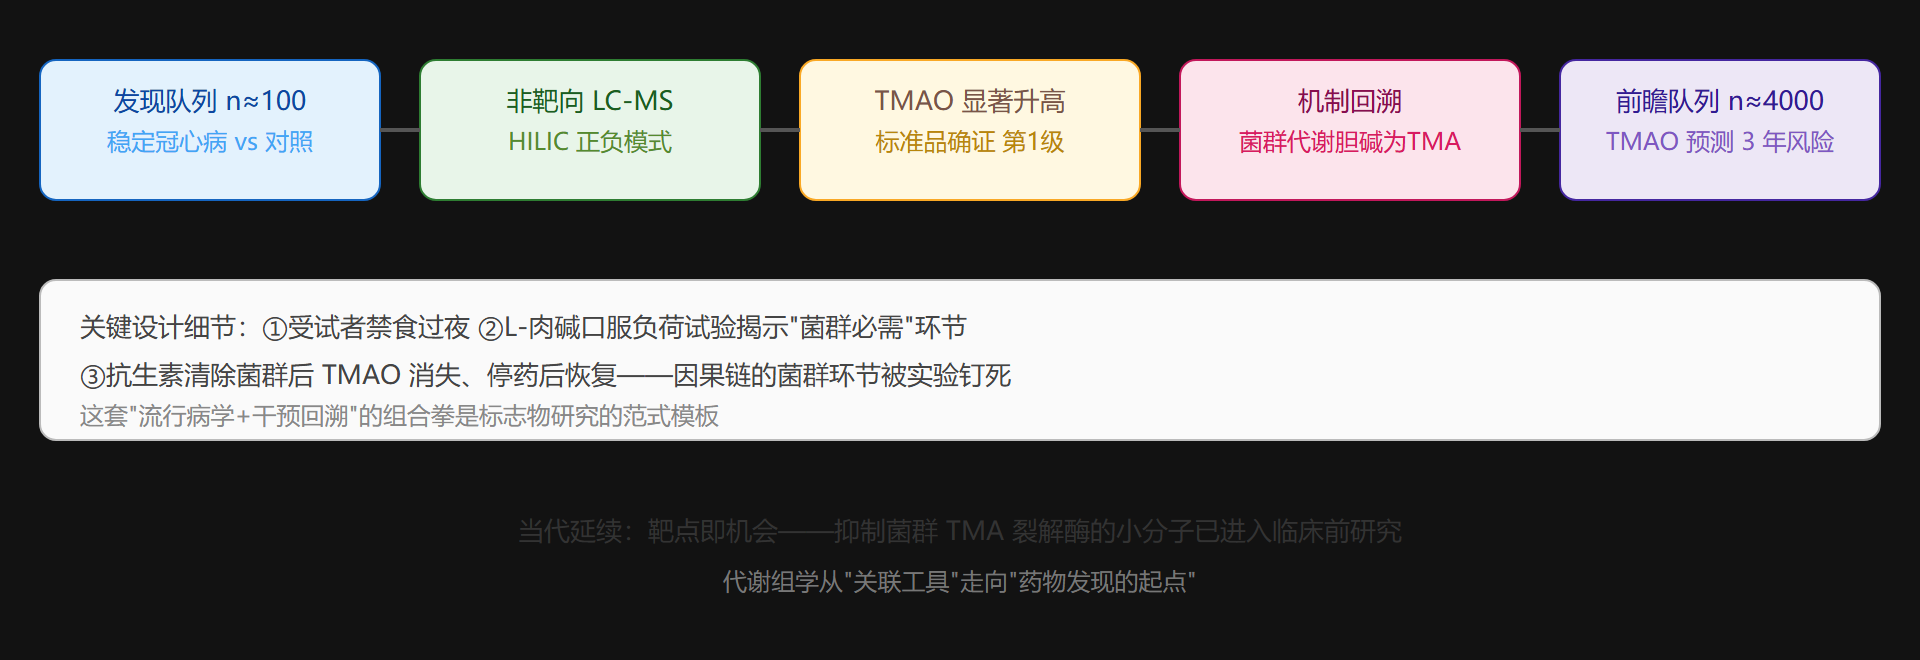
对照前五章逐站检查:发现队列有 QC 与随机化(第 3 章)、HILIC 平台因为 TMAO 强亲水(第 4 章极性谱)、第 1 级标准品确证(第 5.2 节)、前瞻队列独立验证(第 5.3 节)。每一站的设计决定都不是偶然。
另一个主战场:肿瘤代谢重编程
Warburg 效应(肿瘤有氧糖酵解)是百年老问题,代谢组学给它装上了全景镜头。典型研究设计:肿瘤组织 vs 癌旁组织配对取样(3.1 节最推崇的配对设计),速冻淬灭(3.2 节),靶向定量糖酵解与三羧酸循环中间体 + 脂组学,最后落在"某条合成通路依赖"的治疗假设上。IDH 突变胶质瘤的 2-羟基戊二酸(2HG)研究就是金标准案例:突变酶产生致癌代谢物(oncometabolite),2HG 本身成了诊断标志物与药物靶点——代谢物从"相关"走到"因果"的少数实证。
⚠️ 常见坑:把发现队列的 AUC 直接写进摘要当临床性能。没有独立验证的 AUC 只是"模型对自己数据的记忆力",临床转化要求的往往是多中心、前瞻、盲法三重门槛。
本节要点回顾
- 两段式剧本:非靶向发现 + 靶向验证 + 前瞻确认,缺一不可
- TMAO 案例完整示范了从关联到机制(菌群环节)到干预的链条
- 配对组织设计是肿瘤代谢研究的首选
- **oncometabolite(2HG)**证明代谢物可以是因果角色
- 临床性能指标必须来自独立验证,发现队列 AUC 不算数
下一节换到植物与农业。
三个改变领域的回顾性研究
案例一是新生儿代谢筛查:干血斑的 MS/MS 靶向检测将苯丙酮尿症等 30 余种遗传代谢病的诊断从数周缩到 48 小时,是目前代谢组学最大规模的常规临床应用,每年数千万样本。案例二是肿瘤乏氧研究:线粒体代谢重编程(Warburg 效应的代谢组版本)在乳腺癌与胶质瘤样本中表现为乳酸/丙酮酸比值与柠檬酸出口的上调,2-HG 作为 IDH 突变的"oncometabolite"直接改写了胶质瘤分类标准(WHO 2016 分级纳入分子标志)。案例三是心血管风险预测:腰痛患者常规血脂正常但磷脂酰胆碱代谢物 TMAO 轨迹与三年 MACE 事件相关,把"肠道菌群-膳食-心脏"轴连成了可测量的临床变量。
| 案例 | 平台 | 关键代谢物 | 转化状态 |
|---|---|---|---|
| 新生儿筛查 | 靶向 FIA-MS/MS | 苯丙氨酸等 30+ | 全球常规临床 |
| 胶质瘤 IDH 分型 | LC-MS/GC-MS | 2-羟基戊二酸 | WHO 分级标准 |
| 心血管 TMAO | LC-MS/MS | 氧化三甲胺 | 队列风险分层 |
| 肝损伤药物安全 | 非靶向 LC-MS | 胆汁酸谱 | FDA/EMEA 指南参考 |
用 2-HG 的数据看"oncometabolite"如何诊断
# IDH 突变与野生型胶质瘤的 2-HG 浓度(文献典型值,uM,肿瘤提取物) mut = [45, 82, 110, 65, 95, 130, 58] # IDH1/2 突变型 wt = [0.8, 1.5, 1.1, 2.0, 0.9, 1.3, 1.7] # 野生型 import statistics as st print(f"突变型: 中位 {st.median(mut):.0f} uM(范围 {min(mut)}-{max(mut)})") print(f"野生型: 中位 {st.median(wt):.1f} uM") ratio = st.median(mut) / st.median(wt) print(f"倍数差约 {ratio:.0f} 倍 → 阈值 5 uM 即可完美分组,无重叠") # 数量级分离是"诊断性代谢物"的特征:不依赖多变量模型,单指标即临床可用
代码输出的"数量级分离"是案例章最想传递的判据:当一个代谢物在疾病与对照组间相差 10 倍以上且组内变异小,它就从"统计关联"升级为"机制参与或诊断标志"。2-HG 之所以进一步成为机制证据,是因为突变酶的异柠檬酸→2-HG 新催化活性被体外实验证实——浓度异常与酶学异常互为因果链,这是代谢组学发现进入教科书的完整路径。
案例的方法学拆解模板
# 把任意案例拆成可复用的五要素并打印检查 case = {"问题": "IDH 突变状态能否用代谢物无创判别", "设计": "肿瘤组织靶向 LC-MS,突变/野生各 7 例", "关键指标": "2-HG 浓度,阈值 5 uM", "验证": "体外酶学证实突变产生 2-HG + 独立队列复现", "转化": "写入 WHO 2016 胶质瘤分类"} for k, v in case.items(): print(f"[{k}] {v}") # 五要素齐全的案例才值得"抄设计";多数论文只能填前四格
用同一模板拆新生儿筛查(问题:遗传代谢病早诊;验证:干预组结局改善)与 TMAO(问题:心血管风险预测;验证:多中心前瞻队列),会发现三个案例的"验证"环节强度递减——这也解释了它们转化进度的差异。读案例的正确姿势不是记结论,而是给每个案例填这张五要素表。
药物安全评估是医学案例里值得单列的第四条线:监管科学界在 2000 年代就用代谢组学发现药物肝肾毒性的早期代谢指纹, FDA 的某些新药申报指南已接纳代谢组学生物标志物作为安全性评价的支持证据。这条线的行业逻辑与临床诊断不同——它要的不是单个标志物而是"毒理机制的分型证据",因此非靶向加机制解释的组合在毒理领域长盛不衰。对求职与选题的读者,制药工业的代谢组学岗位多在这条线上,读案例时不妨按"诊断、机制、风险预测、安全评估"四格给自己整理一份机会地图。
队列结果的迁移检验同样重要:把模型在一独立队列(不同中心、不同平台)上外测,AUC 从训练集的 0.92 跌到 0.71 是常态而非事故;论文中同时呈现训练与外部验证两组数字,才构成完整的证据链。对生物标志物候选,还应报告其在临床决策阈值处的灵敏度、特异度与漏诊率,让代谢组学结论能被循证框架直接引用。