6.2 植物与农业科学
6.2 植物与农业科学
植物代谢组学有两个人类研究没有的优势:可以做遗传设计的群体(重组自交系)、可以严格控制环境(生长室);也有一个天然的难点——次生代谢的种类比动物多两个数量级(植物估计产生数十万种代谢物)。
与临床场景的三个设计差异
| 维度 | 临床 | 植物 |
|---|---|---|
| 遗传控制 | 人群混杂多 | 近等基因系、双亲本群体可精确拆分基因与环境 |
| 环境控制 | 不可能 | 生长室恒温恒光,可重复 |
| 代谢空间 | 约 3 千种注释 | 数十万种,大部分未知 |
第三个差异直接改变工作流:植物非靶向数据里未知峰占比更高,GC-MS(有 NIST 库)与自建库的地位更重,数据非依赖采集和分子网络(GNPS)几乎是标配。
案例一:番茄风味组学
风味组学研究闭环
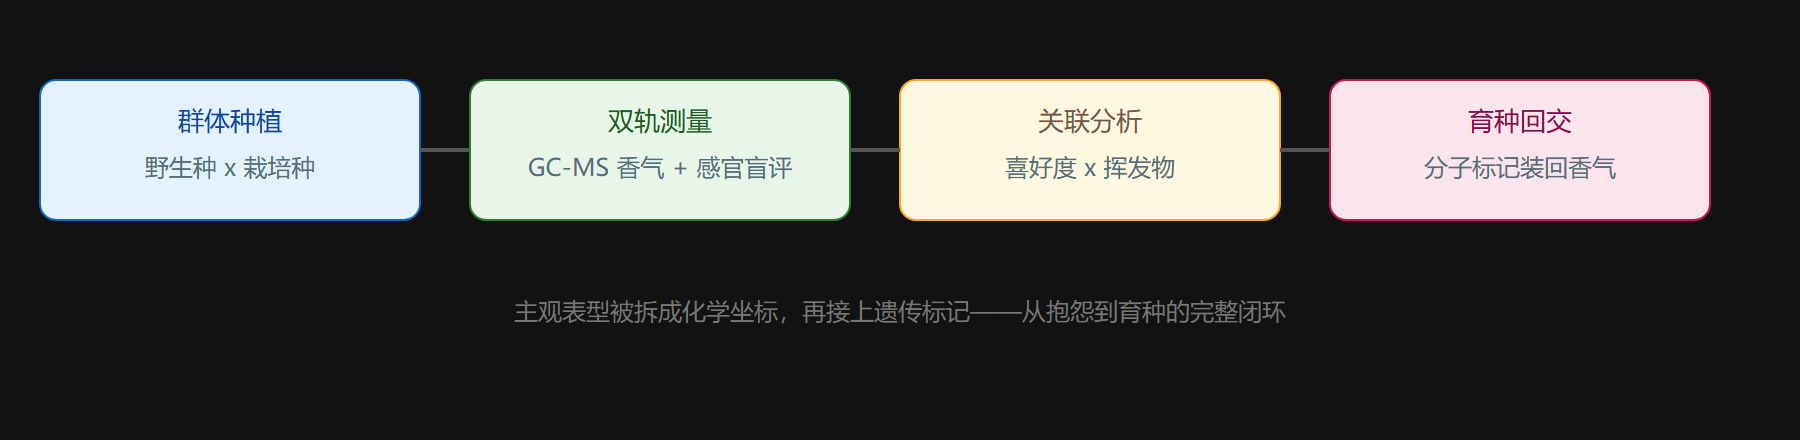
消费者抱怨"现在的番茄没味",代谢组学给出了量化答案。设计要点:一组涵盖野生种与栽培种的番茄群体,检测糖、酸与挥发性香气物质(GC-MS 顶空进样),同时招募人群做感官盲评,把"好吃评分"与代谢物谱做关联——鉴定出几十种与喜好度正相关的挥发性物质,其中数个在商业化育种中已被无意丢掉(育种只选了糖酸可溶性固形物,香气无人问津)。后续通过分子标记辅助回交,把丢失的挥发性物质重新装回栽培种。
这个案例的启发:代谢组学可以把"风味"这种主观表型拆解成化学坐标,再和遗传(mQTL)对接。
案例二:mQTL——代谢物的遗传解剖
把代谢物当数量性状做 QTL 定位(metabolomic QTL, mQTL):
设计:两亲本(高/低某黄酮品系)杂交 → 重组自交系 200 株 测量:每系 LC-MS 代谢谱(数百特征峰)+ 全基因组分子标记 分析:每个代谢物特征做区间作图 输出:控制黄酮含量的主效位点 + 候选结构基因(查该区间内的 苯丙烷通路酶基因)→ 育种可直接用的分子标记
这等于同时给几百个代谢表型画了遗传地图,是关联代谢物到基因最直接的遗传学路径,人类研究做不到这种分辨率。
抗逆与安全两个快速应用
干旱胁迫下作物叶片的渗透调节物质(脯氨酸、甜菜碱)积累动力学,指导抗旱表型评价;真菌毒素(黄曲霉毒素前体)在储粮中的靶向筛查,是食品安全线上真正跑着的代谢组学(免疫亲和柱净化 + LC-MS/MS 定量)。
💡 关键直觉:植物研究的杠杆在于"可控"。能用遗传群体回答的问题就别用混杂人群硬啃——这是实验设计层面降维打击。
本节要点回顾
- 两大优势:遗传群体 + 可控环境;一大难点:代谢空间巨大、未知峰多
- 风味组学示范主观表型的化学拆解与育种闭环
- mQTL 把代谢物变成可定位的遗传性状
- 胁迫与安全是农业上量最快的两个应用
- 设计启示:能控就控,控制本身就是生产力
下一节进入微生物与环境。
从田间表型到分子育种的桥
植物代谢组学的规模化程度常被低估:番茄风味研究对 400 余个品种的糖、酸与挥发性物质做全关联(mGWAS),把"消费者抱怨番茄没味"翻译成了 25 个可育种选择的化学指标;拟南芥与水稻的代谢 QTL 定位把代谢物当数量性状,定位到控制 glucosinolate、氨基酸含量的主效位点。农业应用的另一条线是采后品质:苹果与香蕉的挥发性代谢组在储藏期的轨迹,可以预测货架期并优化气调参数。
| 应用 | 对象 | 代谢组角色 | 实效 |
|---|---|---|---|
| 风味育种 | 番茄 | mGWAS 定位糖酸挥发物 | 商业品种改良 |
| 抗性标记 | 水稻/小麦 | 抗病与次级代谢关联 | 分子标记辅助选择 |
| 采后保鲜 | 果蔬 | 储藏期代谢轨迹 | 货架期预测模型 |
| 真伪鉴别 | 药材/食品 | 代谢指纹 | 地理标志保护 |
代谢指纹做产地鉴别:一个最小分类器
# 绿茶 3 个产地的儿茶素/咖啡因特征(相对峰面积,示意文献量级) data = {"杭州": [[1.00, 0.55, 0.32], [0.95, 0.58, 0.30], [1.05, 0.52, 0.35]], "信阳": [[0.70, 0.80, 0.22], [0.68, 0.82, 0.20], [0.72, 0.78, 0.24]], "峨眉": [[0.85, 0.60, 0.55], [0.88, 0.58, 0.52], [0.83, 0.62, 0.58]]} import statistics as st test = [0.87, 0.61, 0.53] # 盲样 best, dmin = None, 1e9 for site, rows in data.items(): cent = [st.mean(c) for c in zip(*rows)] d = sum((a - b) ** 2 for a, b in zip(test, cent)) ** 0.5 print(f"{site}: 质心距离 {d:.3f}") if d < dmin: best, dmin = site, d print(f"判为 {best}") # 三个特征即完成鉴别:指纹分类不需要全谱,特征选择比仪器精度更关键
植物案例的方法学启示与医学章互补:医学追求单指标的机制深度,植物农业更多用"指纹+分类器"的组合解决真伪、溯源、品质分级等工程问题——两类问题的统计工具完全一致,但特征选择与验证逻辑按行业惯例各走一路。
植物方向的实验设计还有两个独有约束:昼夜与发育阶段的代谢波动幅度远超动物(叶片淀粉含量昼夜可差三倍),采样必须锁定时钟与叶位;次级代谢受诱导(虫咬、病原、UV)显著,温室与田间结果迁移性有限,品种比较必须同地同季。代谢组学在农业的落地形态因此常是"多年多点试验 + 代谢预测模型",与育种周期深度耦合——这是它与医学代谢组学在项目时间尺度上的最大差异。
植物代谢组学还有一个特别的学术贡献值得点出:拟南芥与番茄的代谢组参考图谱为整个领域提供了"模式体系",如同果蝇之于遗传学。模式体系的代谢组文献积累了数十年的方法与数据,新手检验新方法、新算法时优先在模式体系数据上做基准测试,结果可直接与几十篇文献对比。这个传统让植物方向的工具迭代速度反而快于临床方向——许多统计方法(如代谢物-性状关联的线性混合模型)都是先在植物数据成熟后被医学方向借用,学科间的这种流向值得读者留意。