6.3 定量分析与建模
6.3 定量分析与建模
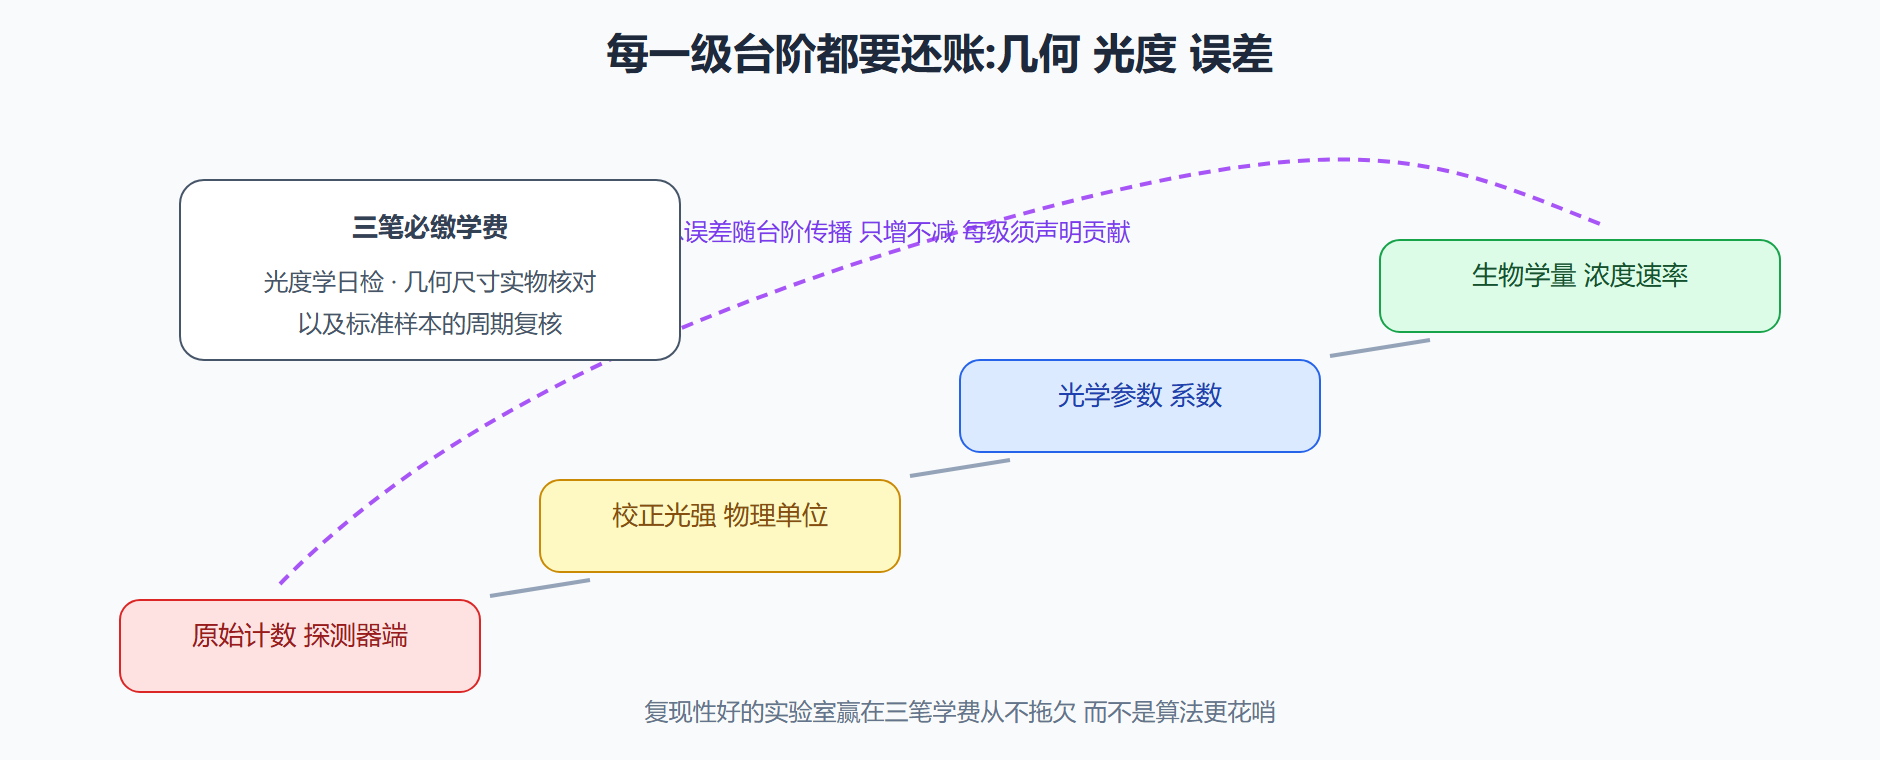
本节摘要:定量的本质是把光信号按物理模型换算回生物学量——浓度、代谢速率、扩散系数。模型不必复杂但要闭合:光度链校准、几何参数实测、误差沿链条传播,三件事缺一环,拟合再漂亮也只是自说自话。
本节是流水线终点站,也是全书"光子穿行记"里光子交出答卷的时刻。读完你应当能独立完成一次带不确定度评估的光学定量,并判断一篇论文的数字是否值得采信。
直接定义开场
很多综述绕圈子,不如开门见山:定量光学是"用已知物理过程反解未知样品参数"的反演实践。它包含三个必备件:一个把参数映射到可观测量的正向模型、一组经过校准的观测数据、一个显式的误差传播方案。三者齐备叫测量;只画曲线不报区间叫插画。
核心机理:从两个最常用模型说起
比尔-朗伯拟合:透射或反射测量里,吸光度与浓度在低浓度区线性相关。操作要点全在校准侧——参比通道必须与信号通道同步采集以扣光源漂移;工作曲线要用基质匹配的标准品横跨待测区间;超出线性段的读数一律稀释重测而不是外推。
传输模型与蒙特卡洛:当样品厚到散射主导,简单的指数衰减不再成立,需要漫射近似或直接模拟成千上万粒光子的随机行走来预测出射分布。逆向调用时,蒙特卡洛成为组织光学参数(吸收系数、约化散射系数)回收的主力工具。它的方差随粒子数下降缓慢,实用中要配合多层加速结构。
动力学室模型:追踪荧光示踪剂时,把生物系统抽象为若干房室及其交换速率常数,利用时间序列拟合速率——葡萄糖摄取、药物蓄积都走这条路。室模型的威力和风险都在简化假设上:房室划分错了,数据拟得再好也只是在为错误的模型背书。
图 6-3 从光强到生物学量的换算阶梯
一段完整的不确定度核算
下面的脚本完成一次小型定量闭环:合成一套吸收率-浓度数据,用最小二乘拟合工作曲线,同时输出斜率的置信区间:
import numpy as np from scipy import stats conc = np.array([0.0, 5, 10, 20, 40]) # 标准系列浓度 absb = np.array([0.002, 0.09, 0.17, 0.35, 0.71]) # 实测吸光度 含随机噪声样例 reg = stats.linregress(conc, absb) print("斜率", reg.slope, "截距", reg.intercept) # 斜率的百分之九十五置信带 决定了未知样的浓度误差下限 ci = reg.stderr * stats.t.ppf(0.975, len(conc) - 2) print("斜率置信半宽", ci) unknown = (0.44 - reg.intercept) / reg.slope # 反解一个未知样品 lo = unknown - ci / reg.slope # 近似下界 演示用 hi = unknown + ci / reg.slope print(f"样品浓度 约 {unknown:.1f} 区间 [{lo:.1f}, {hi:.1f}]")
注意这个演示刻意停在了线性世界;真实生物基质中的回收率实验(加标回收)会把矩阵效应再叠上一层修正——两者的差别就是"化学教科书数据"与"临床可报告数据"的距离。
完整案例:一次团队级的蒙特卡洛验证作业
背景:课题组计划开展小鼠颅内荧光分子层析,需要预先知道给定几何下的深度分辨能力,采购决策悬而未决。操作分四步。第一步建正向场景:两厘米直径圆柱模拟鼠脑,边界条件设为折射率匹配,内部放置不同深度的各向同性点源。第二步跑对偶仿真:自主实现的粒子行走器与开源工具箱各跑一千万粒子,交叉核对出射面通量分布差异小于百分之二——这一步看似多余,实为防止自家实现暗藏系统性缺陷的最便宜保险。第三步反向试探:在表面亮度数据中加入百分之五的高斯噪声做数据合成,考察重建算法对不同深度源的定位偏差,结论是在四毫米以浅误差可控、超过六毫米后深度维度坍缩不可用。第四步把仿真结论翻译成采购条款:激光功率与探测器灵敏度按目标深度上限留两倍余量。结果层面,设备选型避免了"指标看起来很强但深度不够用"的经典错配,试运行实测与仿真的偏差落在预期带内。解读端的元方法有三层:对偶仿真防实现错误、合成数据隔离算法问题、参数敏感度分析决定采购冗余——三件套可以整体迁移到任何数值实验设计。变式方向是把同一框架用于光声成像的前期可行性论证,只是正向算子换成声学传播,纪律完全一致。
工程实践要点
- 先报模型再报数字:任何定量结果描述里应能找到所用模型、假设与失效条件的出处;
- 误差传播要显式:至少给出主要变量的一阶敏感度,让读者看到区间是怎么长出来的;
- 定量比较同日内完成:跨天的光度漂移是组间差别的头号伪装者;
- 负结果也要归档:模型在某类样品上失准的记录,常常是下一轮改进的路标。
⚠️ 常见坑:拿仿真精度冒充测量精度——正演收敛得好不代表反向问题病态性已被治愈。
💡 关键直觉:定量学的尊严来自误差棒,不是拟合优度;一条有区间的水平线胜过十条没有误差的金色曲线。
敏感度分析的实操模板
第一次做误差传播时,最容易迷路的是不知从哪个变量下手。一个通行的实操排序是按不确定度乘敏感度给变量排队:列出模型全部输入参数,给每个参数填上两项打分——它的相对不确定度(由标定记录或经验给出)与输出的相对敏感度(用扰动百分之十重跑正模型的办法测得)。两项相乘得到贡献分数,从大到小排成一列,前两三名通常占据总误差的八成以上,这就是你下一步投入标定精力的地图。
这套模板的价值在于把有限的标定预算投向回报最大的地方。举例来说,在某荧光分子层析项目里,分析显示光源功率的不确定度贡献排名第一,而此前团队一直把精力投在探测器增益的季度标定上;把日程调整后,整体组间变异几乎减半,设备与人力却没有增加一分。这就是本章反复强调的观念的具体化身:**数据质量是管理出来的,不是买来的。**如果你只想从这一节带走一件工具,就带走这张表——它可以无缝迁移到你未来接触的任何成像模态。
本节要点回顾
- 定量=正向模型+校准数据+误差传播,缺项即退化为插图艺术;
- 线性区内的简单拟合优先于复杂黑箱,只要光度链闭合;
- 蒙特卡洛的价值在于让不可解析的正向过程开口说话;
- 数值实验的三件套纪律可直接复制到其他成像模态。
数据分析章至此收官。最后一章我们把视线抬到地平线上:前沿在哪里、生态靠什么维持、瓶颈还剩几座。