4.1 分布式系统基础
4.1 分布式系统基础
本节摘要:金融级分布式系统的全部纠结,可以浓缩成一道选择题——分区发生时,要可用还是要一致?支付领域的答案是分场景作答:指令受理选可用,账务落地选一致,中间靠幂等与对账把两者缝起来。本节讲清 CAP 的工程化表达、最终一致的实现件(消息队列加补偿)、幂等三道防线,并用一次凌晨扩容复盘把这些概念全部落到人身上。
第 3 章反复出现的"掉单""重复投递",根源都埋在这一节。看懂它,你才能理解为什么支付架构师嘴里总挂着"最终一致"四个字。
先问立场:CAP 在支付里怎么落
同一份数据在两台机器上,网络断开的瞬间只能二选一:继续服务但可能各说各话(保可用),或者停下来等待重连(保一致)。教科书把它画成三角形选择,工程师的日常则是给每类操作分配立场:
| 操作类别 | 一致性立场 | 理由 |
|---|---|---|
| 支付指令受理 | 偏可用 | 拒收的用户体验损失立竿见影 |
| 账务记转 | 强一致 | 差一分钱都是事故 |
| 营销活动计数 | 宽松最终一致 | 晚几秒无伤大雅 |
| 风控名单同步 | 近实时最终一致 | 秒级窗口可接受,需监控延迟 |
立场不同决定了实现路线不同。强一致走数据库事务加分布式锁;最终一致则依赖一个不起眼却扛住一切的主力部件——消息队列。
最终一致的施工图:消息、重试、补偿
一笔支付成功的通知要扇出到库存、积分、发票、风控四个下游。做法是把通知封装成消息发进队列,下游各自消费、各自记账;消费失败自动重试,超过次数转入死信队列人工处理;极端情况下下游主动反查上游做补偿。这套组合的隐含承诺只有一句话:消息可能迟到,但不缺席。3.2 节的对账文件就是这句承诺的日终兜底凭证。
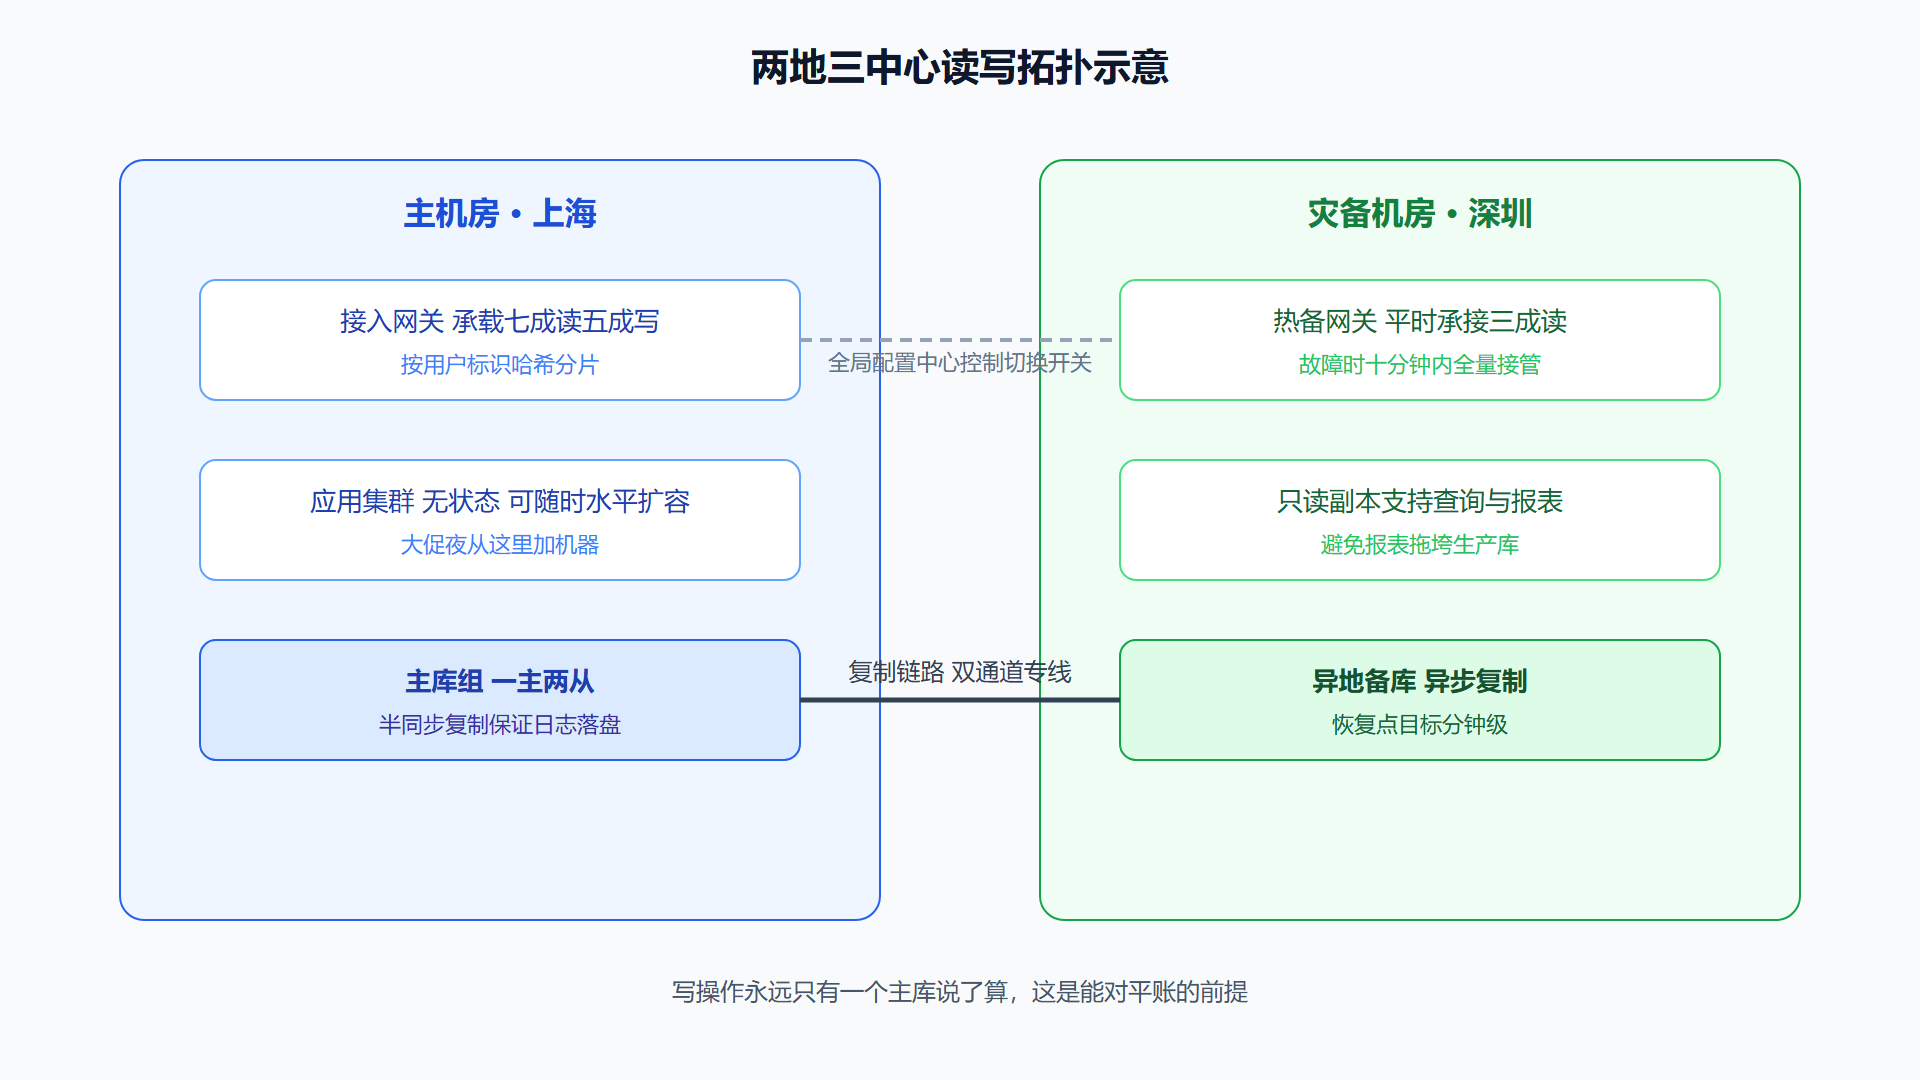
图 4-1 双活机房拓扑与流量切分
幂等的三道防线
请求重复到达不可避免,防御讲究纵深:
第一道 应用层缓存挡箭牌 以渠道单号为键设置短周期处理标记 同键请求在窗口内直接返回首次结果 第二道 数据库唯一索引终审 插入流水行携带唯一约束 冲突即回滚并改走查询路径 第三道 资金层余额勾兑 日终以账户视角复核当日借贷双方总额 与流水汇总强制相等
三道防线的哲学差异值得体会:前两道拒绝重复执行,第三道不阻止任何事,只在事后宣布谁出了错。成熟的系统三者都要,因为防御本身也会出 bug。
案例全程复盘:一场零点抢购的扩容之夜
背景。年度会员日活动定在零点开抢,历史峰值每秒八千笔支付,预估当天翻倍。容量清单(见 3.3)推算后给出方案:应用节点从四十台扩到九十台,数据库读实例临时加挂两组,第三方备用通道预热压测。
操作。当晚的时间线被值班群里的每一条消息记录着:
23 时 40 分 流量镜像对比 主备配置 diff 为空 放量许可签发 23 时 58 分 灰度比例调至百分之十 观察核心指标曲线平稳 00 时 00 分 全量放开 订单创建峰值冲到 每秒一万六千笔 00 时 03 分 写入队列积压告警 消费组即刻从二十四组升至四十组 00 时 07 分 两笔长尾慢查询被定位 新营销表的联合查询未走索引 现场补建 00 时 15 分 成功率回到基线以上 积压清零 02 时 30 分 缩容回收 保留百分之二十冗余过周末
结果。当晚成功率为历届最高的一次活动,而真正被写进事后报告的不是成绩单,是那份 diff 检查表与慢查询应急预案——它们从"文档"变成了"肌肉记忆"。
解读。这次扩容有两条普适经验。其一,水平扩容的前提是应用彻底无状态——会话与本地缓存必须外置,否则加机器等于分裂。其二,队列是泄洪区不是遮羞布:积压要盯"消化速率差"而不是绝对条数,速率差持续为正就说明消费能力已经顶到天花板,早预案比晚补救便宜十倍。
变式。单元化改造是这个思路的终点形态:把用户按维度切进多个完全自包含的单元,每个单元五脏俱全,跨单元调用归零。付出的是数据迁移的巨大复杂度,换来的是任意单元故障都不外溢——大型平台的演进几乎殊途同归。
三个高频追问:锁、时钟与灰度的边界
分布式锁到底可靠吗。可靠的锁只有带租约与看门狗续期的实现,外加对"锁过期但业务没执行完"场景的防护 fencing 令牌——用一个单调递增的编号让过期的旧持有者写不进存储。面试里背"Redis 锁加数据库锁兜底"不算答案,能讲清 fenced write 的原理才算入门。支付系统里所有资金相关的互斥,最终都要落到存储层的原子性上,进程内的记忆是不可信的。
服务器时钟会撒谎。NTP 校准过的机器之间仍可能有几十到几百毫秒的偏差,而这套偏差足以让"先来后到"的判定翻车:验签里的时间戳窗口、限流计数器的窗口切分、活动开抢的截止判断,全都依赖时钟。工程上的对策是尽量用单调钟测时长、用单一仲裁服务定先后、把时间窗口放宽到最大时钟漂移之上。凡是逻辑依赖"两台机器对时间的一致看法",设计文档里就该有一行备注承认这个假设的脆弱。
消息会乱序吗。会,而且账务场景对顺序极其敏感:同一笔订单的事件序列是下单、支付成功、发起退款,若退款通知先于支付成功被消费,状态机要么拒绝处理(好在是安全的拒绝),要么更糟——把余额方向算反。队列本身通常只保证单分区内的先后,跨分区的扇出消费没有任何全局顺序承诺。工程对策有三层:其一,按订单号做路由键,让同一笔业务的事件落在同一个队列分区里天然保序;其二,给每条消息带版本号或时间戳,消费端发现旧事件直接丢弃并记录跳过流水;其三,也是兜底的一层,下游状态机要写成只允许合法迁移(已支付才能退款、已退款不能再发货),收到不认识的状态就挂起进人工核对。这三层恰好对应三种错误哲学:预防、检测、止损。日终对账时那些"状态跳变"记录就是第二三层防线的战果清单——数量突然抬头,说明上游的发布改坏了什么。
灰度到百分之多少才敢全量。没有标准答案,但有标准流程:每次放量前确认三类信号齐平——错误率的形状(不是数值而是形态)、关键路径耗时的分位、下游队列的积压趋势。信号形状有差异就停在当前比例做归因,宁可多停一小时。放量节奏表要预先写在发布单里,禁止现场凭感觉拍数字,这是 3.1 节开关温度原则在部署侧的同款纪律。
补一个连接业务视角的观察:技术同学常抱怨金融系统的架构约束太多、创新太慢,但从本节的分析看,那些约束几乎每一条都对应着某类资金的不可逆操作——指令可以重发,钱不能回滚。理解了不可逆性,才算真正接住了这个行业的架构审美。
本节要点回顾
- CAP 是分配题不是选择题:按操作类型逐个表态;
- 最终一致的三件套:消息队列、重试与死信、补偿反查;
- 幂等三道防线各有哲学:拒重复、终审拦、事后查;
- 双活的纪律写在细节里:diff 为空才放量,写操作单一主库;
- 扩容夜的胜负手在演练密度而不在机器数量。
数据这条河从此源源不断地流起来。下一节看这些水怎么变成决策。