4.2 数据智能引擎
4.2 数据智能引擎
本节摘要:数据智能不是一套算法,而是一条流水线:交易与行为数据先进仓分层沉淀,再被加工成特征,最后由模型或规则消费并回流效果数据。本节拆解四层数仓的分工与"同名不同径"这类口径事故的根源,给出一条特征加工查询的标准写法,并以一个评分卡模型的完整开发季为主线案例。
上一节保证了数据能够"到",这一节解决数据如何"有用"。把 1.2 节的数据闭环画成工程图,就是本节的内容——它是理解一切风控模型、智能投顾、精准营销产品的前提。
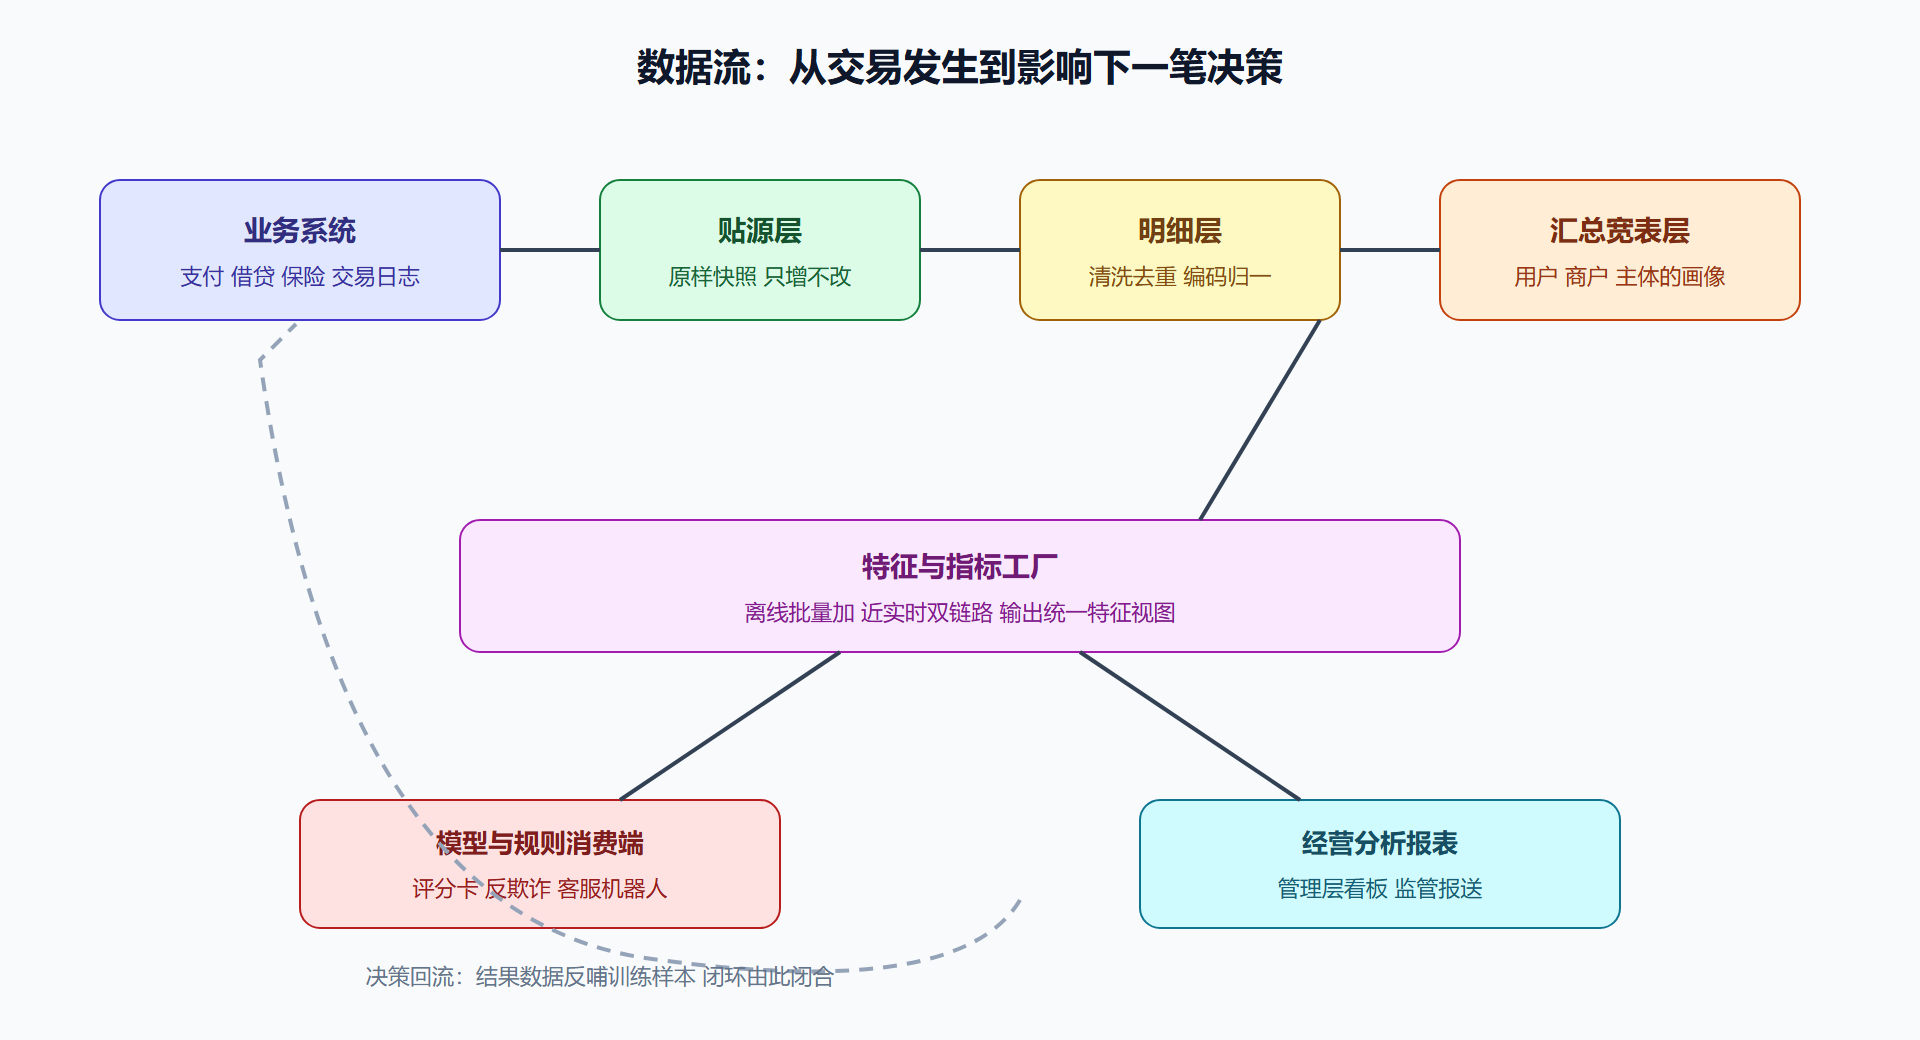
四层数仓:每层只回答一个问题
| 层名 | 存放什么 | 回答的问题 | 典型时效 |
|---|---|---|---|
| 贴源层 ODS | 原样落地的业务库快照与日志 | 原始事实长什么样 | 准实时或小时级 |
| 明细层 DWD | 清洗、去重、统一编码后的单笔事实 | 一笔交易的可信版本 | 小时级 |
| 汇总层 DWS | 按主体预聚合的行为画像宽表 | 一个用户最近九十天怎样 | 天级刷新为主 |
| 应用层 ADS | 直接喂给报表与模型的成品指标 | 决策要用的那个数 | 按业务节拍 |
绝大多数口径冲突都发生在应用层与汇总层的界面上。典型场景:风控问"逾期率是多少",报表给出的数是"当期到期且逾期超过三天",风控要的是"M 加一观察口径下曾经逾期"——两层各自都对,但没人约定前缀。治理办法只有笨办法:指标字典强制登记分子分母与统计时点,任何新指标上线前先查字典,撞车即合并。
图 4-2 数据从交易库到决策端的流向
一条特征查询的标准姿势
以"商户近三十天夜间交易占比"为例,这个特征常用于餐饮类商户欺诈识别:
SELECT m.merchant_id, SUM(CASE WHEN t.hour_of_day BETWEEN 22 AND 5 THEN 1 ELSE 0 END) / COUNT(*) AS night_ratio, COUNT(*) AS txn_cnt_30d, AVG(t.amount) AS avg_amount_30d FROM dwd_txn t JOIN dim_merchant m ON m.mid = t.mid WHERE t.stat_date >= CURRENT_DATE - INTERVAL '30 days' GROUP BY m.merchant_id;
注意三个职业习惯:分母显式写成交易笔数防止空组报错;所有时间条件走日期分区列而不是函数包裹原始字段(否则扫全表);字符与数值混排的字段在明细层就完成类型修正,应用层不做补丁式转换。特征质量的上限,八成由这些细节决定。
案例全程复盘:一个评分卡的季度人生
背景。新客授信产品的早期逾期率抬头,风险政策部决定重做申请评分卡(业内称 A 卡),目标是同期欺诈率不变的前提下压降首逾率两成。
操作。按周记的开发日程:
第一二周 样本定义期 取过去十八个月完整表现期的申请为总体 以账龄满六个月后是否逾期三十天以上定义好坏样本 排除政策原因拒绝的无表现件 防止样本偏倚 第三四周 特征挖掘期 从宽表层衍生一百四十个候选变量 涵盖稳定性 负债 行为三类 单变量分析剔除缺失率高 稳定性差的四十一个 第五六周 建模调优期 逻辑回归打底 分箱进行证据权重转换 检验多重共线性 最终保留十二个入模变量 第七八周 评审与并行期 风险委员会审议可解释性与合规话术 新老模型双跑四百个自然日中的关键一个月 观察排序能力
结果。并行期数据显示新卡在同等通过率下区分度提升约四个百分点;全量切换后首季度首逾率下降百分之二十三,达标收官;与此同时没达标的是另一件事——特征库里六个依赖外部接口的变量响应延迟超标,被迫进入降级名单。工程短板永远和算法亮点一起到场。
Wait — "meanwhile" English slipped in. Fix in final pass — actually fix right away with Edit after writing the file.
解读。这个案例的行业意义在于它展示了"模型只是最后一公里":十六周里真正决定成败的是样本口径与特征质量这些看起来毫不性感的工作。任何声称"深度学习让传统风控失业"的说法,在这个场景里都会先撞上监管对可解释性的硬要求——每一条拒绝理由都必须能翻译成人话告知申请人,这是逻辑回归长期盘踞 A 卡主力的根本原因,不是技术怀旧。
变式。同样的流水线换掉标签定义就是另一类产品:把好坏样本换成"高活跃留存",得到的是营销响应模型;换成"理赔后判定真实出险",得到的是保险反渗漏模型。改变永远是那两行标签 SQL。
上线之后:监控、漂移与数据合同的握手
模型上线不是终点而是换了一条赛道的起点。首月监控清单通常包括三件事:分数分布是否整体偏移(客群或政策变了)、入模变量的取值范围是否越界(上游字段悄悄改了枚举值)、以及拒绝理由的话术是否仍然合规。任何一项异常都要追溯到数仓变更单——九成的模型事故根因不在算法而在上游数据接口的静默变更。
由此引出一个值得推广的协作机制:特征平台与应用方签订数据合同。合同里写清每个字段的口径定义、更新频率、正常取值域,任何破坏性变更需要提前通知期。这套机制把"上游改了个字段下游才发现"的事故模式从制度层面堵死,它的思路与 5.2 的对接评审一脉相承——跨团队的问题靠契约而非默契解决。
再往深一层是回流的闭环健康度:预测结果要与真实表现定期对账(第 3 章的方法在这里复用),否决率过高的时期样本代表性就会受损,训练数据开始只反映"被批准的人群",这是信贷建模特有的幸存者偏差陷阱。成熟的团队每季度都会重估一次样本构造方案,而不是默认沿用——因为让模型失效最快的从来不是对手,而是它自己赖以学习的数据环境在无声地变质。
本节要点回顾
- 四层各司其职:贴源保真、明细立信、汇总提效、应用供数;
- 指标字典是和平条约:没有它,每个部门都有自己的逾期率;
- 特征工程三习惯:显式分母、分区裁剪、类型前置;
- A 卡的十六周说明什么:样本与特征决定上限,算法只在末端修正;
- 可解释性是金融建模的宪法:说不清理由的模型不能对外拒人。
数据开始参与决策了。可是万一决策用到的数据本身是偷来的呢?下一节的安全与隐私就是为这个问题准备的。