7.3 人工智能深度应用
7.3 人工智能深度应用
本节摘要:大模型进入金融业后,各环节的受益程度严重不均:审核与客服先跑通,投研与营销处于人机协同的半自动期,而授信决策这类强监管领域仍被可解释性锁死在传统架构上。本节给出一张应用成熟度矩阵,用一次三个月的真实对照实验评估智能客服的实际收益,最后把可持续发展的三维框架并进来,作为评估一切前沿投入的通用标尺。
前两节的变局都在钱的形态上,这一节的变局发生在组织能力里。判断它是否"深"用的不是模型参数量,而是该环节的责任结构是否被重写。
成熟度矩阵:哪里已落地,哪里还在等
| 应用域 | 自动化程度 | 主要约束 | 现实定位 |
|---|---|---|---|
| 智能客服与话术辅助 | 高,可独立承接常见问答 | 幻觉引发误导性表述的风险 | 已规模部署,人只管升级件 |
| 单证审核与材料初筛 | 高,效率提升立竿见影 | 边角样本的误判复核成本 | 人机双签,机器过一遍人定终审 |
| 营销内容生成 | 中高,产能爆炸 | 合规话术审查成为新瓶颈 | 量产加抽检,模板库托底 |
| 投研信息整理 | 中,摘要与预警可用 | 数据时效、观点责任归属 | 辅助阅读器而非分析师 |
| 授信与理赔决策 | 低,试点为主 | 可解释性硬要求、算法备案压力 | 决策权仍在规则与传统评分 |
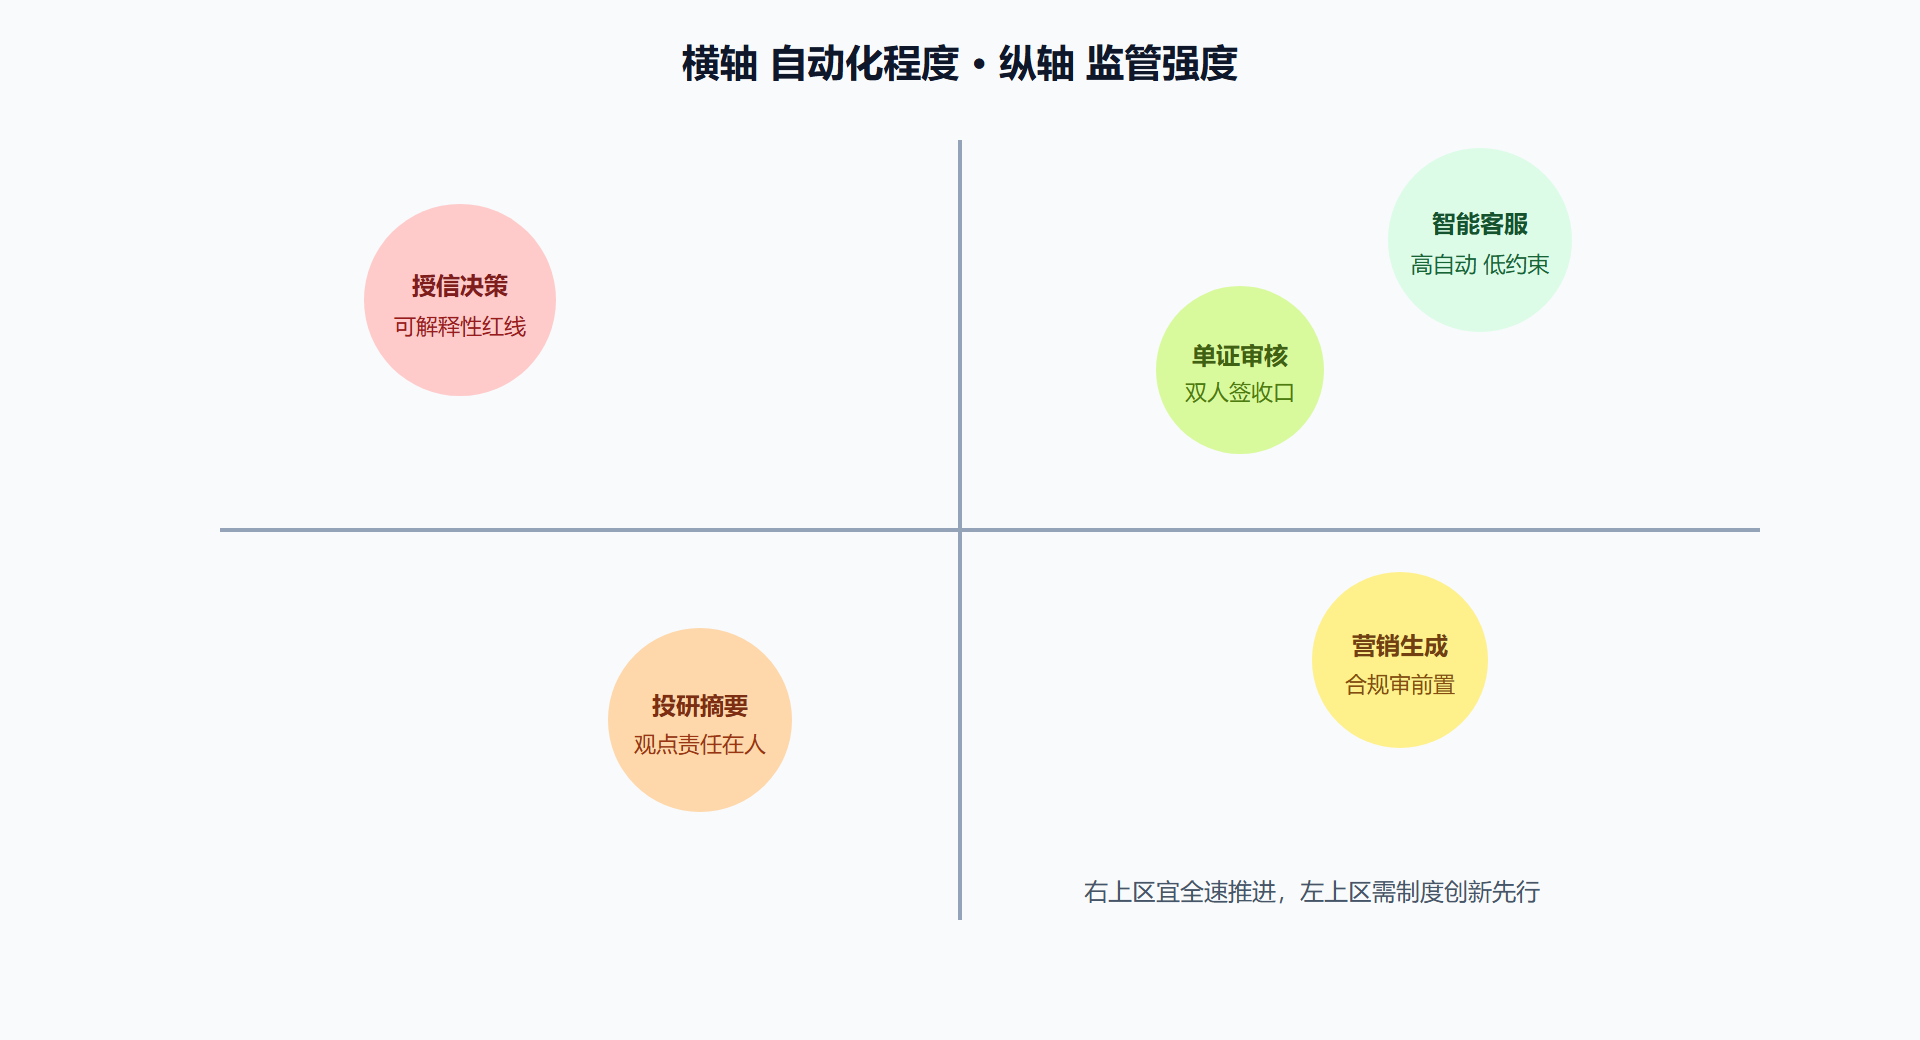
矩阵的读法:越靠上的是"写东西"的任务,越靠下的是"做决定"的任务。写错了可以撤回,决定错了要承担后果——金融业的注意力天然被后果吸引,这就是决策类应用推进缓慢的根本原因,与技术强弱无关。
图 7-3 应用纵深分布与责任边界
工程实践要点:幻觉在金融语境的特殊毒性
通用场景里,模型的胡编乱造顶多损失一点可信度;金融语境里一句编造的收益率承诺就是合规事故。生产环境的三道闸门:
第一道 知识限界 业务问答强制走检索增强 只允许基于指定知识库作答 检索无命中时输出的不是发挥而是 转人工 第二道 结构化输出 涉及数字与期限的话术由模板拼装 模型只负责自然语言包装层 关键字段与来源逐条回链 校验通过才允许下发 第三道 抽检闭环 上线语料按风险分级抽样复检 复检员不知情 发现问题的批次回溯训练样本 并计入供应商考核
三道闸门的共同哲学是给模型的输出降级:它可以写得漂亮,但不许"发明事实"。
案例全程复盘:智能客服的三个月对照实验
背景。某消费金融公司的还款咨询线长期超载,高峰接通率不足七成。产品与数据团队争取到一次严谨的 A/B 实验:一半进线流量由新一代对话系统首问承接,另一半维持原坐席模式,全程九十天。
操作。实验设计里最值钱的是这三个决定:
分组方式 以请求尾号随机分流 避免运营人员挑流量的人为偏置 口径统一 两组共用同一知识库 同一套免责标准 服务用语同源 成功定义 不以机器人解决率为唯一指标 同时追踪 七日内重复来电率 与投诉转化率
结果。九十天后揭盲:实验组首问自助完成率百分之六十八,高于对照组坐席的一次性解决率;重复来电率相当;投诉率略低但差异不显著——额外发现是夜间时段(二十二点至次日六点)的自助完成率比白天高出十一个百分点,说明该系统的比较优势主要在人力真空期。
解读。这次实验把一个常被夸大的命题还原成了它的真实形状:智能客服没有替代人工,而是重新划分了时段与问题类型的分工。它的经济学本质是把最贵的资源(有经验的人工)从高频简单事务中解放出来,同时暴露出新成本——知识库维护从季度更新变成了每周迭代。
变式。同一套实验纪律适用于所有 AI 投入的验收:随机分流、口径对齐、复合指标、揭盲周期预先锁定。凡是拿不了这几条出来的立项汇报,都默认按演示项目处理。
用回本册的方法:让模型给长短款当分诊台
三道闸门与实验纪律若只停在客服场景,就浪费了这一章。把它们搬回全册主调的主场——对账差错处置——做一个克制的试点设计:
痛点 某平台日均对账差异三百余笔 人工逐笔翻双侧行记录 初筛占用两人整天 方案 只做分诊 不做裁决 模型读取差异单关联的双方流水片段与订单上下文 按预定义标签集输出初步归因 回调迟到 聚合通道延迟截断 手工冲正冲突 尾差口径 每条附置信度 高于阈值的直接排班 低置信度照旧人工优先 红线 差异记录一律不得自动核销 归因仅供参考 所有最终定性必须人工点击确认并保留机器建议原文以供复盘
跑了两个月的抽样结论值得细品:初筛工时下降约六成,分诊准确率稳定后维持在九成五上下;更隐蔽的收益是归因标签沉淀成了结构化台账,季度复盘第一次可以直接统计差错成因的分布占比——呼应 3.3 那张饼图的数据从此有了自动化产线。
为什么坚持"不自动核销"?不是技术做不到,而是责任结构不允许。对账的核心职能之一是把"钱怎么动的"变成可以被审计追问的事实序列,这个职能天然要求每个终态都有一位签字的人。让模型写摘要,让人签名字——这条分工线划在哪里,比模型的准确率更能决定这类项目能走多远。它也是成熟度矩阵最下一行迟迟不肯松口的微观原因。
并入一维思考:可持续的三把尺
前沿项目最终要过"可持续"这一关,它由三个维度构成,缺一即伪:
- 成本维度:算力与数据的边际投入是否随规模下降。大模型的推理成本曲线正在快速下行,这让许多两年前不成立的应用今明两年成立;
- 风险维度:新工具是否只是在转移风险而不是消灭它。把柜面差错换成模型歧视,总账未必改善;
- 普惠维度:服务半径是否真的扩大。若一项技术只让高净值客户更便捷而对长尾无感,它只是体验升级,不是金融深化。
三个维度可以压缩成审计每个前沿立项的一句话:它让谁的成本降了、把什么风险藏到了哪里、又把多远的人群圈进了服务半径。
本节要点回顾
- 成熟度按"写或决"分层:写作类先行,决策类被可解释性卡位;
- 幻觉在金融语境必须结构性防御:限界、结构化、抽检三道闸;
- A/B 实验四纪律是甄别真价值的试纸;
- AI 的真实经济账是分工重构:解放贵的,养活便宜的,加重知识库的;
- 可持续三把尺:成本、风险、普惠,立项答辩就答这三题。
业态、技术、风控、红线、前沿都已铺陈完毕。下一章收拢成实战:生态怎么协作,产品怎么做,标杆怎么学。