4.3 自动化检测体系:终端遥测、EDR 与 SIEM
4.3 自动化检测体系:终端遥测、EDR 与 SIEM
本节摘要:当资产规模突破千台,检测就不再是一个引擎问题,而是一个数据工程问题。这一节的主角是把全网变成可查询数据库的三件套:装在每台主机上的遥测探针、负责实时判读与干预的终端检测响应平台,以及汇聚全企业日志做关联分析的安全信息事件平台。它们的组合让"一次入侵触发全网免疫反应"从口号变成工程事实。
学习目标
读完本节,你应当能够:
- 画出遥测数据从主机到分析师屏幕的完整管道并标注各环节职责;
- 说清 EDR 与 SIEM 的分工边界——谁管单机深查,谁管全网关联;
- 写出一条结构化的关联告警规则的思路稿;
- 理解响应自动化的适用边界:哪些动作适合机器代劳,哪些必须留给人。
一、问题与直觉:一个管理员如何盯住一万台电脑
传统杀毒是"哑终端"模式——每台机器上的引擎各自为战,全企业只有病毒库更新这一个同步通道。这个模型在两个维度上同时破产:攻击变得低频但深度化(十年见一次,来了就要命),资产规模又大到人工巡检毫无可能。
出路只有一条:把观测下沉成遥测,把研判集中成平台。每台主机持续上报细粒度的事件流水(谁生成了谁、访问了什么文件、连了哪个地址),后端平台像审阅城市监控系统一样检视全企业的进程生长史。于是"一台主机的异常"第一次有机会在几分钟内变成"全组织的已知知识"。
图:终端遥测管道的分层架构
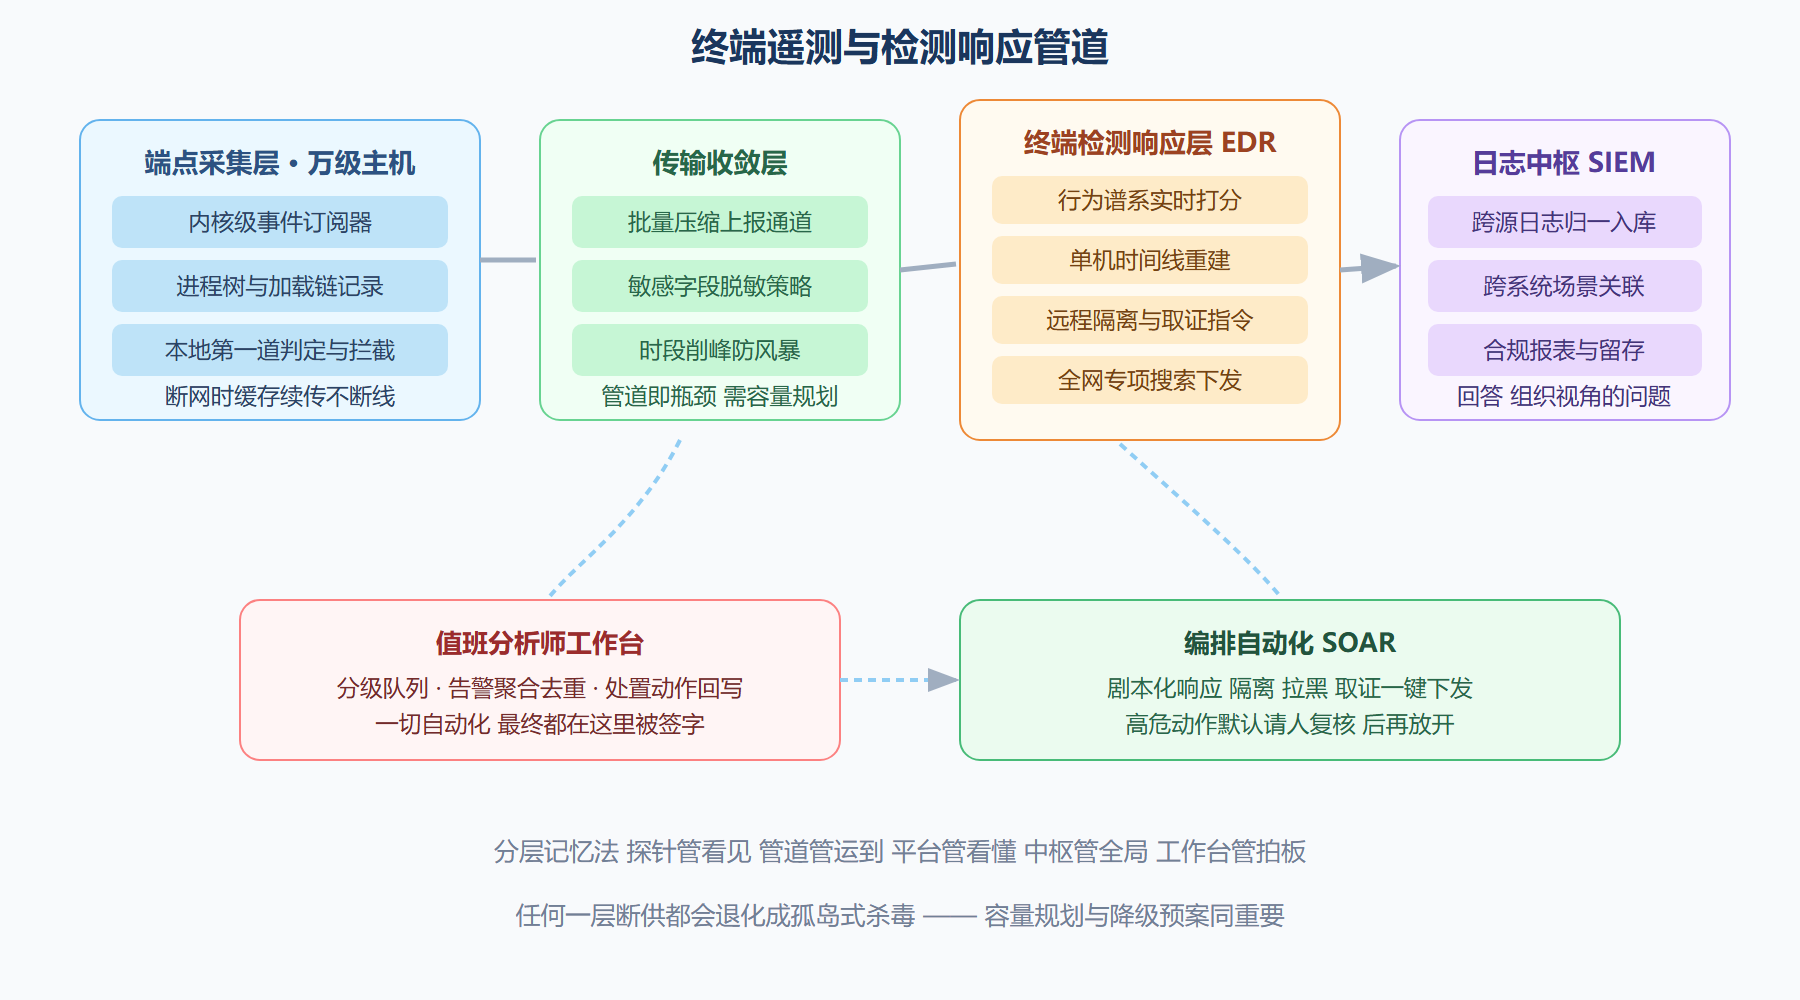
二、遥测记什么:一组有代表性的字段
判断一套遥测体系是否扎实,看它的事件字典就够。以下字段组是从工程实践中提炼的最小核心集(用记录格式示意):
[proc] 进程事件骨架 时间戳 | 主机标识 | 进程唯一号 | 父进程唯一号 镜像路径 | 命令行全文 | 发起账户 | 签名状态 | 首次出现标记 [file] 文件事件 创建 改名 删除 | 目标路径 | 触发进程号 | 是否进入自启位置 [net ] 网络连接 五元组 | 目的信誉初筛标签 | 触发进程号 | 连接时长与流量档位 [reg ] 配置变更(类 Unix 平台对应关键配置文件) 键路径或文件路径 | 新旧值摘要 | 触发进程号 [scr] 账户与会话 登录成败 | 凭据使用来源 | 权限变化点
三个设计要点藏在细节里。其一,父进程唯一号是灵魂字段——没有它就还原不出谱系,行为分析直接瘫痪。其二,"首次出现标记"给基线比对提供了免费抓手:新落地的二进制天然值得多看一眼。其三,命令行全文常含凭据等敏感信息,脱敏要在采集端就近完成,这正是传输收敛层存在的理由之一。
三、关联规则:把零散事件焊成故事
单条事件的噪声让逐条审阅注定失败,SIEM 的价值在于把事件按业务语义焊接。拿一条经典的横向移动场景举例,规则思路可以写成这样:
场景规则草稿 同一时段内的可疑扩散前奏 ────────────────────────────────────────────── 条件一 同一源主机 十分钟内 对超过二十台内网主机的 远程管理端口发起新会话 条件二 其中至少五次使用了同一非常规账户 且该账户此前三十天无远程登录史 条件三 关联查询 该源主机近一小时内存在 告警级别中以上 的端点事件 满足 全部三条 → 生成高优先级工单 并自动将源主机列入观察名单
这套规则的每一句都有对应的战场含义:条件一是扫描或漫游的直接物证;条件二排除了运维批量作业的正常解释(正规发布流程用的是服务账户且有节奏);条件三把网络侧线索与主机侧信号互相印证,大幅抬高置信度、压低误报率。写规则的心态应当像写侦查报告而非堆砌关键词——每个条件都应能回答"这条是为了排除哪种正常解释"。
四、响应自动化:快与稳的折中艺术
SOAR 的出现让"告警后十分钟完成隔离"成为可谈的指标,但自动化的分寸拿捏需要清醒:
适合放手的动作有三个共同特征——可逆、低误伤、高频次。比如对确定性恶意哈希的全网封禁、对确认失陷主机的强制隔离、为取证启动的标准化收集脚本。这些剧本一天可能跑几十次,人手反而成为瓶颈与错漏源。
必须留给人类的动作同样有三个共同特征:影响生产业务的处置(宁慢勿错)、涉及关键基础设施的操作(合规通常要求双人复核)、以及一切无法可靠评估爆炸半径的动作。曾经发生的惨案值得引以为戒:防护平台的一次误更新可以把全部门店的收银终端拖垮——这就是为什么高危动作默认带灰度与人审闸门。
五、落地时绕不开的三道坎
方向对了之后,真正决定成败的反而是几件不起眼的工程事。
第一坎,探针覆盖率。 规划图总是画得全网皆兵,现实是总有百分之几的机器因为系统太旧、业务冻结或产线隔离而装不上探针。缺口本身不可怕,可怕的是没人知道缺口在哪——覆盖率报表要按操作系统与业务条线分列,缺口机器改用网络侧监测兜底,并给出替换时间表。看不见的那一小块,恰恰是定向攻击者最喜欢落脚的暗角。
第二坎,数据洪峰的成本。 全量遥测的数据量以每日千亿条计,存储与索引费用能吞掉整个安全预算。务实的做法是分层留档:高频原始流保留短周期用于实时判定,聚合与摘要视图长周期留存供回溯,真正需要全量还原的场景再按主机定向深挖。容量规划要与检测目标对表——想回答"三十天内这台机器还感染了谁",就别只买七天的存储。
第三坎,误报治理的常态化。 上线头三个月告警洪水几乎是必然经历,很多项目死在这一步——不是技术不行,是值班同学被噪声淹没后集体放弃信任。对策是把误报治理做成产品迭代而非救火:每周固定例会按规则归并 top 误报源、白名单调整走变更评审、每条规则的命中率与处置转化率张榜公示。让数字证明噪声在退潮,团队才会留下来。
六、给管理层的一页话术
跨过三道坎之后,还有一道非技术的关口:向决策层解释为什么要把预算投给"看不见产出的数据工程"。一页话术往往比一百张架构图管用。核心论证三句:第一,单点产品的拦截率天花板人人相同,差距只在被突破后的响应速度——而速度取决于遥测与关联的数据底座;第二,这套底座的产出可以量化为平均检测时长与平均处置时长的缩短曲线,每压缩一小时都在为停机损失减负;第三,它同时是合规审计的答卷机——日志留存、事件追溯、处置留痕在多数监管框架里本就是硬要求,把合规支出与能力建设合并采购才是真正的省钱。
说完这三句,再展示上一季度的告警趋势与误报治理曲线(第三坎的副产品),预算会的氛围通常就不一样了。
本节要点回顾
- 千台规模之上,检测本质变为数据工程:看得见靠探针、送得到靠管道、看得懂靠平台。
- EDR 与 SIEM 的分工一句话说清:前者深查单机的生命史,后者回答组织面的关系题。
- 遥测字段三要素:父子进程谱系、首次出现标记、采集端脱敏。
- 关联规则写作要按排除法设计条件,目标是用置信度换掉人力。
- 自动化的准入标准是可逆、低误伤、高频;生产性处置永远保留人的最后一票。
前三层解决的都是"已知的形状"。但真正的对手从不按库里的姿势出场——下一节讨论当特征穷尽之后,人怎么主动出击。