1.1 核心概念与发展历程
1.1 核心概念与发展历程
本节摘要:Doris 是一款基于 MPP 架构的实时分析型数据库,以"简单架构承载实时与批量混合负载"为核心主张。本节沿它的演化时间线解释每个关键概念的来路——MPP、列存、向量化、主键更新、湖仓联邦都不是凭空发明的术语,而是特定阶段业务矛盾逼出来的答案。理解了这条因果链,后面章节里那些看似武断的设计决策就会变得顺理成章。
学习目标
阅读完本节,你应当能够:
- 按时间顺序复述 Doris 的四个演化阶段及其驱动因素;
- 解释 MPP 与列存为什么是分析数据库的"默认底座",以及它们各自的短板;
- 用一句话说清向量化执行改变的是什么层面的性能;
- 区分 Unique Key 模型下 Merge-on-Read 与 Merge-on-Write 的本质差别;
- 说明 Doris 在湖仓生态中扮演的"查询加速层"角色从何而来。
一、一切始于报表跑不完
故事的主场在 2010 年代初的百度凤巢广告系统。广告主报表、竞价数据分析、账户维度的实时汇总,这些需求有一个共同形状:数据量在 TB 到 PB 级之间,查询模式高度固定(按维度聚合),但对返回速度的要求却是交互级的——人盯着页面等结果,超过几秒耐心就耗尽了。当时内部可用的两套方案都不趁手:基于 MySQL 的分库分表方案抗不住聚合规模;Hadoop 系的离线链路又太慢,一条 Hive 查询动辄分钟起步。
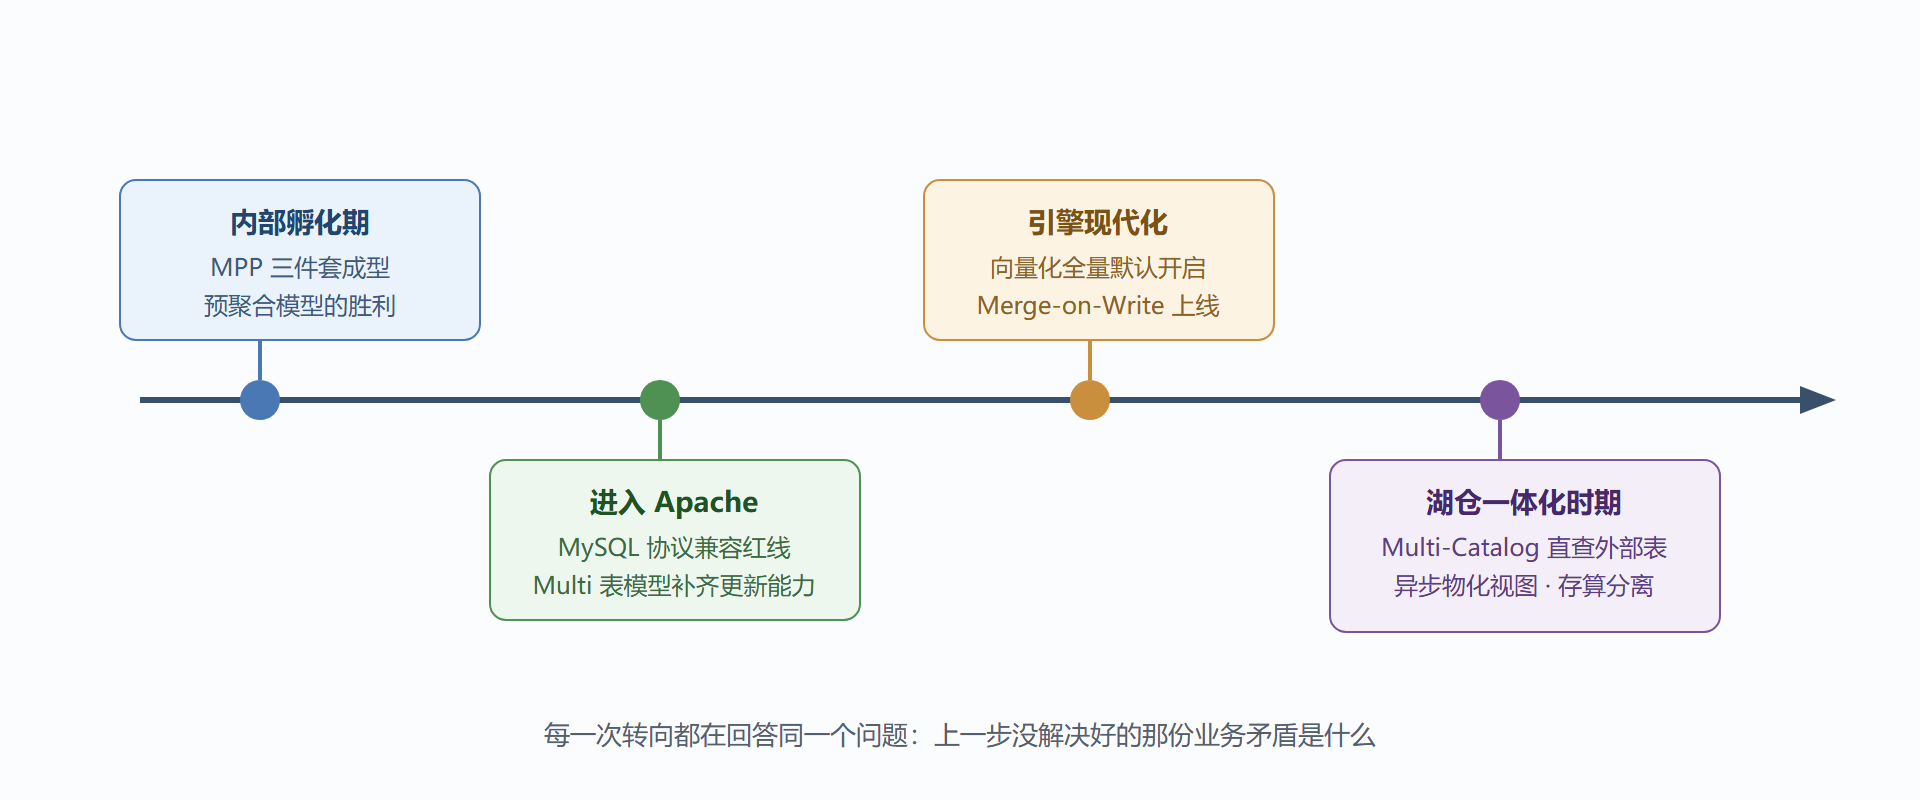
于是百度网页搜索部的工程师选择自研一套专用引擎,这就是 Palo 的起点。它做了一次关键的赌注:不追求通用 SQL 引擎的全功能,只把"多维度固定模式聚合"这一件事做到极致。具体手段是我们今天耳熟能详的三件套——MPP 并行计算框架让一台集群像一台机器那样干活,列式存储让聚合查询少读九成以上的无关字节,预聚合模型把最常见的 GROUP BY 提前算好。
这段历史解释了 Doris 至今保留的两个"胎记"。其一,它天生假设数据是被导入进来而非直接写事务日志进来的,所以复制、压缩、合并这些机制都围绕批量写入优化;其二,它的查询规划器对"大宽表 + 维度过滤"这类模式有近乎条件反射式的加速路径,而对任意复杂的关系代数表达需要更多的版本迭代才能追平。
二、开源转折:从内部工具到社区项目
2017 年前后,Palo 在百度内部已经支撑了上千个业务场景,团队做出第二个关键决定:开源。2018 年项目进入 Apache 软件基金会孵化器,更名为 Apache Doris,2022 年毕业成为顶级项目。
这次转向带来的不只是社区声望。内部工具时期,需求由单一公司的业务形态牵引,功能取舍带有明显的"广告分析滤镜";进入 Apache 后,来自电商、物流、金融、游戏等数百家企业用户的需求涌入,倒逼几个方向的能力补齐:
- 更新能力:电商库存、用户画像标签、风控指标都需要对已导入的数据做修改,纯 Duplicate 模型不够用了,Unique Key 模型因此获得持续强化;
- Join 复杂度:单表场景提高不到通用分析的天花板,Colocation Join、Bucket Shuffle Join 这些分布式关联策略在社区期快速成熟;
- 生态接口:兼容 MySQL 协议成了一条不成文的红线,这让它几乎零成本地接入了现存的全部 BI 工具。
一个值得琢磨的现象是:Doris 社区的很多核心改进并不来自"炫技式创新",而来自"把某个行业用户的痛点抽象成通用能力"。这种工程化取向也塑造了本册的写作立场——我们关心的不是参数的 exhaustive 列举,而是每个参数背后那类用户到底遇到了什么问题。
图 1-1:Doris 演化时间线与各阶段代表性能力
三、把核心概念放回历史位置
现在可以给本章开头提到的关键词逐一"验明正身"了。
MPP(大规模并行处理):把一张逻辑大表按规则切成众多物理小片(Tablet),分散到多台机器,查询时所有机器同时算自己那部分,最后归并结果。它解决的是"单机内存和 CPU 不够"的问题,代价是任何跨片操作都要付网络搬运费——这也是后面第 5 章调优时反复出现的权衡点。
列式存储与向量化:列存让"求所有订单金额之和"只需读金额一列;向量化则更进一步,把逐行解释执行改为按批次(通常数千行一组)用 CPU 的 SIMD 指令处理。二者叠加后,同样的硬件能撑起数倍到数十倍的扫描吞吐。Doris 在 1.x 系列把向量化引擎设为默认,是其性能口碑的分水岭事件。
主键更新:分析库 traditionally 只增不改,但业务总要改数。Doris 的答案是 Unique Key 模型:写入时带上主键,读取或写入阶段按键去重合并。早期采用读时合并,查询付费;后来引入写时合并(Merge-on-Write),改为导入时多做一点工作换取查询路径的干净。这套机制的工程细节在 4.2 展开。
联邦查询:当湖仓生态崛起,Doris 选择不当孤岛——通过 Multi-Catalog 直接挂载 Hive Metastore、Iceberg、JDBC 数据源,用自己的执行引擎为外部数据提供加速。它在技术栈里的位置从"又一个存储引擎"悄然移向"统一查询入口"。
💡 一个读历史的直觉:凡是 Doris 后来着力加强的方向(更新、复杂 Join、联邦),都是当初为了让那件核心的事更简单而主动放弃的。产品演化的连续性,藏在当初的取舍清单里。
常见疑问
问:Doris 和 StarRocks 是什么关系? 同源分岔。StarRocks 从 Doris 早期版本分岔后独立演进,两者在架构词汇与表模型上高度相似,细节能力各有侧重。选型评估时值得同时打样对比,但本册讲授的建模与调优方法论在两者间基本通用,迁移成本主要在版本化的功能差异上。
问:既然有湖仓一体,还有必要学表模型和分区分桶吗? 有,而且更必要。湖仓解决的是"数据放哪、格式怎么统一",而"表怎么建才能让查询少读字节"的问题在任何架构下都存在——湖上的表格式同样要分区、要排序、要权衡文件大小。第 3 章的训练是对方法论的投资,不随引擎版本过时。
问:演化历史对日常使用有什么直接帮助? 最大的帮助是排障时的"因果直觉"。知道 Merge-on-Write 是为救查询路径而生,就能理解它为什么在导入侧有额外开销;知道 MySQL 协议兼容是社区期的红线决策,就能放心把 BI 工具直接指过来而不用找专用驱动。历史不是故事,是设计决策的出处证明。
本节要点回顾
- 起源即聚焦:Palo 因"广告多维报表要秒级响应"而生,预聚合加列存加 MPP 是那条原始答案。
- 开源重塑基因:社区期补齐的是更新能力、分布式 Join 和协议生态三块短板。
- MPP 有代价:并行换速度的同时引入网络交换成本,这是后续所有调优讨论的物质基础。
- 列存加向量化是性能分水岭:前者省 IO,后者榨干 CPU,两者缺一时另一方的收益都有限。
- 主键更新的两种买单方式:读时合并省写入、贵查询;写时合并反过来,本册建议绝大多数实时场景选后者。
- 定位随生态漂移:今天的 Doris 更像"查询侧的统一入口",而不再只是自持数据的仓库。
下一节我们把镜头从历史拉回当下,用一份可验证的特征清单界定 Doris 到底擅长什么、坚决不碰什么——那里同样有著名的"反例场景"值得细看。