- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Doris 数据仓库教程导读
「大宽表」「拉链表」「T+1」——数据仓库的行话翻来覆去就是这几个词,可真到建表拍板时,每个词背后都是一串要付代价的决策。大促之夜的作战室里,运营盯着实时大屏追问 GMV 为何比预估低了两个点,数据同学还在等没跑完的 T+1 批任务——这种被报表延迟"卡脖子"的窘境,是很多团队头一回认真考虑 Apache Doris 的起点。这套文集就是为站在那个起点上的人写的:从选型判断、建表拍板,到导入链路、SQL 调优、故障处置,把整条实时数仓建设路径走通。
Apache Doris(前身是百度内部引擎 Palo,2018 年进入 Apache 孵化器并毕业)是一个基于 MPP 架构的实时分析型数据库。它不依赖 Hadoop 系组件即可独立部署,兼容 MySQL 网络协议,列式存储加向量化执行让它在大宽表聚合、多维过滤、高并发看板这些典型分析负载上能给出亚秒级响应;主键模型配合 Merge-on-Write 又让更新类需求有了着落。轻量架构、单系统覆盖"导入-存储-查询-服务"全链路,是它与 ClickHouse、Trino、Hive 体系同台时最鲜明的差异。
这本教程讲什么、不讲什么。 它讲的是工程师视角的决策与实操:什么时候该选 Doris 而不是其他引擎;三种表模型各自适合什么业务形态;分区分桶数量怎么估、前缀索引字段怎么排;六种导入方式分别在什么延迟与吞吐下出场;慢查询如何用执行计划与 Profile 定位瓶颈;集群指标异常时先检查哪几个开关。它不讲分布式数据库的理论推导,也不替代官方文档里的参数字典——每个涉及配置项的位置,我们会说清取舍逻辑,具体默认值以你使用的版本为准。
章节安排与依赖关系。 全册八章,按"先决策、再建模、后运维"的顺序推进:第 1 章解决"要不要用它";第 2 章拆开 FE 与 BE 的分工,理解后面所有现象的根源;第 3 章是全书的重心——建表建模,很多性能问题在这一章就注定;第 4 章讲导入与更新的全链路,附带一份排错工单实录;第 5 章是 SQL 调优演练场,含一次从十二秒到亚秒的真实降耗过程;第 6 章覆盖物化视图、联邦查询与权限;第 7 章面向值班场景,给出演练过的应急手册;第 8 章收束到生态对接与行业落地。章节间的学习依赖如下图所示。
图 0-1:全册知识地图与学习路线
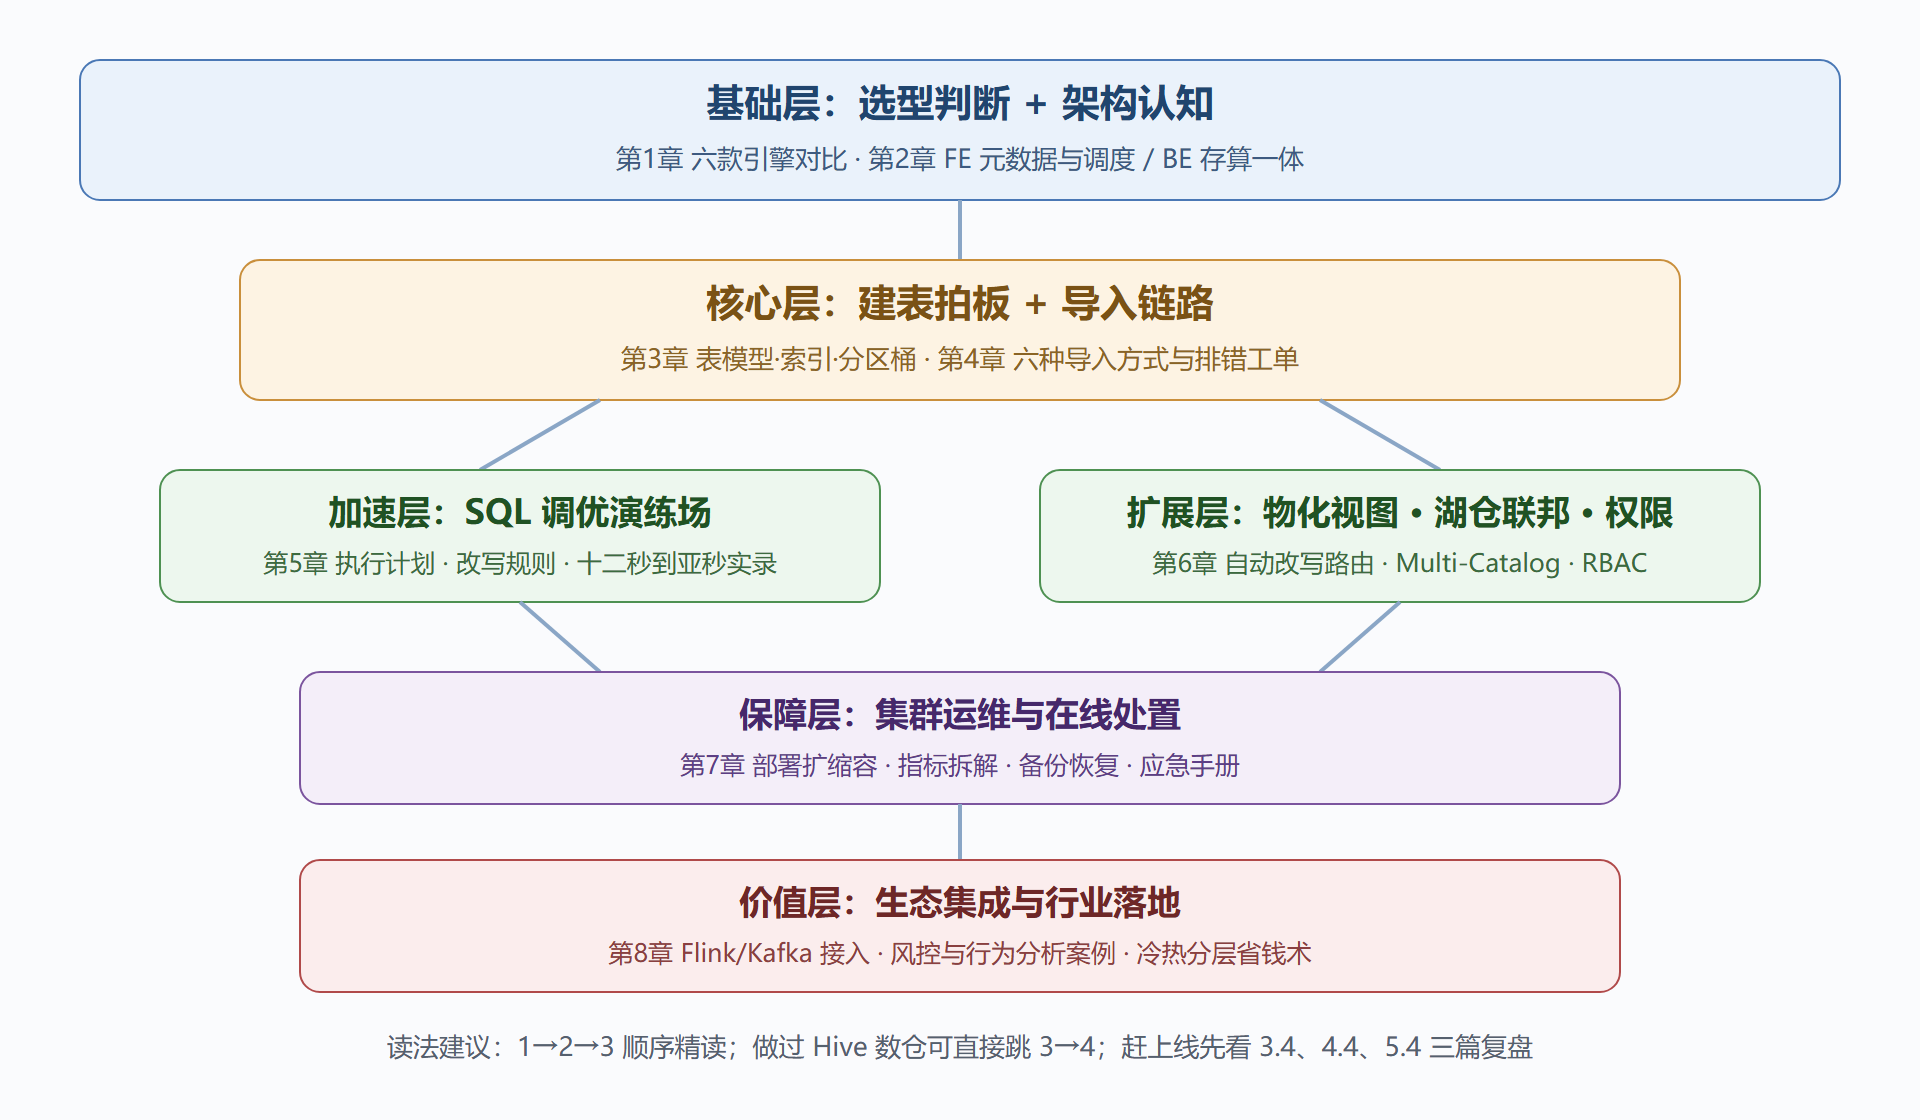
面向谁。 第一类是正在做技术选型的后端或数据平台工程师,建议先读第 1 章的六款引擎对比和第 2 章的架构分账;第二类是即将动手建表的数仓开发,第 3 章的四节加上 3.4 的订单宽表复盘值得逐段过一遍;第三类是线上系统的值守者,第 4.4 排错工单、第 5.4 降耗演练和第 7 章应急处置组成了一条"出事时怎么想"的线索。全书示例基于社区版 2.x 系列,个别行为随版本演进会有出入,遇到细节冲突请以自己集群的实际表现为准——这也是本册反复强调的习惯:让数据和解释都来自你的现场。
读法上不必贪快。每一节的要点回顾是压缩后的决策清单,正文里那些带数字的推演过程才是真正可迁移的能力来源。合上屏幕后能用一句话说清"这张表为什么分了三十六个桶",才算把这册书读进了手里。
最后交代一条贯穿全册的隐线:每个决策都留了反悔的出口,但出口的价格不同。表模型选错,出口是重建,价格最高;分区分桶失当,出口是建新表双写切换,价格中等;导入通道选错、参数失当,出口是改配置,价格最低。所以全册的笔墨分配也按这个价格梯度走——第 3 章建模讲得最细,因为那里错一步最贵。带着这个视角去读,你会明白为什么有些章节反复权衡、有些章节直接给操作:权衡的成本,永远和反悔的价格成正比。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...