5.1 查询执行流程
5.1 查询执行流程
本节摘要:所有性能问题都要先回答"时间去哪了"。本节把一条 SQL 的生命周期切成六段——接收解析、改写优化、计划切分、任务调度、并行执行、归并返回——并说明每段的耗时量级与典型病灶。读完后你拿到一条慢查询,第一反应应该不再是重启,而是能立刻指出它在第几段卡住。
本节先立四个目标
阅读完本节,你应当能够:
- 按时间线复述六段流程,并为每段给出健康耗时的数量级;
- 解释 Fragment 与 Instance 的层级关系及并行度来源;
- 通过 EXPLAIN 输出定位"该下推的谓词没下去"的证据;
- 区分计划时间与执行时间在 Profile 中的字段位置。
一、六段时间线
一段与健康态的对照是排查的第一张表:
| 阶段 | 发生位置 | 健康量级 | 典型病灶 |
|---|---|---|---|
| 接收与解析 | FE | 毫秒内 | SQL 超长、深层嵌套视图叠加 |
| 改写与代价优化 | FE | 数毫秒到百毫秒 | 统计信息缺失、表数量过多 |
| 计划切分 | FE | 毫秒级 | 实例数配置失当 |
| 调度分发 | 网络RPC | 毫秒到十毫秒 | BE 心跳抖动、大集群扇出 |
| 并行执行 | BE | 主战场 | 扫描放大、倾斜、内存受限 |
| 归并返回 | 协调节点 | 微秒到毫秒 | 超大结果集、TopN 未收敛 |
看板类负载的前四段加总通常低于五十毫秒——超过这个数就该怀疑语句复杂度而非集群能力。而执行段占到 P99 的九成才是常态,那里的功夫在本章后三节。
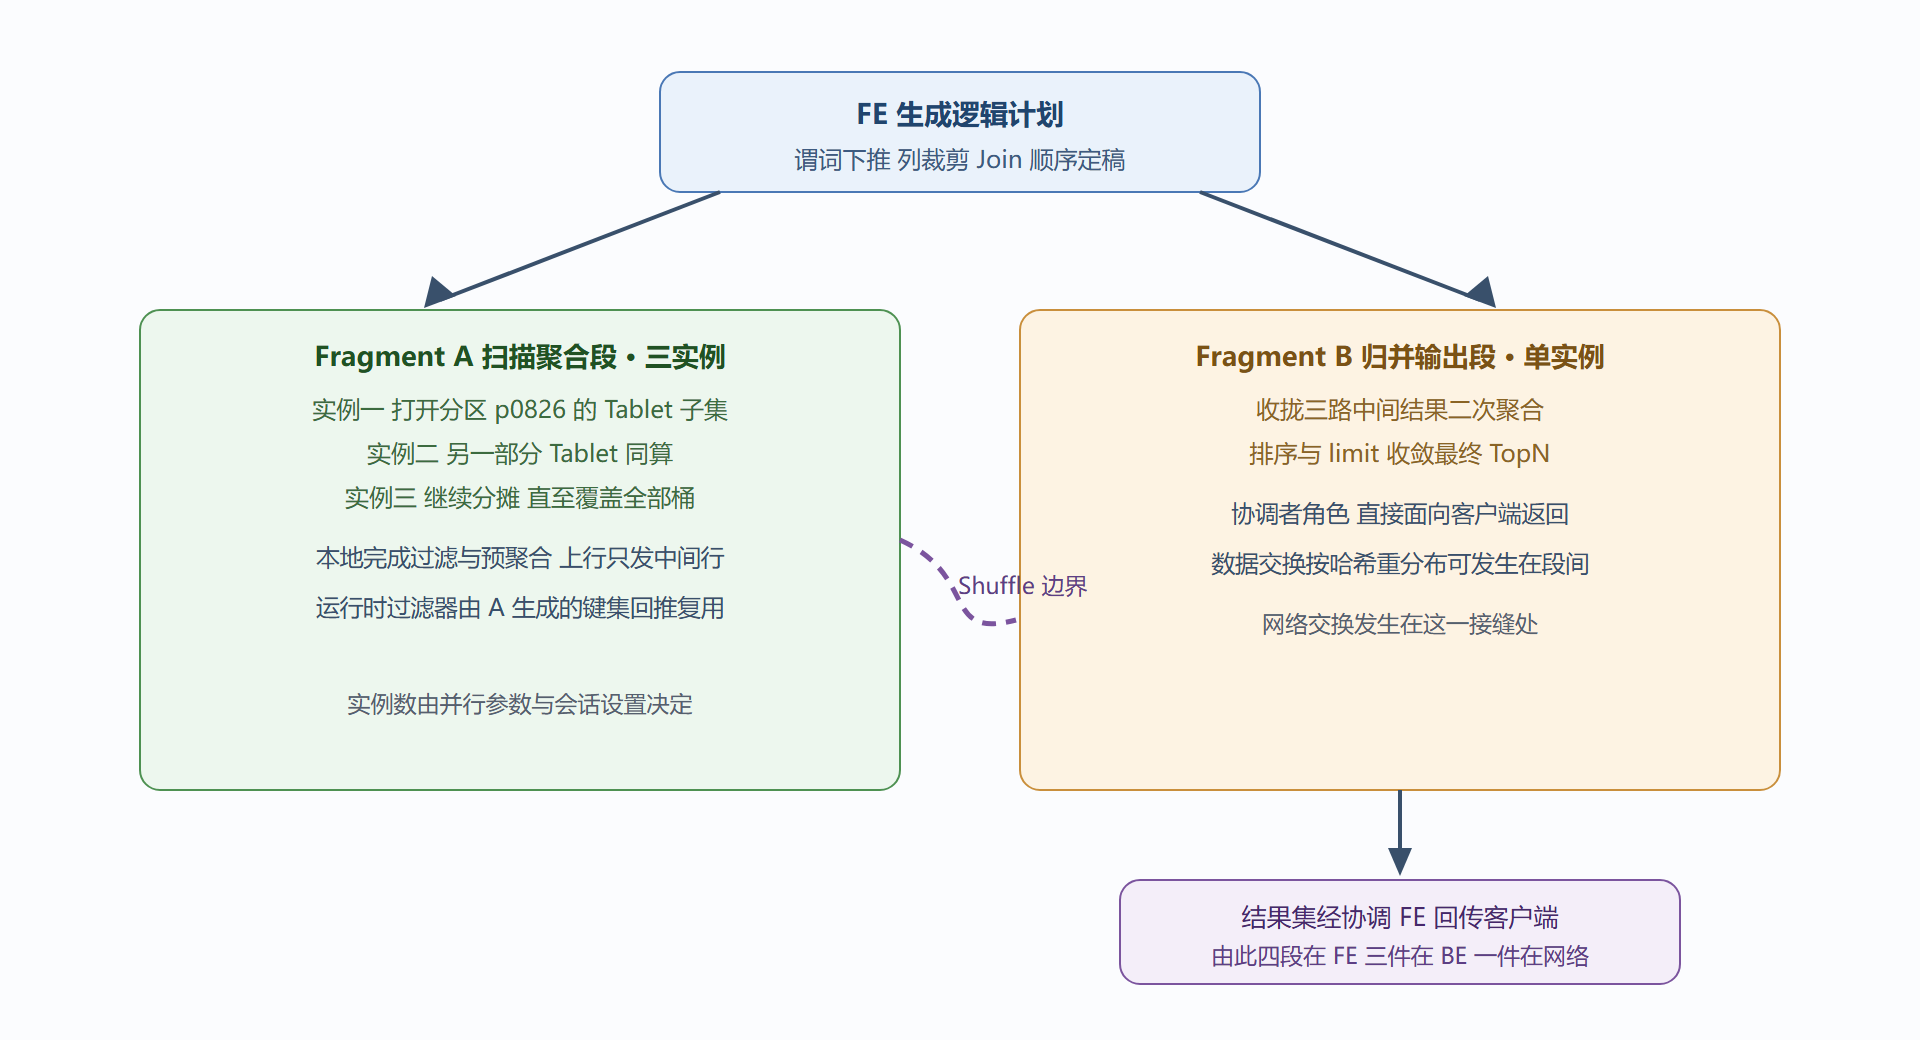
图 5-1:一条聚合查询的 Fragment 切分示意
二、并行度的两层含义
同一个物理计划被切为多个 Fragment,每个 Fragment 又会按并行参数裂变出若干 Instance。并行实例数的决定因素有三个:参与扫描的 Tablet 总量(硬上限)、会话里的并行度参数、以及新版 Pipeline 执行引擎的资源自适应策略。经验上:
- 小表硬凑并行毫无收益,实例数超过 Tablet 数纯属空转;
- 大扫描默认吃满每机核数的一半左右起步,遇到内存压力再降;
- Pipeline 化版本大幅弱化了手工微调的意义,优先升级而不是抄旧参数。
倾斜在此再次露头:一旦某个 Instance 分到超大 Tablet,其余核只能围观。判断证据是 Profile 里同一 Fragment 各实例的扫描耗时的最大最小比,超过三倍就先查分布再谈并发。
三、EXPLAIN 该看的三个信号
EXPLAIN SELECT u.city, SUM(o.pay_amount) FROM dwd_order_detail o JOIN dim_user u ON o.user_id = u.user_id WHERE o.dt = '2026-08-26' AND o.channel = 'app' GROUP BY u.city;
三件事从输出里找答案。其一,扫描节点的分区命中:应出现且仅出现当天分区;若全分区名列队,说明日期谓词写法绕过了裁剪(比如对列套了函数)。其二,Join 类型与顺序:BROADCAST 还是 SHUFFLE、小表是否被当成 build 侧;若把三亿行的大表选成了广播源,基本就是统计信息缺席。其三,过滤器传递:计划里若能看到 Runtime Filter 注记,说明维表过滤将反推到事实表扫描器。三者齐备的计划才值得进入下一层观测。
四、Profile:把猜测换成数字
开启采集后,一份 Query Profile 会按 Fragment 与算子逐层列出各阶段的耗时、行数变化、内存峰值与网络字节数。解读顺序推荐固定化:
- 先看总览里的计划时间与等待调度时间的占比,排除 FE 侧嫌疑;
- 进入耗时最长的 Fragment,找最大的那个算子(一般是扫描或哈希构建);
- 对照输入输出行数验证裁剪是否兑现:一亿进十万出的扫描是健康的,一亿进九千万出说明过滤器没干活;
- 检查内存字段是否逼近限额,近限则尝试控制并发实例数。
💡 关键直觉:Profile 里最值钱的数字不是总耗时,而是相邻算子之间的行数差——它等于整条流水线的体检报告。
五、三个高频误判
流程背熟之后,真正的坑在解读环节。三个反复出现的误判值得提前打预防针。
误判一,把调度等待当成执行慢。 有类工单语句本身只跑一秒,用户却等了八秒。Profile 总览里执行时间正常,但等待调度的时间占比畸高——问题不在语句而在并发:集群同时排着几十个重查询,它排队排了七秒。处置方向完全不同:不是优化 SQL,而是查资源组配额与并发上限,必要时按 5.3 的隔离手段给业务分流。判别口诀是"总等待减总执行,差值大先看队列"。
误判二,把倾斜误诊为内存不足。 某个 Instance 报内存超限,第一反应常是调大内存限额。若倾斜才是根因,调限额只是让那一个实例多吃内存苟活,其余实例依旧围观,全局吞吐没有变化,还压缩了整机并发空间。正确的次序是先比同一 Fragment 各实例的行数与耗时分布,确认均匀后再动内存参数——不均匀就回第 3 章查分桶键的选择。
误判三,把结果集大当成查询慢的必然。 导出十万行明细的任务天然要传输数据,这类语句的耗时主体在网络传输与客户端消费,Profile 里扫描与计算都轻。它需要的不是调优而是形态调整:分页拉取、异步导出、或者干脆让下游改成读聚合表。把"慢"分类成"算得慢"还是"传得慢",是接手任何陌生工单后的第一个分叉路口。
常见疑问
问:EXPLAIN 正常但语句还是慢,下一步查什么? 计划与执行是两层。计划正常说明优化器认为路对了,执行慢说明路况变了——用实际执行的 Profile 对照估算行数,偏差超过一个数量级通常是统计过期(去 5.2 看采集制度)或数据倾斜(回第 3 章看分桶)。
问:六段流程里哪段最值得建设自动化? 第五段。前四段异常 rare 且语句侧可控,第六段交给网关;只有执行段的归因可以沉淀成规则库——行数衰减比、实例间方差、内存水位这三个指标足够机器自动给八成慢查询打出初步归因标签。
交叉对照
把六段流程与全书其他章节的对应关系列全,方便回查:解析与改写两段的深水区在第 2.2 节的 FE 五步;并行执行段的存储侧机理在 2.3 的四层漏斗;扫描裁剪兑现不了时去第 3 章查建模决策;计划时间异常抬头时回 5.2 查统计信息;等待调度占比高时按 5.3 的资源隔离手段分流。一张慢查询工单,通常沿这条路径走一遍就能归位。若归位失败——每个环节看起来都健康但语句就是慢——那就把语句当作第 5.2 的输入:让优化器的改写与策略选择接受一次人工复审,最后再怀疑数据本身的新鲜度。
本节要点回顾
- 六段流程各有专属病灶:前四段怀疑语句与元数据,第五段查数据形态。
- Fragment 是段,Instance 是人:真正的并行单位是后者,上限来自 Tablet。
- EXPLAIN 只需盯三点:分区命中、Join 方向、过滤器注记。
- Profile 读法固定化:总览、最长算子、行数衰减、内存水位四步走。
- 倾斜要用实例间比值说话:最大最小超三倍先修数据分布。
下一节进入优化器的军械库:哪些改写它能替你做,哪些 Join 策略你可以点名要求。