6.2 多Catalog联邦查询
6.2 多Catalog联邦查询
本节摘要:一个反面教材开场:某团队为了一张联合报表,用每日调度把 MySQL 的八百万行客户表全量搬进数仓,搬了半年,直到某天源库改了字段类型,链路在凌晨三点断了没人知道。多 Catalog 提供的是另一个答案——数据不动,查询过去。本节讲接入三类典型源的完整链路、跨源关联的执行要点,以及元数据缓存的时效账怎么算。
本节能力目标
阅读完本节,你应当能够:
- 为 Hive、Iceberg、MySQL 三类源创建 Catalog 并验证连通与元数据可见性;
- 判断一条跨源查询的过滤有没有真正下推到源端执行;
- 为外部表设定元数据缓存时效,并说清陈旧结构风险的应对;
- 用"该搬还是该联邦"的决策清单回答架构评审里的经典争论。
一、先搬后查的三笔账
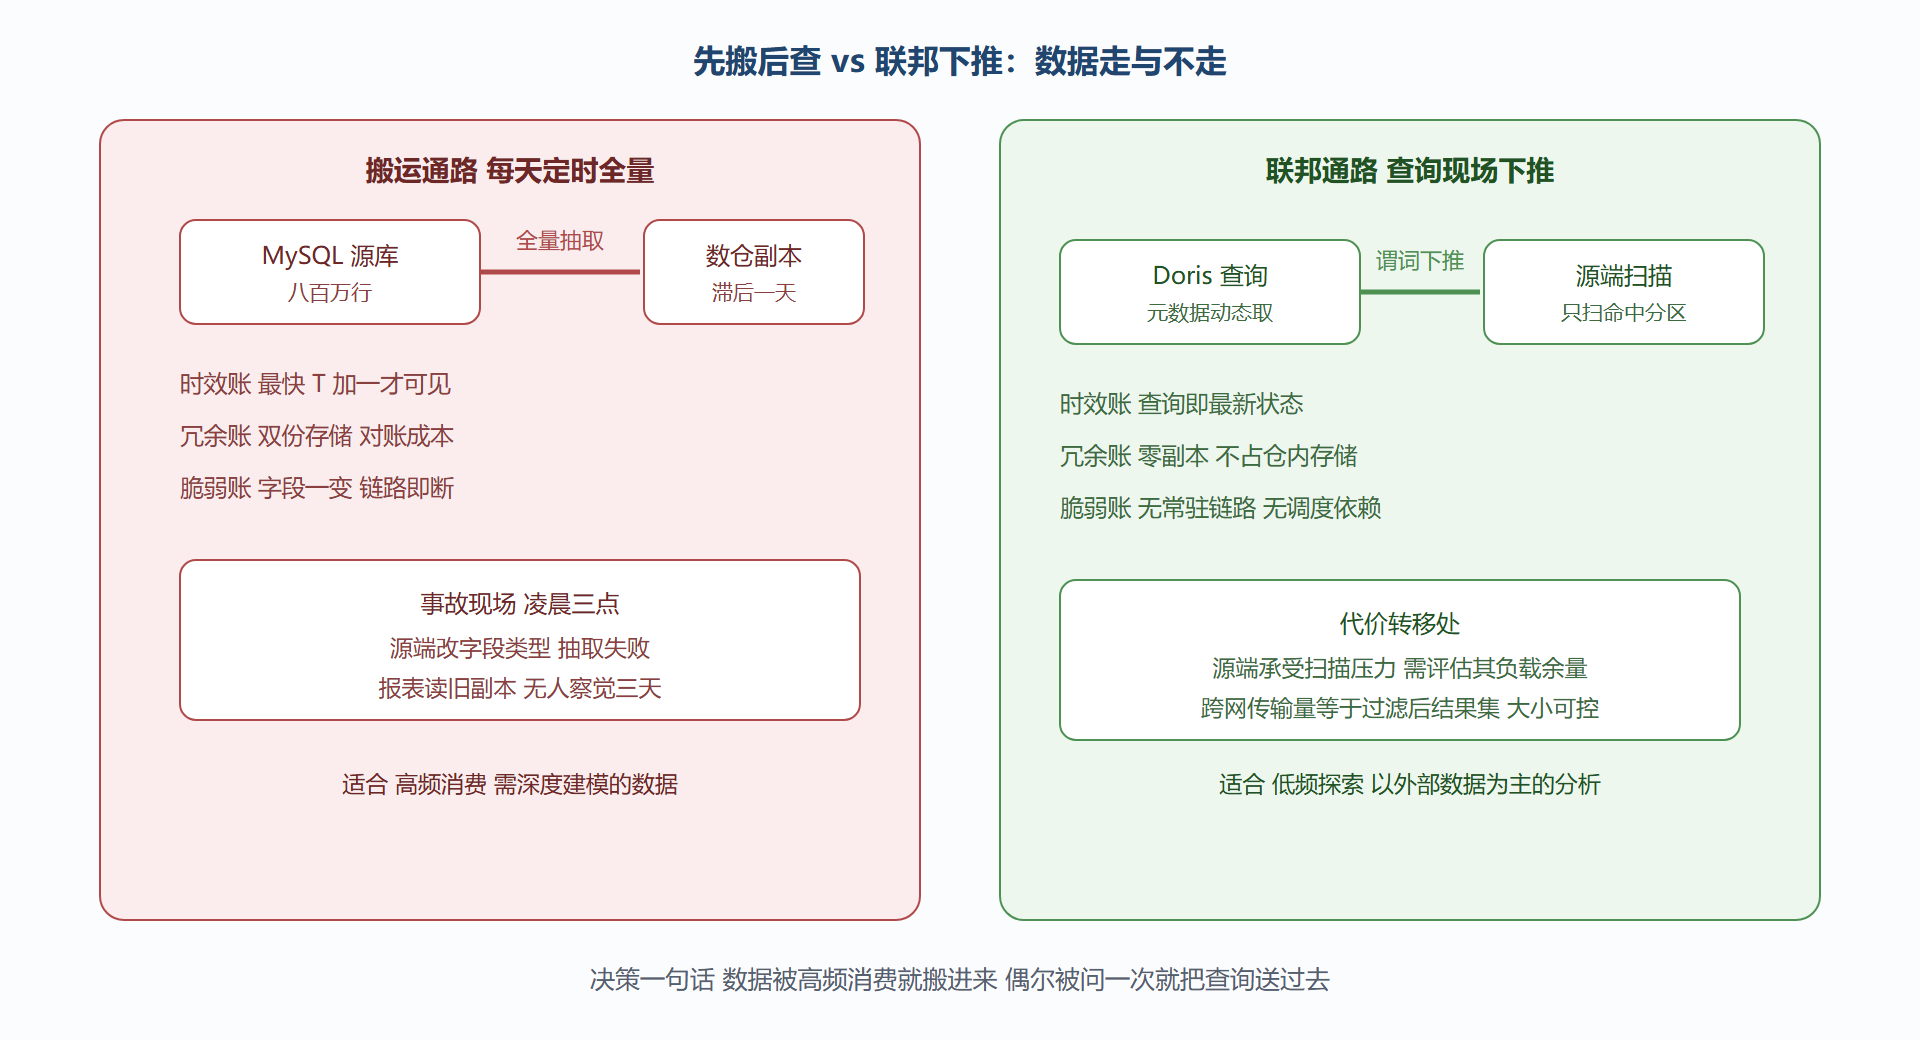
传统的"先 ETL 进仓再分析"模式欠着三笔账。时效账:搬运链路天然带批处理延迟,源端改了数,仓里的副本最快也要到下一个调度周期才知道;冗余账:同一份客户主数据在业务库存一份、数仓存一份、可能还有一份在湖里,三份各自的存储成本与对账成本都在复利;脆弱账:每条搬运链路都是一个会断的活性部件,字段变更、网络抖动、调度竞争,断在任何一处都是一次"凌晨三点的事故"。联邦查询的思路是把这三笔账一次性清掉——元数据动态获取,计算尽可能下推到源端,只有必要的结果集才跨网络回来。
当然这不是说搬运一无是处。高频消费、需要与仓内数据深度建模的外部数据,老老实实同步进仓仍是正解;联邦的甜点区是低频、探索性、以外部数据为主体的联合查询。这条边界后面有决策清单,先把能力讲透。
二、接入链路:三类源的建联与验证
接入是声明式的:创建一个 Catalog 对象,Doris 拿着它按需去源端拉元数据,不复制任何表结构。三类典型源的建联语句骨架:
-- Hive 系 走 Metastore 拿元数据 直读底层文件 CREATE CATALOG hive_c PROPERTIES ( "type" = "hms", "hive.metastore.uris" = "Metastore 服务地址" ); -- Iceberg 湖表 对接其元数据服务 CREATE CATALOG iceberg_c PROPERTIES ( "type" = "iceberg", "iceberg.catalog.type" = "rest", "uri" = "目录服务地址" ); -- MySQL 业务库 JDBC 直连 常用于维表补充 CREATE CATALOG mysql_c PROPERTIES ( "type" = "jdbc", "jdbc_url" = "JDBC 连接串", "user" = "只读账号", "password" = "对应密码" );
建联之后按三步验证,别急着写业务 SQL。第一步元数据可见:切换到该 Catalog,能列出库表且表结构与源端一致;第二步权限最小化:MySQL 源务必用只读账号,联邦链路的安全事故多半来自图省事用了写账号;第三步小样本试查:挑一张分区表取一天的分区,确认分区裁剪生效、扫描量符合预期。三步走完,这条通路才算交付。
图 6-2:同一张报表的两条取数通路
三、跨源关联:让下推真正发生
跨源关联的写法与普通 SQL 无异,Catalog 名当库名前缀用即可。真正的功夫在确认执行行为符合预期,三个观测点:
其一,谓词是否推到了源端。 对分区组织的源(Hive、Iceberg),日期过滤应转化为源端的分区裁剪,只扫命中的文件;对行存的关系库,过滤条件应随查询下发触发源端索引。验证方法与第 5 章同源:看执行计划里外部扫描节点的过滤注记与扫描量预估,再对比源端自身的监控——下推成功时,源端的负载曲线会说话。
SELECT c.region, COUNT(DISTINCT e.event_id) AS active_events FROM mysql_c.crm.customers c JOIN hive_c.ods.user_event e ON c.id = e.customer_id WHERE e.dt BETWEEN '2026-08-21' AND '2026-08-27' AND c.level = 'enterprise' GROUP BY c.region;
这条语句里两处写法直接影响下推成败:日期过滤显式落在事实表分区列上(又是 5.4 第一刀的教训),企业级客户的过滤写在维表列上让源端索引有机会接手。其二,分发方式是否合理。 过滤后的维表行数小,广播是首选;优化器依据外部统计估算,估算失准时会做出离谱选择——此时把维表先收敛进临时结果再关联,比硬调 Hint 更稳。其三,回流的数据量。 跨网传输的是过滤后的中间结果,若发现回流行数接近源表全量,说明过滤没生效,回头查写法而不是抱怨网络。
四、元数据缓存的时效账
联邦查询每次都要问源端"表长什么样",问一次是一次远程调用,高频场景下源端元数据服务先成为瓶颈。Doris 的解法是按表粒度缓存元数据,配合时效策略自动过期。这笔账的两头是性能与新鲜度:缓存期长,查询启动快,但源端改了结构,仓内还拿着旧地图——列对不上直接报错,分区对不上悄悄漏数,后者更危险。
应对按变更节奏分档:结构稳定的归档区表,缓存开长无妨;活跃业务区的表,缓存收短到分钟级,配合上游的变更通报制度;凡遇到"昨天还好好的今天报列不存在",先手动刷新该 Catalog 的元数据再排查——十有八九是源端动了结构而缓存还没过期。把"源端结构变更须通报数仓侧"写进跨团队的协作约定,是联邦链路里最便宜的一条保险。
常见疑问
问:联邦查询会不会把源库拖垮? 会,如果放任不管。生产实践是给联邦查询划独立的资源配额(第 5 章资源组的用法照搬),并对同一个源上的并发下推查询数做上限约束;重型的反复联合分析,跑通验证后就地固化为物化视图或同步任务,别把探索性 SQL 长期留在生产路径上。
问:MySQL 那张表天天要被 join,到底搬不搬? 用频率与新鲜度双轴判:高频且容忍分钟级延迟,同步进仓做维表;高频且要求实时一致,那是业务库的活儿别塞给数仓;低频才轮到联邦。多数团队的现实答案是高频表搬、长尾表联邦,两条腿走路。
常见疑问
问:联邦查询的结果能直接写回本地表吗? 能,且是"探路转固"的标准手法:用 Insert Into Select 把联邦查询的过滤结果落成本地表,跨源扫描只发生一次,后续的高频消费全部在本地完成。这也是联邦与物化视图之外的第三条加速路径——最朴素,却常常最有效。
本节要点回顾
- 三笔账定去留:时效、冗余、脆弱,搬运模式欠的账联邦来清。
- 接入三步验证:元数据可见、最小权限、小样本试查,缺一不交付。
- 下推三观测点:谓词到源端、分发方式合理、回流量受控。
- 缓存时效分档:按源端变更节奏定,活跃区收短加通报制度。
- 配额保护源端:联邦查询是借道别人家扫描,礼貌和限额都要有。
数据进得来、查得动了,还差最后一道关:谁有资格查、查到什么粒度。下一节把权限体系讲成可落地的三道闸。