3.1 行存储引擎:ASTORE 与 USTORE 的取舍
3.1 行存储引擎:ASTORE 与 USTORE 的取舍
本节摘要:openGauss 提供两种行存储引擎:ASTORE 追加更新(旧版本写新位置,靠后台回收)与 USTORE 原地更新(回滚段支撑的新旧版本管理)。默认 ASTORE 胜在成熟稳定,USTORE 在高频更新场景清理更从容。选引擎的依据是更新比例与运维形态,不是参数表上的先后顺序。
问题与直觉:更新一行,旧的那行去哪了
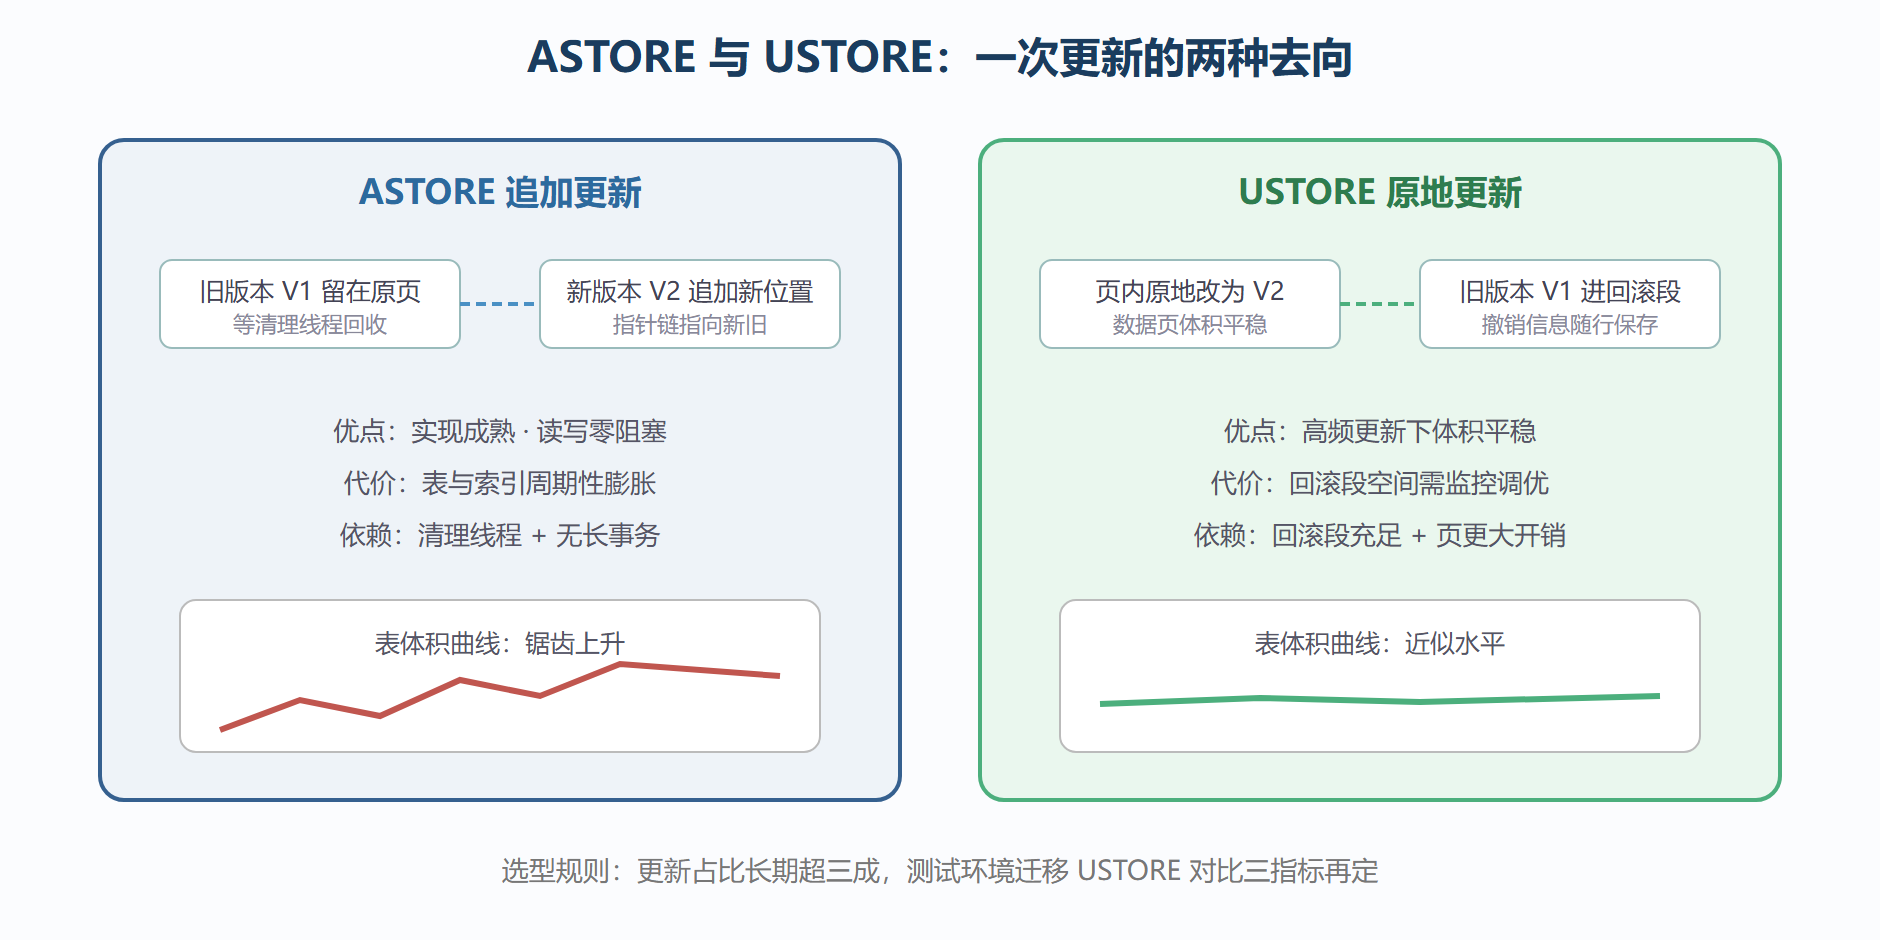
账务系统里一条余额记录一天被更新上千次,磁盘上会不会堆出一千个版本?答案是:会以某种形式存在过,但形态取决于引擎。ASTORE(追加更新)的思路是把新版本追加写到表的新位置,旧版本留在原地等后台清理线程判定无人需要后回收——读写互不阻塞,代价是表与索引会周期性膨胀,回收不及时就拖慢扫描。USTORE(原地更新)的思路是在页内原位置改数据,把旧版本挪进回滚段统一管理——高频更新下表体积平稳,代价是多一层回滚段的管理与调优。两种哲学没有绝对优劣,交付选型的全部艺术在于判断你的负载更像哪一种。
ASTORE:追加更新的账怎么算
ASTORE 是默认引擎,行为最像经典教科书里的多版本实现。它的运行画像:读永远不打断写,写永远不打断读,这对交易系统是黄金属性;但每次更新都留下旧版本,空间回收依赖自动清理线程。膨胀于是成了 ASTORE 环境的第一号慢性病——尤其两类表是重灾区:高频更新的状态表(订单状态、余额、库存),以及带索引的更新密集表(更新会同时污染所有相关索引)。观察膨胀用系统视图最直接:
-- 估算死元组规模:活元组与死元组对比 SELECT relname, n_live_tup, n_dead_tup, round(n_dead_tup::numeric / greatest(n_live_tup,1) * 100, 1) AS dead_ratio FROM pg_stat_user_tables ORDER BY dead_ratio DESC LIMIT 10; -- 手动触发一次清理与统计刷新(交付现场常用组合拳) VACUUM ANALYZE orders;
dead_ratio 长期超过两成的表要进入清理策略清单:或调快该表的清理节奏,或排查长事务——长事务持有的旧快照会让清理线程"不敢回收",这是膨胀反复发作的最常见根因,3.3 节会解释为什么。
USTORE:原地更新的账怎么算
USTORE 的核心机制是回滚段:修改在页内进行,旧版本连同撤销信息写入回滚段,需要旧数据的读和回滚都从回滚段取。它的优势场景很清晰:订单状态这类一分钟更新数十次的表,ASTORE 下死元组产量惊人,USTORE 下表体积几乎是一条直线。它要求的运维姿势也不同:回滚段空间要监控(写满会阻塞事务)、页结构更大带来一定的空间开销、故障恢复要多回放撤销记录。给交付团队的经验阈值:一张表的更新占比(更新行数次于查询命中行数)长期超过三成,值得在测试环境把表迁到 USTORE 对比一轮——比的是清理线程的 CPU 占用、表体积曲线和长尾延迟三个指标,而不是单点跑分。
图:两种行存引擎在同一更新负载下的行为对比
选型落地流程:三步定引擎
第一步,用统计视图拉出全库更新热度榜,标出更新占比最高的前十张表;第二步,确认这些表当前清理策略的执行情况——很多所谓的"USTORE 需求",其实是长事务导致清理失效,修掉长事务后 ASTORE 就够用;第三步,对确认高频更新的表,在测试环境建 USTORE 副本,用真实流量回放对比三项指标(表体积、清理开销、长尾延迟),拿数据做决定。一个真实案例的结局:某票务系统座位锁定表,ASTORE 下每晚膨胀回收循环导致早高峰抖动,迁 USTORE 后体积曲线走平,早高峰抖动消失——而同时测试的订单明细表几乎不更新,留在 ASTORE,什么都没改。
索引膨胀:被忽视的另一半
谈 ASTORE 膨胀,多数人只盯着表,索引的膨胀更隐蔽也更伤人。机制:更新会同时在新位置留下索引条目,旧条目同样要等回收;对更新密集表,索引体积可能涨到初始的三倍以上,而索引膨胀的代价是双重的——扫描路径变长,缓存命中率被无关条目稀释。诊断与处置:用系统视图查看索引的尺寸与估算膨胀度,对膨胀严重的索引执行重建(REINDEX),重建会产出紧凑的新索引并瞬时回收旧空间。预防策略与表清理一致:控制长事务、保持清理节奏,更新特别密集的表考虑降低填充因子,给页内更新留余量,减少页分裂。一个数字供参考:某账务系统的账户索引在治理前膨胀到原始体积的三倍二,重建后同查询的缓冲区命中率提升近五个百分点——索引膨胀治的是看不见的性能税。
清理策略的参数化思考
清理线程的工作节奏可以按表定制,交付里值得为不同形态的表配置不同策略:交易主表更新频繁但行数可控,清理可以激进一些,代价是清理占用的资源多一点;历史归档表只插入不更新,清理几乎无事可做,保持默认即可;中间结果表生命周期以小时计,干脆在批次结尾直接删除重建,连清理都省了。给表单独设定清理参数的能力,让"一套参数伺候全库"的粗放模式成为过去。配置后仍要回到监控验证:死元组比率曲线是否被压平,清理线程的资源占用是否在可接受区间——参数只是手段,曲线才是验收。
案例对照:同一张表的两种命运
用一个双线案例把本章的取舍讲得再具体些。两个业务线各有一张状态流转表,结构几乎相同,日更新量都在百万级。甲线留在 ASTORE:配合了严格的清理策略——无长事务、清理参数上调、每周索引重建窗口——运行一年,膨胀曲线被压在窄幅区间,性能平稳。乙线同样留在 ASTORE 但没有治理:长事务时有发生、清理靠默认,半年后索引膨胀到三倍,查询逐步劣化,最后不得不安排一次停机大修。后来乙线新版本重构时把这张表迁到 USTORE,体积曲线走平,清理开销趋近于零。两条线对照的结论不是"USTORE 更好",而是:引擎选择是治理成本的替代品——治理做得好的 ASTORE 可以很稳,治理做不到位的负载,USTORE 是用引擎换治理的捷径。选择之前,先诚实评估你们的治理能力。
膨胀治理的月度体检单
膨胀治理要有体检单,每月跑一遍五个指标:全库死元组比率前十的表(名单变化说明治理有效)、最长事务时长(超过半小时的列入当月治理)、清理线程的资源占用曲线(突然清闲可能是清理失效的信号)、索引膨胀度前十(超过阈值排重建窗口)、表体积的月度增量与业务增长的比值(比值持续大于一说明膨胀在偷偷进行)。五个指标形成一页体检报告,月底例会过一遍。膨胀是慢性病,慢性病的治理靠体检不靠急诊——这份体检单就是处方笺。
本节要点回顾
- 两种哲学:ASTORE 旧版本留在原地等回收,USTORE 旧版本进回滚段、页内原地改;
- 膨胀因果链:更新留旧版本,长事务阻止回收,清理线程只能干瞪眼;
- 死元组比率是仪表盘:dead_ratio 超两成进清理策略清单,先查长事务再调清理;
- USTORE 阈值:更新占比长期超三成再考虑,用三指标对比说话;
- 默认即稳妥:不满足 USTORE 的明确触发条件时,ASTORE 是低风险选择。
行存解决交易负载,但分析聚合与极致热点的写入各有更合身的引擎——下一节看列存与 MOT 内存引擎。