3.2 列存与内存引擎 MOT
3.2 列存与内存引擎 MOT
本节摘要:当负载偏离"通用交易"这个默认假设时,openGauss 提供两种专用引擎:列存引擎把同列数据连续存放,为聚合分析而生;MOT 内存引擎把整表放进内存、用乐观并发控制消除锁等待,为极致热点交易而生。两者都是"特定条件下性能数倍,条件不满足则不如行存"的选择性武器。
为什么通用引擎不够用
行存的页按行组织,是为"取一行改一行"优化的。但两类负载在这个结构里天然别扭:分析查询只要三列却要扫全部五十列,行存被迫把整行读进内存再丢掉大半;热点扣减类交易(秒杀库存、风控计数)每秒上万次冲突在同一批行上,任何基于锁的引擎都要排队。这两种别扭催生了两个专用引擎——它们的实现思路完全不同,但使用纪律相同:先证明负载匹配,再上车。
列存引擎:为聚合而生的布局
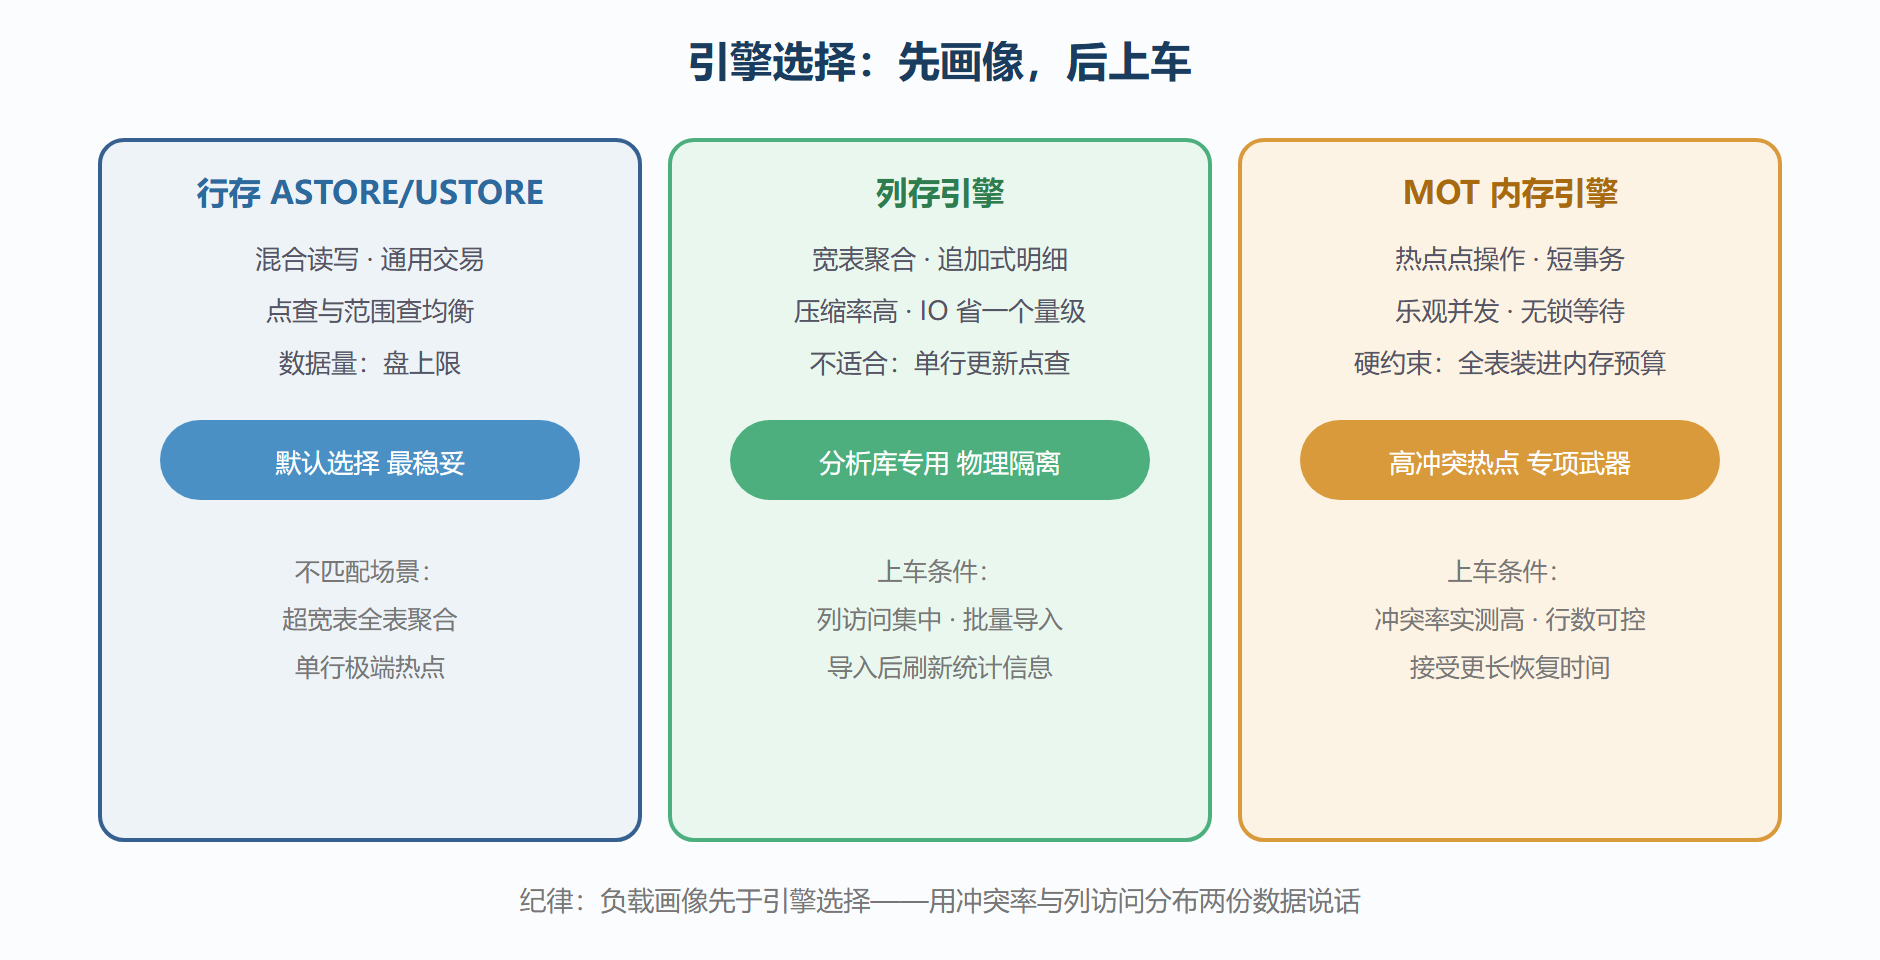
列存把每一列的值连续存放在一起,带来三个连锁收益:扫描三列只读三列的存储段,IO 量直接砍掉;同列数据类型一致、重复度高,压缩率远超行存;聚合函数在连续内存上跑,缓存友好。代价同样明确:单行更新要改多个列段,点查要拼装多列,事务型负载完全不适合。它的典型落点是仓库里的明细宽表:几百列、只追加不更新、每天被十几个聚合查询扫过。建表时用 WITH ORIENTATION 选项声明存储方式:
-- 行存(默认):交易表的标准选择 CREATE TABLE trades_hot ( id bigserial PRIMARY KEY, account_id bigint NOT NULL, amount numeric(16,2), created_at timestamp default now() ); -- 列存:分析明细表的选择,配合追加写入 CREATE TABLE trades_detail ( account_id bigint, branch_code text, amount numeric(16,2), biz_date date ) WITH (ORIENTATION = COLUMN); -- 验证布局:插入后跑一个聚合,观察扫描代价差异 SELECT branch_code, sum(amount) FROM trades_detail GROUP BY branch_code;
交付纪律:列存表放在独立的分析库或至少独立的表空间,与交易负载物理隔离;它的统计信息维护节奏与行存不同,批量导入后必须手动刷新统计,否则优化器对列存的估算会严重失真。
MOT:把热点表搬进内存
MOT(Memory-Optimized Table)的完整逻辑是把表数据常驻内存,配合乐观并发控制:事务先干活、提交时校验冲突,冲突者回滚重试,全程不为读加锁、不为写排队。收益在高冲突热点上是数量级的——同一行每秒数千次更新时,行存的锁队列会变成瓶颈,MOT 的乐观策略反而绕开了排队。它的适用边界同样硬:数据加索引必须整体装进分配的内存预算;适合短事务点操作,长事务和大范围扫描不是它的主场;持久化通过日志与检查点保证,崩溃恢复时间比行存长,主备回放的语义也有差异(第 5 章会回到这点)。
图:三种引擎的负载适配画像
完整演练:一张热点表的引擎迁移
背景:某营销活动系统,库存表一行代表一个秒杀商品,活动开始后每行承受每秒约五千次扣减,行存下锁等待事件占全程三成,接口长尾延迟破秒。操作:第一步实测冲突——按等待事件归类,Lock 等待集中在库存表,画像命中"单行极端热点";第二步评估内存预算——在售 SKU 约八万行,含索引不到一 GB,远低于内存预算;第三步建 MOT 表迁移数据,改造写入代码为短事务(扣减即提交,不跨表长事务);第四步压测对比:同口径下每秒成交从四千提升到两万六,长尾延迟回到五十毫秒内。解读:收益来自两个来源——内存访问省掉缓冲区查找,乐观并发省掉锁排队;其中后者才是量级差异的主因。变式:如果 SKU 涨到两千万行装不进内存,正确姿势不是硬迁,而是把库存按仓库水平拆分降低单行冲突密度,MOT 只装真正的爆点 SKU。
混合布局:一张表的两面人生
交易与分析并存的大表,还可以走"冷热分离加双布局"的路线:热数据用行存承接交易,历史数据按月滚动迁入列存表承接分析,中间用定时任务搬运。这条路线的要点有三个:搬运任务要幂等(重复执行不产生重复数据),用日期边界做幂等键;搬运窗口错峰并限速,避免变成第二个"批处理尾巴"(7.4 案例二的教训);查询侧用视图或应用层路由把两段数据拼给分析方,语法上维持一张表的幻觉。某运营分析平台的订单表按此改造后,交易侧不受分析影响,分析侧扫描的 IO 下降一个量级,而整套改动没有动一行交易代码。对比一下直接把交易表转列存的做法——那等于让交易负载去忍受列存的点查短板,本末倒置。
MOT 演练的观察指标清单
决定评估 MOT 时,压测观察这五个指标:吞吐对比(同负载下每秒事务数的变化倍数,低于三倍通常不值得迁移)、长尾延迟(乐观并发在高冲突下会把冲突者打回重试,看响应时间分布的尾部是否恶化)、重试率(冲突回滚占总事务的比例,超过一成说明负载冲突密度超出乐观策略的舒适区)、内存水位(表加索引的常驻体积留三成以上余量)、故障恢复时长(重启后数据可用的时间,与业务容忍度对照)。五个指标里有三个不达标,就回到引擎选型重新讨论——MOT 是尖刀不是锤子,用对场景才锋利。
一张决策流程卡:新表建什么引擎
把三节内容收敛成一张决策卡,建新表时走一遍。第一步问负载:以单行增删改为主、有事务一致性要求——进行存分支;以追加与聚合分析为主——进列存分支;以高冲突热点点操作为主——进 MOT 评估分支。第二步做验证:行存默认即可,列存先在测试环境验证压缩与扫描收益,MOT 先核内存预算与冲突率实测。第三步定配套:列存定统计刷新与导入节奏,MOT 定恢复演练与监控项,行存定清理策略。三步走完,引擎选择的依据就写进了交付文档,而不是留在一个"当时说好"的口头共识里。这张卡的价值在于把选择过程显式化——评审时别人问"为什么用这个引擎",你指着卡上三步回答。
列存与行存的统计维护差异
混用两种引擎的库,统计维护要分开定策略,这是最容易踩的暗坑。行存的自动收集阈值与采样策略针对交易负载设计;列存的批量导入模式会让变更比例瞬间跨过阈值,但导入过程中收集到的统计与导入完成后的真实分布可能仍有偏差。因此列存表的规范是:每次批量导入完成后手动刷新一次统计,并在导入窗口的变更单里写明这一步——它不是可选项。另有直方图的差异:分析查询的过滤条件多样,列存表建议对高频过滤列建更细的直方图,让优化器对聚合规模有准确预估。一套报表系统改造时曾因漏掉这步,聚合查询计划全表扫描,补齐统计后回到秒级——统计维护这种"看不见的运维",正是混合引擎环境里最值钱的纪律。
上线后的引擎健康巡检
引擎用起来之后,巡检清单按引擎分列。行存巡检:死元组比率、清理线程的节奏、索引膨胀度。列存巡检:导入后统计是否刷新(比对最近收集时间与最近导入时间)、压缩率是否稳定(突降可能暗示数据形态变化)、聚合查询的计划是否仍走列扫描。MOT 巡检:内存水位线、重试率曲线、与预算的余量。三列巡检合并进 7.2 的日常检查脚本,各输出一行状态——多引擎环境的巡检就这么从"感觉上还行"变成三行明确的绿灯或红灯。巡检的意义从来不是发现问题本身,而是把"引擎选型时的承诺"变成"运行中的持续验证"。
本节要点回顾
- 专用引擎的前提是负载画像:列访问集中看列存,冲突率实测高看 MOT,其余回行存;
- 列存三收益:按列裁剪 IO、高压缩、聚合缓存友好;一条纪律:导入后必须刷新统计;
- MOT 两条件:全表装进内存预算、负载以短事务点操作为主;
- 持久化差异:MOT 恢复更慢、主备语义有差异,上重要系统前先在第 5 章框架下做切换演练;
- 别为一个百分点迁引擎:引擎迁移是结构性变更,收益要数量级才值得。
引擎解决了"数据放在哪",下一节解决"并发怎么共存"——MVCC 版本链与可见性判断,全册最重要的一节。