3.4 锁、等待与死锁排障
3.4 锁、等待与死锁排障
本节摘要:MVCC 让读写共存,但写写冲突仍要靠锁仲裁:表锁定意图,行锁定数据,参数决定等多久、死锁时牺牲谁。本节给出一套死锁日志解读法与一张锁排查路径图,外加锁粒度选择的工程权衡。
排障现场:一个"随机消失"的更新
某库存接口每天随机报几次"操作超时",日志里只看到应用侧抛异常,数据库侧风平浪静。老手的第一反应不是查网络,而是查锁:这种"偶发、集中在少数行、超时而非报错"的特征,八成是两个业务路径以不同顺序更新同一组行,撞出等待或死锁。本节的目标,就是让你在下一次遇到时,能从症状直接推到这个假设,再用视图与日志证实。
锁的层级:意图在上、数据在下
openGauss 的锁分两个层面。表级锁表达"意图":做行更新前先在表上拿行级意图锁,挡住的是 DDL(有人改表结构时不能同时有人改行)、全表操作这类方向性冲突;行级锁表达"所有权":更新某行即持有该行锁直至事务结束,第二个更新者排队等待。等待行为由两个参数塑造:lock_timeout 决定等不到时多久放弃,deadlock_timeout 决定检测死锁的灵敏度。两句会话验证等待:
-- 会话一:持有行锁 BEGIN; UPDATE accounts SET balance = balance - 100 WHERE id = 1; -- 会话二:默认无限等待,或先设等待上限 SET lock_timeout = '3s'; UPDATE accounts SET balance = balance - 100 WHERE id = 1; -- 3 秒后报等待超时 -- 任何会话:实时看谁在等谁 SELECT locked.pid AS waiter, blocking.pid AS blocker, left(blocking.query, 50) AS blocker_sql FROM pg_stat_activity locked JOIN pg_blocking_pids(locked.pid) AS bpid ON true JOIN pg_stat_activity blocking ON blocking.pid = bpid[1];
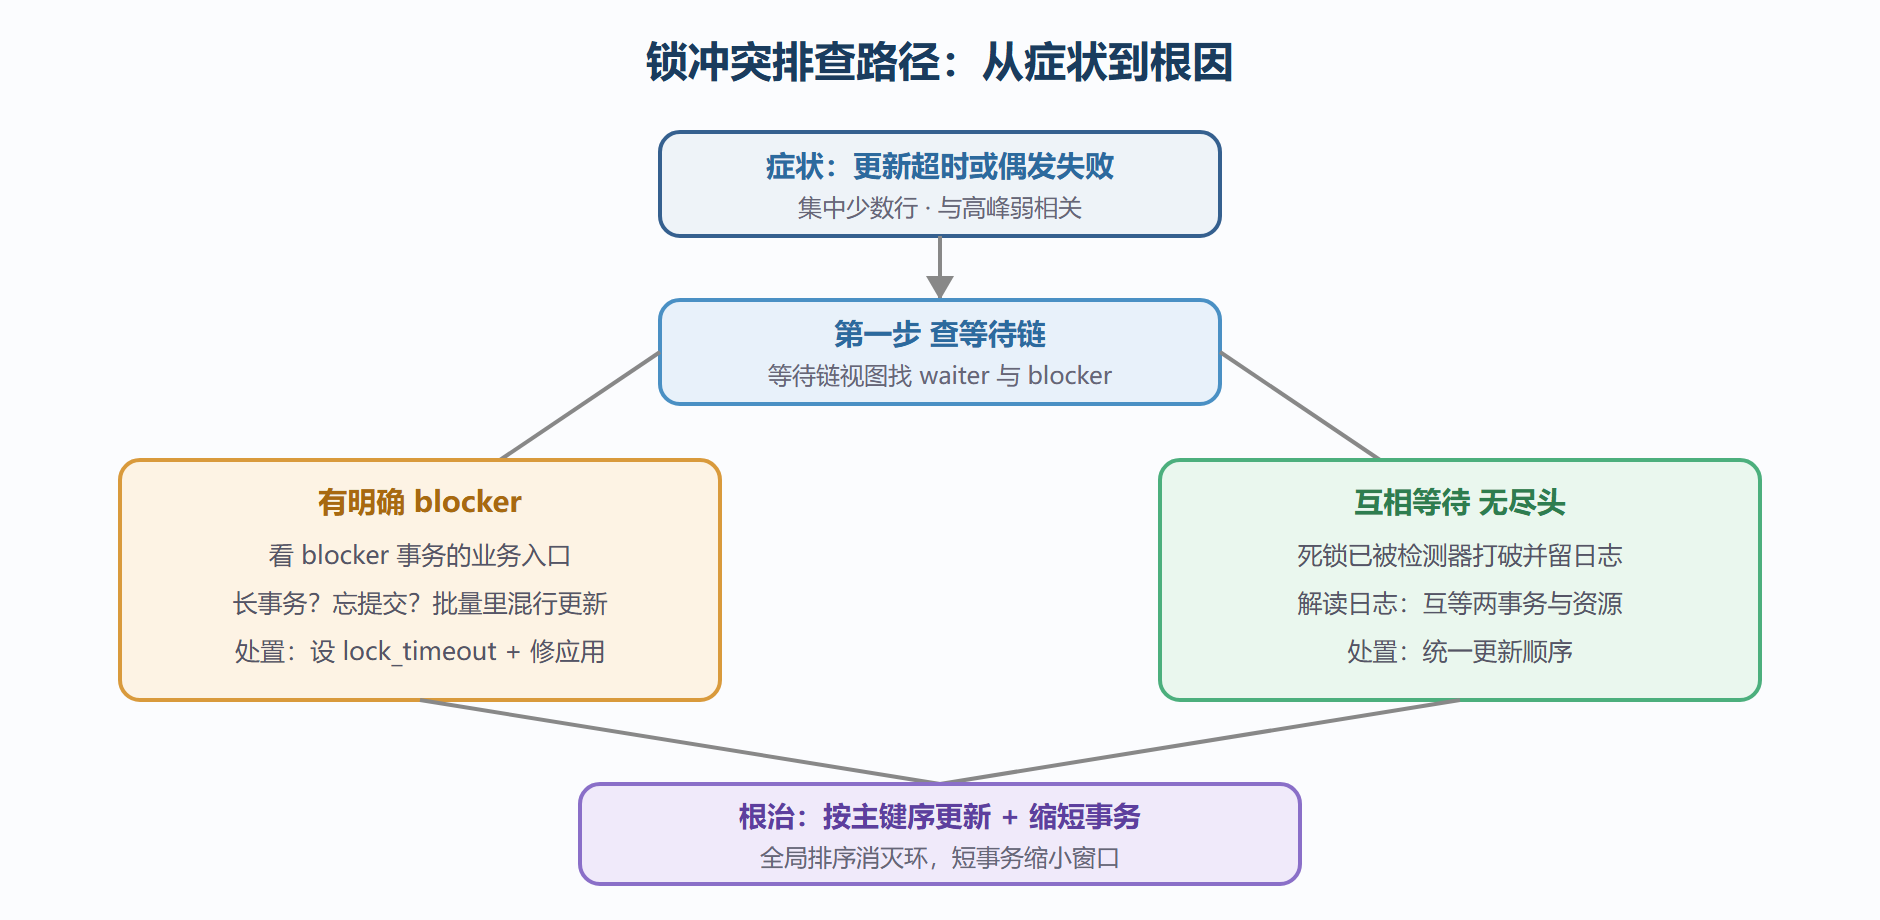
那张"谁在等谁"的查询是锁排障的瑞士军刀:waiter 是受害者,blocker_sql 里的语句通常指向持有事务的业务入口,顺着应用日志一查一个准。
图:锁冲突排查路径图
死锁日志解读法:三问定位
死锁检测器打破僵局时,日志里会留下完整证据链。解读只问三个问题。第一问:两个事务分别是谁?日志按进程号列出双方,对照应用日志找到对应请求。第二问:争夺的是哪行哪锁?日志给出对象与模式,通常是同一张表的相邻行。第三问:谁被牺牲?被回滚的一方在日志里有明确标记,应用侧会收到错误并重试。真实案例:对账任务每晚与交易接口相撞,日志显示对账按账户号升序更新,交易按"转出再转入"更新——当转出账户号大于转入账户号时顺序正好相反,构成环。修法极简:交易的更新顺序改为按账户号统一升序,环从根上消失,死锁告警清零。这就是锁排障的常见结局:改动在应用一行代码,收益在数据库零冲突。
粒度与策略:锁的工程权衡
锁越细并发越高、管理开销越大,这是永恒的权衡。openGauss 默认行级锁已覆盖绝大多数场景,需要人工决策的其实只有三处。其一,批量作业:大量行更新放进一个大事务,会长时间持有海量行锁,正确姿势是分批提交,每批几千行,批间提交释放锁与日志压力。其二,DDL 窗口:改表结构拿的是高等级表锁,生产环境务必带超时执行并放低峰窗口,避免 DDL 在锁队列里堵住后续所有查询。其三,应用侧等待策略:给所有写接口统一配置 lock_timeout 与失败重试,宁可快速失败也不无限排队——无界等待是连接池被拖垮的常见起点。
深入一层:等待队列里的公平与插队
锁等待不是简单的先到先得。共享类操作(读)与独占类操作(写)在队列里的互动有一套仲裁规则,理解它能解释一类怪现象:为什么有时候读查询"插队"成功,有时候又集体排队。机制要点:当一条写操作在队列里等待时,排在它后面的同类写操作会排队,但规则上要防止读操作无限插队让写者饿死,反之也要防止写者堵塞大量只读业务。对运维的启示:看到"读多写少的系统偶发读延迟",先查等待队列里有没有长时间等待的写操作——它可能是整条队列变慢的队头。诊断时把等待链完整画出来(谁堵谁、各等了多久),队头往往一目了然。
应用侧的锁卫生清单
数据库侧的参数与诊断讲完了,锁问题的另一半责任在应用代码。给开发团队的锁卫生清单,建议纳入代码评审:事务要短——BEGIN 与 COMMIT 之间不放远程调用、不放人工确认逻辑;更新顺序要全局一致——所有写路径按同一排序规则访问表与行;批量要分批——大事务拆成可控批次,批间提交;重试要有界——锁超时后的重试带退避与上限,防止风暴式重试;兜底要熔断——热点资源的操作加队列上限,超出即快速失败并告警。这份清单的价值在于前置:评审阶段十分钟的合作检查,抵得上生产环境十小时的死锁日志分析。某支付团队的实践是把清单做成了提交钩子里的静态检查项,锁类生产事件从月均七起降到季度一起。
现场问答三则
问答一:"我们把 lock_timeout 设成一秒,为什么应用还是偶发超时堆积?"——查两件事:超时后的重试有没有退避与上限,无界重试会把一秒的等待放大成无限循环;再查等待链的源头是不是一个跑几十分钟的批事务,若是,一秒超时只是让受害者快速失败,根因还在批任务。问答二:"死锁检测会不会误伤正常业务?"——检测只针对真正成环的等待,触发即说明环存在,误伤的命题不成立;要调的只是检测灵敏度与业务重试体验的平衡。问答三:"把隔离级别改成串行化是不是就没有锁问题了?"——恰恰相反,可串行化会主动制造更多冲突失败来换取严格语义,应用没有完善的重试机制时,故障率不降反升。三则问答覆盖了锁话题里最高频的三次误判,转述给开发团队可省掉大量来回。
表级锁风暴:DDL 与长查询的相遇
行锁讲透了,还有一类表级锁风暴值得单独预警。场景:一条跑四十分钟的报表查询持有表上的共享锁,期间一条加列的 DDL 进来请求排他锁,排他锁要等共享锁释放;更糟的是,排他锁等待期间,所有新进来的普通查询都要排在它后面——整张表的查询从 DDL 到达那一刻起集体阻塞。这条"DDL 被长查询卡住、新查询被 DDL 卡住"的双层队列,是生产环境最经典的锁风暴。预防三板斧:DDL 一律带锁等待超时,等不到快速失败改窗口再执行;长报表挪到备机或专用查询库,从物理上避开与 DDL 共享主库锁队列;变更窗口与报表高峰错开并在变更单里互相知会。处置方法也要记住:发现全表查询卡住,先查等待链头部是不是一条等锁的 DDL,杀掉它(或让它超时退出),队列立刻疏通——顺序反了,杀多少查询都没用。
锁监控的三个口径
把锁监控固化为三个口径,值班看一眼就能定级。口径一,当前等待数:正在等锁的会话个数,零到个位数属正常波动,持续两位数要介入。口径二,最长等待时长:队头等了多久,超过应用超时阈值意味着开始产生失败,这是升级的信号。口径三,锁风暴频次:每天死锁与超时的总数趋势,周环比上升说明业务在长出新冲突点。三个口径各配一条告警线,数值从基线观察一周后定。锁监控与 7.2 的仪表盘对接时,注意口径二最有信息量——等待数多而等待时长短,是健康的繁忙;等待数少但等待时长长,是病态的堵塞。数字要看组合,不看单点。
本节要点回顾
- 两层锁:表锁管意图挡 DDL,行锁管数据所有权,多数冲突发生在行锁;
- 两个参数:lock_timeout 定放弃时限,deadlock_timeout 定检测灵敏度;
- 排查三板斧:等待链视图找 blocker、死锁日志三问、应用日志对入口;
- 根治靠顺序:全局统一的更新顺序消灭环,比任何参数调优都有效;
- 批量要分批:大事务既放大锁也放大日志压力,分批提交是标准姿势。
单节点的锁治好了,跨节点的写一致性还悬着——下一节看两阶段提交如何让分布式事务要么全成、要么全不成。