3.5 两阶段提交与分布式事务
3.5 两阶段提交与分布式事务
本节摘要:一笔更新跨越多个数据节点时,"要么全成、要么全不成"靠两阶段提交保证:先集体表决、再集体执行。它买来了原子性,也带来了提交延迟、协调点状态与悬挂事务三个新课题。集中式用户理解原理即可,分布式形态的运维者必须吃透。
为什么单机经验到了分布式会失灵
单机上,事务提交就是日志落盘一个动作,原子性天然成立——日志是唯一裁决者。分布式形态里,一笔跨行转账的两个账户可能落在两个数据节点上,任何"先提交 A 再提交 B"的顺序写法都可能在中间崩溃,留下"扣了钱没到账"的半成品。两阶段提交(2PC)的解法是把提交拆成两拍:第一拍问所有参与者"能否提交",全员同意后进入预备状态;第二拍由协调者统一宣布提交或回滚。裁决点从"日志落盘"变成"协调者的第二拍决定",原子性由此保住。
协议长什么样:一次跨节点转账的完整时序
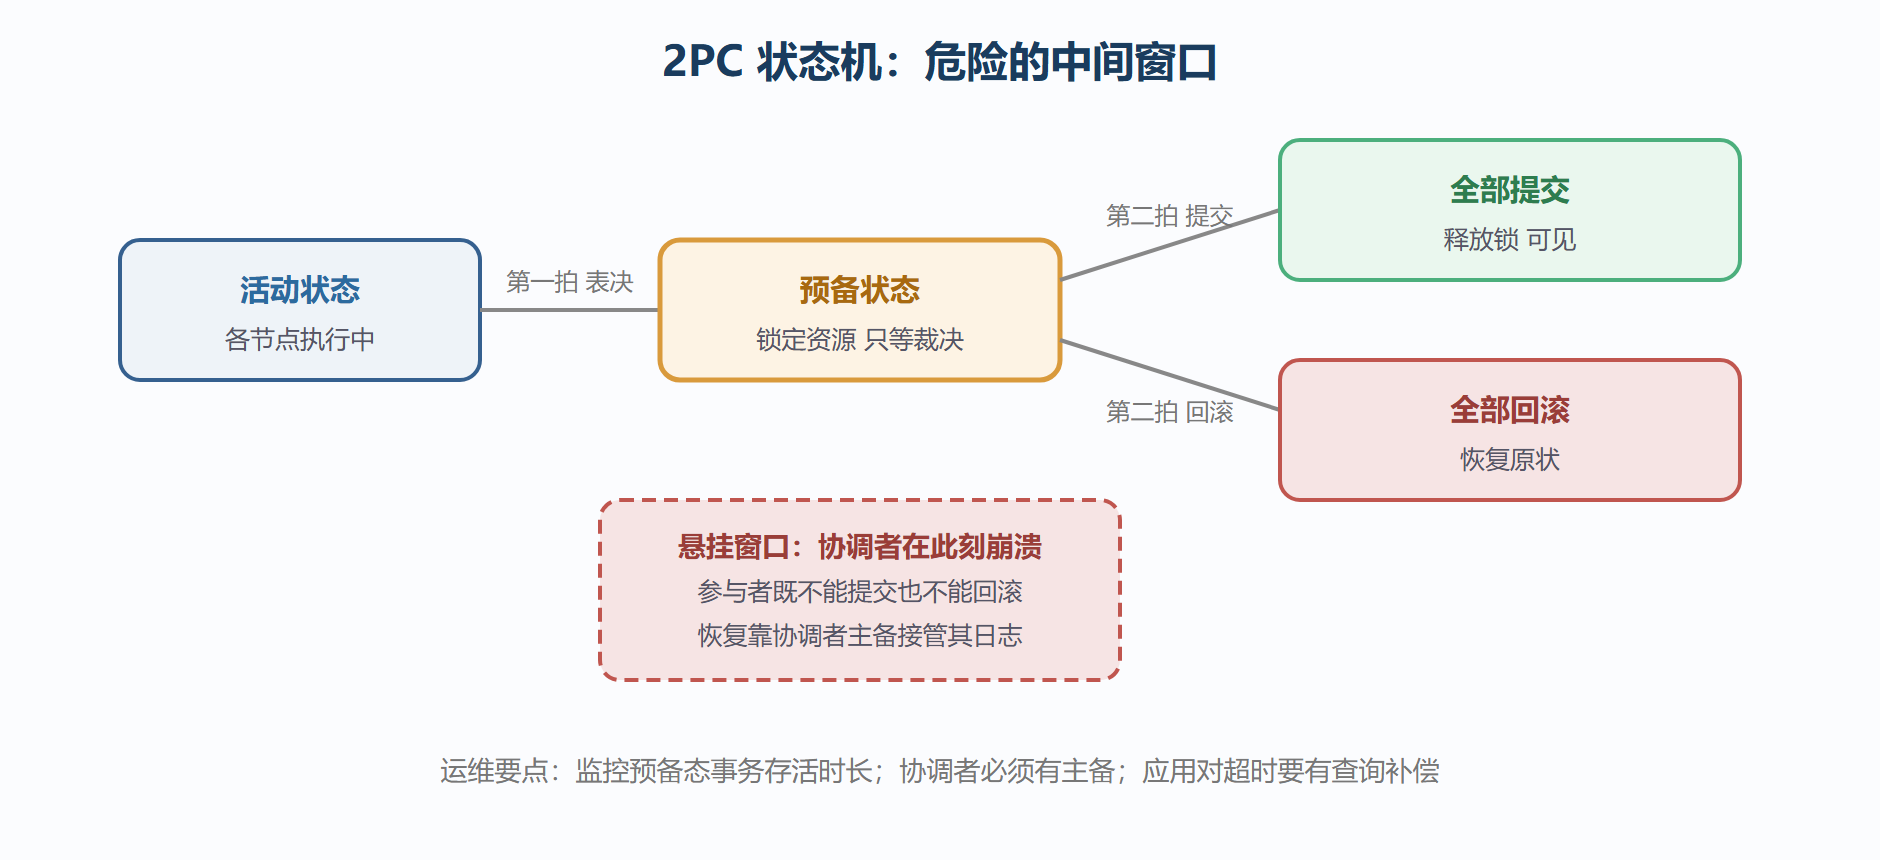
两个细节值得咀嚼。第一拍之后、第二拍之前,两个节点上的事务都处于"预备"状态:资源已锁定、结果已落日志,只等发落。这个窗口是 2PC 全部麻烦的来源——若协调者此刻崩溃,参与者既不能提交也不能回滚,只能挂起等待,这就是悬挂事务。第二拍的决定一旦写入协调者日志,结果就不可更改,后续只是执行的问题。因此 2PC 的可用性下限取决于协调者日志的可靠性,这正是生产部署里协调节点也要做主备的原因。
图:两阶段提交的状态机与悬挂窗口
运维三课题:延迟、悬挂、补偿
提交延迟。两阶段意味着至少两轮网络往返加两次日志落盘,跨节点事务的提交延迟明显高于单机事务。实践口径:把跨节点事务比例控制住——表设计时按访问亲和性分布数据,让绝大多数事务落在单节点内,2PC 只服务少数跨节点写入。
悬挂事务。预备态事务卡住的应急路径:先确认协调者是否真的故障(有时只是网络抖动),协调者主备切换完成后悬挂事务自动收尾;若协调者确认失联且短期无法恢复,由管理员按业务语义逐个裁决提交或回滚——这一步必须有业务方签字,因为数据库只知道原子性,不知道"这笔钱该不该扣"。
应用侧补偿。分布式事务失败率不为零,应用必须设计补偿逻辑:提交超时后先查询最终状态(订单是否生效),按状态决定重试或回滚业务动作;重试要带幂等键,防止补偿本身制造重复。一个真实案例:某支付平台切换分布式库后,偶发提交超时引发重复出账——根因是应用把"超时"当"失败"立即重试,而第一笔实际已提交。改为超时后先查再动,问题清零。这条经验的价值超出 2PC 本身:所有分布式系统里,"超时不等于失败"都是铁律。
与集中式的对照:什么规模才需要它
回到形态选择的老话题:2PC 的全部复杂度,换来的是跨节点写原子性。若你的系统百分之九十九的事务都在单节点内,集中式主备依然是最优解;只有当数据分布本身是需求(多地域写入、单表体量超限)时,2PC 才是一笔划算的买卖。评估时量化两个数:跨节点事务占比(超过一成就要认真优化数据分布)、单笔跨节点事务的提交延迟增幅(通常三到五倍)。两个数都在红线内,分布式才上路。
与主备复制的叠加:双保障的代价核算
分布式形态下,每个数据节点内部还有主备复制,两套机制叠加后的提交路径值得算一笔账:一笔跨节点事务要经过两阶段提交的两轮协调,每个节点的提交又要等各自备机的日志确认(同步复制时),端到端的提交延迟是多重等待的串联。数字化的例子:单节点本地提交延迟两毫秒,叠加上行链路后跨节点事务可能到十毫秒以上——五倍差距在多数业务可接受,但高频交易类场景要提前测算。核算的方法论比数字重要:把提交路径拆成"协调轮次乘网络延迟加日志落盘"的算式,每一项用你们的实测值代入,得出的是自己环境的真实预期,而不是文档上的理想值。这笔记完,2.3 节"量化再上车"的判断就有了完整的数据支撑。
演练课:手动制造一次悬挂并收尾
2PC 的应急能力必须演练出来。剧本:测试环境搭两节点分布式,开一个跨节点事务走到预备态,然后人为中断协调者进程,观察两节点上的预备态事务——它们会挂起等待。恢复收尾三步:第一步,确认协调者的日志文件完好(这是裁决的原始依据);第二步,重启协调者,观察它按日志完成第二拍、悬挂事务自动收尾;第三步,模拟日志损坏的极端情况,按管理员逐个裁决的流程手工提交与回滚各一例,验证操作手册的每个命令。这套演练做完,团队对"悬挂"这个词的恐惧会降到可控水平——它从传说中的事故,变成有脚本、有手册、有负责人的标准场景。分布式运维的信心,都是这样一次次演练喂出来的。
一致性读的边界:跨节点查询的快照难题
写的一致性讲完了,读的一致性还有一层:跨节点的同一时刻快照怎么取。单节点内快照天然统一,跨节点查询要保证"所有节点用同一参考点",这需要全局事务管理器维护统一的时钟或版本戳。理解这一层的意义在排障:分布式形态下偶发的"查询结果看起来新旧混杂",多数不是数据坏了,而是跨节点快照边界没对齐的特殊场景或配置问题。应用侧的防御与单机一致:一致性敏感的读放进显式事务;监控侧的防御是关注全局事务管理器的健康指标——它是分布式一致性读的心脏,它的延迟会直接体现在跨节点查询的响应时间上。集中式用户把这节当原理拓展读,分布式用户把它当必修课读。
分片键设计:从源头减少跨节点事务
2PC 的事务量能不能降下来,答案在设计期的分片键选择上。三条设计经验:分片键优先选"事务的天然边界"——订单系统的用户号、账务系统的账户号,让一笔事务涉及的行尽量落在同一节点;避免用时间或递增序列做分片键,它们会把写入压力集中到最后一个分片,制造人为热点;对"全局小表"(字典、配置类)采用全节点冗余,免去每个事务对它们的跨节点关联。分片键一旦选定,后期更改的代价是全量数据重分布——这个决定的不可逆性,值得在设计评审会上用整整一个议题来讨论。判断分片键选得好不好,只看一个运行指标:跨节点事务占比。上线后持续观察这个数字,超过一成就要回头审视数据分布设计,而不是简单地优化 2PC 本身。
运维视角的一页对照表
把 2PC 的运维要点压成一页对照表。正常态看三个数:跨节点事务占比、平均提交延迟增幅、悬挂事务存量(正常为零)。异常态查三处:提交延迟突增先查协调者与各节点间的网络质量,再查参与者日志盘的写入延迟;悬挂事务出现先查协调者进程与主备状态,再查最近一次的网络闪断记录;回滚率上升先查应用的事务边界是否膨胀(把远程调用裹进了事务),再查分片键设计是否失衡。每条异常路径的第一步都是"看数、定位层级",最后一步都落到"网络、日志盘、应用边界"三个常见嫌疑人。这张表配合前面的状态机图使用:图管理解,表管行动。
本节要点回顾
- 两拍协议:先表决后裁决,原子性从"日志落盘"移交到"协调者第二拍";
- 预备态是双刃剑:锁定资源保证原子,也制造悬挂窗口;
- 协调者可靠性是下限:协调节点必须主备,其日志就是裁决记录;
- 应用三条纪律:超时先查再动、重试带幂等键、失败有补偿;
- 量化再上车:跨节点事务占比与延迟增幅两个指标说了算。
存储与并发的地基到此打完。第 4 章转入 SQL 引擎:一条查询是怎么被解析、被规划、被执行的。