1.1 发展历程与版本演进
1.1 发展历程与版本演进
本节摘要:Oracle 的版本史不是年表,而是一部"企业级需求倒逼内核演进"的因果史。本节沿 1979 年第一个商用关系库到 23ai 的时间线,讲清每个关键版本在解决什么矛盾、留下什么遗产;结尾用一次真实的 11g 升 19c 评估,演示怎么把版本知识兑换成升级决策。
一、版本史为什么值得读
1977 年,Larry Ellison 与两位合伙人在加州成立软件开发实验室,两年后拿出 Oracle V2——世界上第一个商用关系型数据库。那时它靠的是一篇论文(Codd 的关系模型)和一句赌注:企业迟早需要用统一语言管理数据。四十六年过去,这家公司的版本号从 V2 走到 23ai,每一代都在回答同一个问题:上一代没能兜住的那类故障、那类负载、那类法规,怎么兜住?
读版本史的意义在于:你今天运维的每一个机制,都能在某个版本节点上找到它诞生的理由。RAC 为什么长成那样?因为 2001 年前后企业开始要求"硬件坏了业务不停"。多租户为什么出现?因为 2010 年代云厂商发现一千个客户一千套实例根本管不过来。看懂因果,参数和特性就不再是需要死记的孤立知识点。
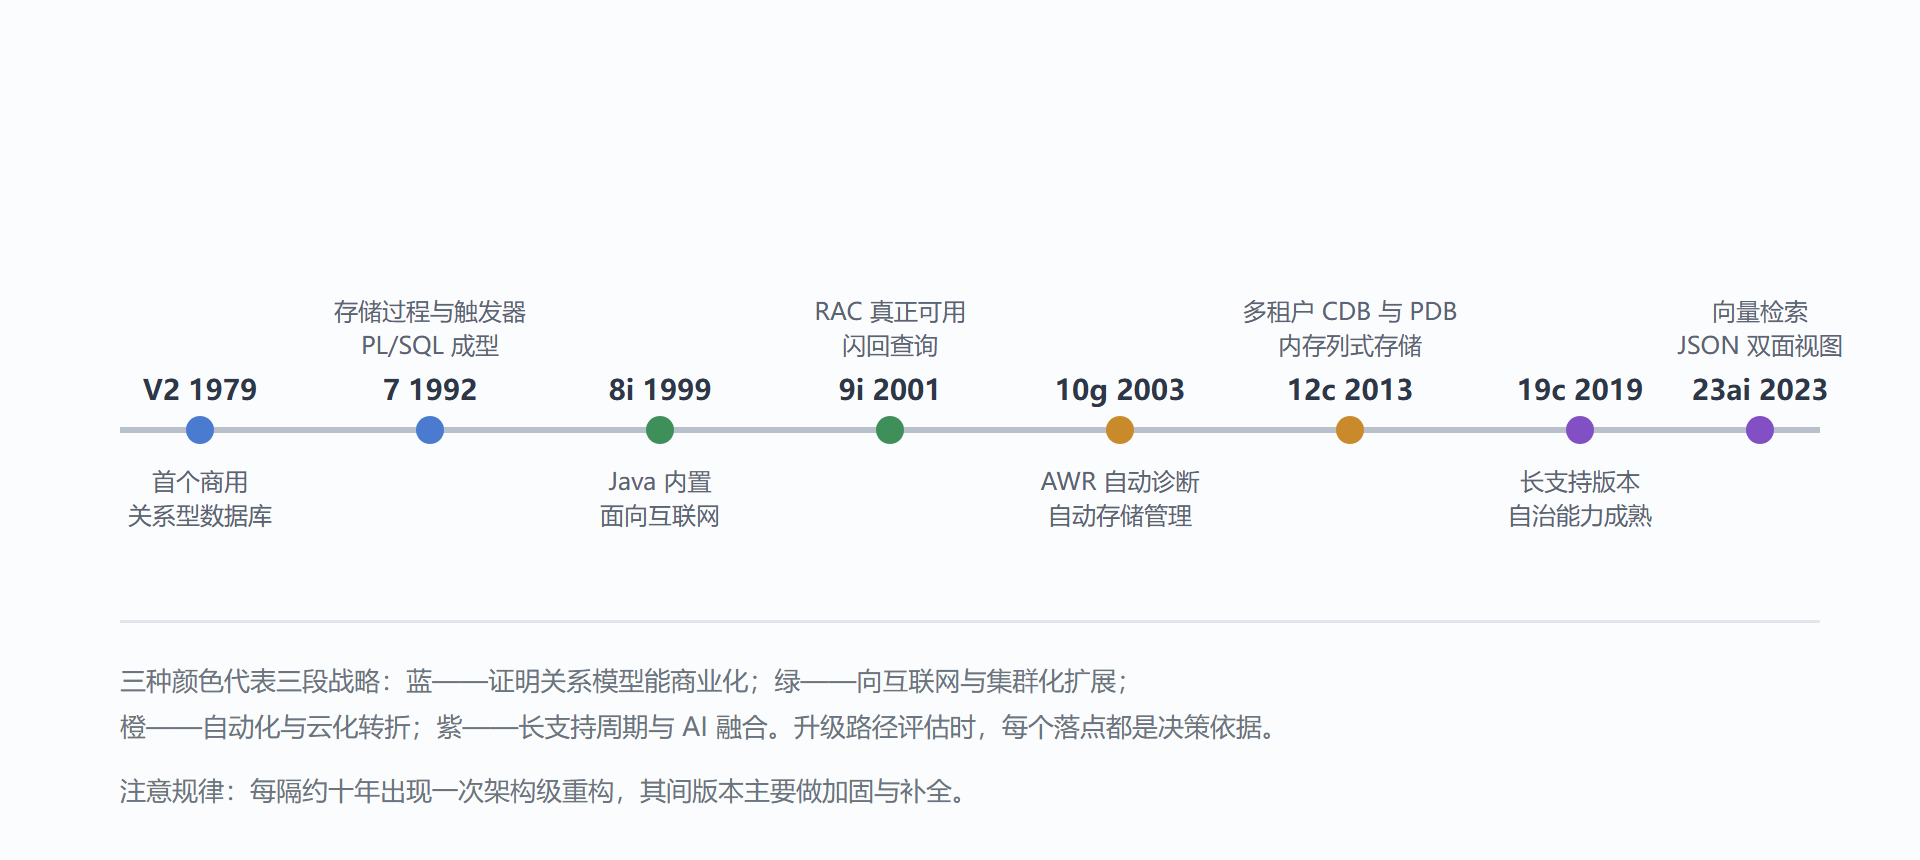
图 1-1:Oracle 版本演进时间线与关键能力落点
二、五个改变行业格局的版本
Oracle 7(1992):把程序搬进数据库。 此前业务逻辑在客户端,网络一抖数据就不一致。Oracle 7 给出存储过程、触发器、声明式引用完整性,PL/SQL 从此成为数据库内的第一语言。今天你在 DBMS_SCHEDULER 里写的作业、在包里封装的业务规则,源头都在这里。
9i(2001):RAC 从概念变成产品。 早期集群方案是"一主多备热切换",切换要分钟级。9i 的 RAC 让多个实例同时挂载同一套数据库,节点故障时连接漂移到幸存节点,业务感知以秒计。配套的闪回查询(Flashback Query)把"误删数据"从恢复灾难降级成一条 AS OF 子句。
10g(2003):数据库学会自我观察。 AWR(自动工作负载仓库)、ASSM、自动诊断仓库都在这一代落地。此前性能诊断靠 DBA 手工采样 v$ 视图,10g 之后内核每小时自动拍快照,问题回溯有了时间机器。第 6 章读 AWR 报告的功夫,地基是这一版打的。
12c(2013):多租户与内存双引擎。 CDB/PDB 架构把"一个实例服务多个独立库"做成了内核能力,是后续云化战略的地基;12.1.0.2 引入 In-Memory 列式存储,同一库内同时服务 OLTP 与实时分析,HTAP 的雏形。
19c 与 23ai:稳定期与新战场。 19c 是长支持版本(Premier Support 延至 2029 年后),绝大多数存量生产库停在或正在升往这里。23ai 把向量检索、JSON 双面视图、图分析塞进同一内核,赌的是 AI 时代数据不必搬出数据库。
三、案例:一份升级评估的完整过程
背景。 某省医保结算系统停在 11.2.0.4,2023 年原厂扩展支持到期,续费报价翻倍。CIO 要求三个月内给出"升级还是硬扛"的结论。
操作。 评估分四步。第一步盘资产:查版本与组件启用情况。
-- 确认版本与补丁级别(升级窗口规划的第一张底牌) SELECT banner FROM v$version; -- 检查哪些付费组件在用,直接决定目标版本选型 SELECT comp_name, version, status FROM dba_registry ORDER BY comp_name; -- 统计无效对象与自定义代码量,估算回归测试面 SELECT object_type, COUNT(*) FROM dba_objects WHERE status = 'INVALID' GROUP BY object_type;
第二步定目标:11.2.0.4 没有直达 19c 的原地升级路径吗?有——通过 Data Pump 逻辑迁移或升级工具链都能走,但该系统用了大量物化视图和自定义类型,逻辑迁移要重建的对象上千个,最终选定"新装 19c 实例 + Data Pump 全量迁移 + 应用双跑比对"的路线。第三步排时间:双跑两周,按业务低谷分四批切换。第四步定回退线:保留旧库只读两周,任何数据对不上即刻切回。
结果。 迁移窗口内完成,结算延迟从峰值 4.2 秒降到 1.6 秒——19c 的优化器改进和统计信息策略白送了一轮性能收益。解读。 这单子的关键不是技术,是版本知识变成了排期依据:知道 11.2 无法原地直升、知道扩展支持的时间表,才能提前一年谈预算。变式。 如果系统用了 11g 独有的废弃特性(如基本不再维护的旧式复制),评估结论会完全不同——先重构再迁移,时间成本翻倍。所以升级评估第一步永远是查 dba_registry,而不是先问预算。
四、版本策略对你的实际约束
Oracle 现行策略是"年度版本 + 长支持版本"双轨:21c、23ai 这类年度版只支持两年左右,生产环境几乎不用;19c、未来 21c 之后的下一个长支持版才是产线常客。这决定了两件事:一是新特性从发布到"可以放心用"普遍隔着五到八年,23ai 的向量检索在核心交易库普及要到本年代末;二是升级窗口的选择余地比想象中大——从长支持版到下一个长支持版,一次升级可以吃十年的稳定性收益,这正是"停在 19c"成为行业默认策略的原因。
五、常见问题
⚠️ 常见坑:把"最新版本"当成"最稳版本"。某金融客户在 21c 发布半年后直接上产线,两年后被强行迁回 19c——年度版本的扩展支持条款和补丁密度都不适合核心系统。生产选型只看长支持版。
问题一:现在接手的项目应该基于哪个版本开发? 默认答案只有一个:最新的长支持版本。年度版本(如 23ai)适合尝鲜验证与非关键场景,但它两年的支持窗口意味着你的生产库很快要再升级一次——升级是真实成本,别为尝鲜买它。
问题二:升级工具链怎么选? 按停机窗口与数据量定:可接受小时级停机的中小库直接用升级工具原地升级;要求近零停机的大库走"新环境搭好、Data Guard 同步、切换收割"的物理路径;涉及平台或字符集变更的,只能 Data Pump 逻辑迁移。三条路径的成本差一个量级,选错路径是升级项目超期的头号原因。
问题三:补丁(RU)要不要追最新? 生产节奏建议每季度到半年吃一次发布更新:既积累关键修复,又避免跨太远一次吃成"大版本"。补丁前必看已知问题清单,冲突项与你的组件清单(1.1 案例第一步的 dba_registry)交叉核对——补丁事故多数源于组件重叠,而不是补丁本身。补丁窗口同样要有回退方案:数据补丁(datapatch)失败的处理路径要在变更单里预演,别把第一次当作练习。
本节要点回顾
- 版本史是因果链:RAC 源于不停机需求,多租户源于云托管密度,AWR 源于手工诊断的低效——记住理由比记住年份有用。
- 五个转折点:Oracle 7 存储过程、9i RAC 与闪回、10g 自动诊断、12c 多租户与内存列存、19c 长支持基线。
- 升级评估四步:盘组件、定路径、排双跑、留回退;第一步永远是查 dba_registry。
- 双轨策略:年度版尝鲜、长支持版产线;新特性到产线普遍隔五到八年。
- 补丁的节奏感:季度到半年吃一次 RU,组件清单与已知问题交叉核对——升级与补丁是同一门纪律的两个节拍。
下一节我们把这套系统的一堆专有名词摊开对齐——实例和数据库到底是不是一回事,这个问题的答案会让你少走很多弯路。