2.3 物理与逻辑存储结构
2.3 物理与逻辑存储结构
本节摘要:磁盘上真正吃饭的家伙是四类文件:数据文件存数据、控制文件记全局地图、在线重做日志记变更流水、归档日志是流水的存档。逻辑侧的区段块决定空间怎么分配与回收。本节沿一次数据文件误删的恢复现场,把物理布局、多路复用与段管理串成一张可按图索骥的地图。
从一块坏盘说起
周五下午,存储阵列报一块盘预故障。换了盘没事,但这件事暴露一个事实:很多接手库的人说不出"这台机器上哪些文件是命根子、丢了哪个还能救"。物理结构知识在平时是屠龙之技,在故障时是唯一线索。本节先把文件家族认全,再讲逻辑结构怎么把空间切给对象,最后用一次误删恢复把两者串起来。
一、文件家族:四类命根子与两位管家
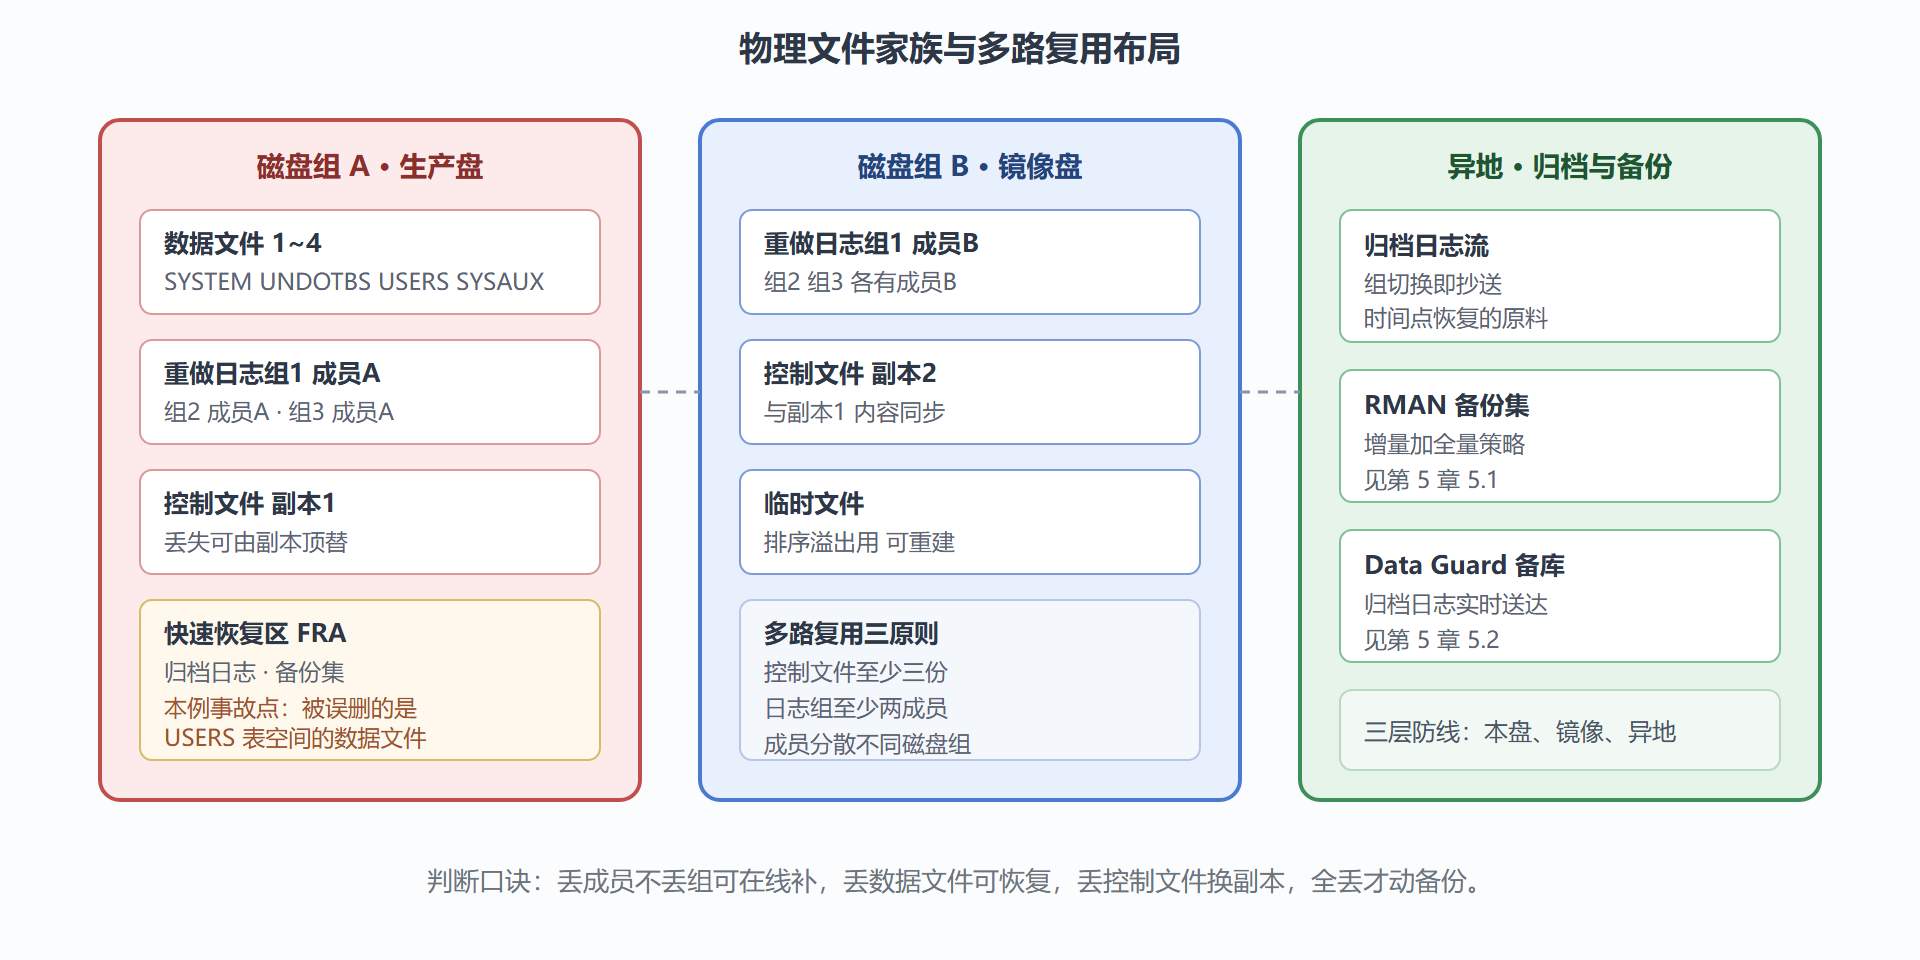
**数据文件(Datafile)**是数据的本体,一个表空间对应一个或多个数据文件。库里 99% 的字节都在这里。**控制文件(Control File)**是全库地图:记录库名、数据文件与日志文件的位置和检查点信息,实例启动时先读它才知道"我有哪些家当、该挂载谁"。它只有几 MB,但损坏就是全库瘫痪——所以多路复用(至少三份放不同磁盘)是强制习惯,丢一份还有备份。**在线重做日志(Online Redo Log)**是变更流水,至少两个组循环使用,每组一到多个成员(成员互为镜像)。**归档日志(Archived Log)**是流水的存档——归档模式下组切换时由 ARCn 抄送保存,时间点恢复与 Data Guard 全靠它。
两位"管家"是参数文件与口令文件:参数文件(spfile,二进制可在线改)记录实例启动的全部配置;口令文件让管理员可以远程以 SYSDBA 登录。它们丢了可以从模板重建,优先级低于四类命根子。
图 2-2:物理文件布局与多路复用防线
二、逻辑结构:空间怎么切给对象
1.2 节给了五层楼的名词,这里讲它的运转。区的分配与回收:段初始按 INITIAL 大小分配区,空间不够再按 NEXT 递增申请;本地管理表空间用位图记录每个区的占用,分配回收都是位图翻转,速度与并发都优于旧的字典管理(如今已绝迹,但老文档里还能见到)。**自动段空间管理(ASSM)**用块内的位图替代自由列表来记录块有没有空位,并发插入时减少了段头的争用——新表空间默认 ASSM,除非你在维护十几年前的老系统,否则不用再操心自由列表。
行迁移与行链接是块层面的两个经典病灶。行更新变长、原块放不下时,整行搬家、原块留一个转发地址,这叫行迁移——查它要多读一个块。一行本来就超过块大小(比如含大字段的行),只能横跨多个块,叫行链接——天生如此,只能调大块或拆表。诊断用 ANALYZE 的 CHAINED_ROWS 或系统视图,治理靠重建表搬迁。查询突然变慢且执行计划没变时,行迁移是要排查的暗病之一。
三、案例:误删数据文件的完整恢复
背景。 运维清理磁盘时误删了 USERS 表空间的数据文件,数据库未重启,应用开始报错。此时没有备份会怎样?有备份又会怎样?
操作。 因为实例还在运行,数据文件句柄仍在内存里,先做无损抢救——把文件从句柄恢复出来:
-- 第一步:确认文件号与状态 SELECT file_id, file_name, online_status FROM dba_data_files WHERE tablespace_name = 'USERS'; -- 第二步:文件被删但句柄存活,直接重命名回原路径(Linux 下先从 proc 文件系统找回) -- 第三步:介质恢复补齐删除期间的重做 RECOVER DATAFILE 7; -- 第四步:确认恢复后联机 ALTER DATABASE DATAFILE 7 ONLINE;
结果。 十五分钟恢复,零数据丢失——前提是归档日志完整。解读。 这套操作能成立,靠的正是本节的两个结构知识:其一,控制文件知道每个数据文件的编号与位置,路径重建有据可依;其二,归档日志保存了完整变更流水,RECOVER 把删除窗口期内的所有变更重演一遍。若归档模式未开,唯一出路是从最近的冷备份恢复并接受数据丢失——两种结局的差距,就是物理结构知识值多少钱。变式。 若丢的是 SYSTEM 表空间文件,就地恢复失败则需整套备份还原加实例恢复,属于重大事故流程;若丢的是临时文件,直接重建即可——文件类型决定处置等级,背下这个等级表是本节的隐性目标。
四、日常巡检里怎么用这张地图
物理与逻辑结构的知识最终要落进巡检脚本,四个动作建议直接抄走。文件清单核对:每月对照控制文件与操作系统的文件清单,发现"库不知道的文件"或"库知道但不存在的文件"都是事故前兆——前者可能是误放的可写目录,后者是恢复演练遗漏的证据。临时文件监控:临时表空间的瞬时占用是排序落盘的直接信号,配置告警线并在触发时回到 2.1 的 PGA 分析。残余空间统计:段删除后空间回到表空间(HWM 以下还有段内碎片),表空间水位高但对象总占用低,就是该做段收缩(shrink)的信号。历史增长曲线:dba_hist 表空间统计每两周拉一次增量速率,容量规划从"拍脑袋"变成"画延长线"。
问题一:ASM 环境这些知识还适用吗? 适用,层次换了位置:ASM 接管了"文件放在哪块盘"的问题,但控制文件多路复用、日志组成员分布、表空间与数据文件的逻辑关系全部照旧。ASM 磁盘组的冗余等级(外部冗余、正常冗余、高冗余)替代了手工多路复用的一部分职责——选了外部冗余就等于声明"存储层已有保护",前提是存储层真的有。
问题二:大文件表空间和小文件表空间怎么选? 大文件(bigfile)表空间只挂一个超大数据文件,管理对象从"文件群"简化为"单个文件",容量上限也高,是现代部署的默认。小文件(smallfile)是历史兼容形态,老系统迁移过来常见。注意大文件表空间的磁盘配额敏感:唯一那个文件所在卷写满,整表空间立刻告急——它对底层卷的监控要求反而更高。
问题三:压缩表空间值不值得开? 按负载分区回答:历史归档类、写完不再改的数据用压缩,节省一半以上的存储且扫描更快;频繁更新的活跃表慎用——每次 DML 的压缩维护成本会吃掉收益。压缩还有一个隐性收益:块内数据更密意味着同样的缓存能装下更多行,读多写少的报表库整体受益。
💡 关键直觉:物理结构的一切设计(多路复用、归档、快速恢复区)都在回答同一个问题——"下一个坏消息来的时候,你手里还有几手牌"。牌是平时发的,故障时现抓来不及。
本节要点回顾
- 四类命根子:数据文件、控制文件、在线重做日志、归档日志;控制文件三份、日志组双成员是最小冗余标准。
- 恢复等级表:临时文件可重建、日志成员可在线补、数据文件走介质恢复、SYSTEM 文件动全套备份。
- ASSM 与位图:现代表空间的区管理靠位图,块内空闲靠位图;字典管理与自由列表只在老系统见。
- 行迁移是暗病:更新变长致整行搬家,查询多读块;诊断看迁移行数,治理靠重建搬迁。
- 巡检四动作:文件清单核对、临时文件监控、残余空间统计、增长曲线预测——把结构知识变成例行检查。
到此,内存、进程、磁盘三层拆完。下一章把镜头对准它们最紧张的协同场景:几百个会话同时改同一张表时,秩序怎么维持。