3.2 并发控制与锁
3.2 并发控制与锁
本节摘要:Oracle 的锁体系是"行锁管冲突、意向锁管层次、队列管公平"的三层结构,读不阻塞写是它最鲜明的性格。本节给出完整的锁粒度矩阵、阻塞链的解套实操,并解剖一次"挂了四小时的锁"的处置全过程。
谁挡住了谁:一次锁等待的解剖
下午三点,客服系统反馈工单保存转圈。查会话,几十个 INSERT 在等一行记录的锁——而持锁的那个会话属于一个上午十点打开的 PL/SQL 调试窗口,工程师回家吃午饭忘了提交。这就是锁问题的标准画像:锁本身没有错,错的是没有边界的事务。要快速处置这类现场,你得知道锁有哪些粒度、等待关系怎么查、以及什么时候该动哪把手术刀。
一、锁的粒度矩阵:三层结构
Oracle 的锁设计哲学是"能锁行就不锁表"。**行级锁(TX)**是主力:DML 只锁它真正改的那些行,改多少行加多少把锁,锁信息直接记在数据块的行头与 UNDO 事务表里,没有传统的中央锁管理器开销——所以 Oracle 的行锁又轻又多,百万行更新就是百万把行锁,仍然轻松。**表级锁(TM)**不是"锁整张表的数据",而是层次的声明:DML 会在表上放一个意向锁,声明"表内有行被锁了";查询放共享意向锁、修改放排他意向锁。意向锁的真正用途是给 DDL 把门:你要 TRUNCATE 一张表,先看表上有没有意向锁,有就说明里面有活跃事务,拒绝执行——没有这层声明,DDL 就得逐行扫描找活锁。
两层配合的互斥关系可以列成一张矩阵:
| 请求方 \ 持有方 | 查询 SELECT | 修改 DML | 表结构 DDL |
|---|---|---|---|
| 查询 SELECT | 共存 | 共存(一致读兜底) | 可能等(看具体 DDL) |
| 修改 DML | 共存 | 同行则等,异行共存 | 互相阻塞 |
| 表结构 DDL | 等待 | 阻塞(被意向锁挡住) | 互斥 |
这张矩阵里最值得圈出来的是右中格:DDL 与 DML 互斥。生产上最贵的事故之一是高峰期执行 ALTER:DDL 会排队等所有活跃事务结束,而排队期间又挡住后续所有 DML——一张表瞬间冻结。所以有"高峰期不做 DDL"的铁律,要做也得走在线重定义(DBMS_REDEFINITION)。
二、解套实操:阻塞链三连查
锁等待的排查在 Oracle 里是固定的三连查,值得形成肌肉记忆:
-- 第一查:谁在等谁(等待链一次成型) SELECT NVL(L2.username, '无') AS blocking_user, L1.username AS waiting_user, L1.sid, L1.serial#, L1.seconds_in_wait, o.object_name FROM v$session L1 JOIN v$session L2 ON L2.sid = L1.blocking_session LEFT JOIN v$locked_object lo ON lo.session_id = L1.sid LEFT JOIN dba_objects o ON o.object_id = lo.object_id WHERE L1.blocking_session IS NOT NULL; -- 第二查:等的是什么(行级锁定位到具体行) SELECT sid, id1, id2, lmode, request, ctime FROM v$lock WHERE type IN ('TX','TM') ORDER BY ctime DESC; -- 第三查:持锁会话在干嘛(决定处置方向) SELECT sid, serial#, status, last_call_et, sql_id, substr(sql_text,1,60) AS current_sql FROM v$session s LEFT JOIN v$sql q ON q.sql_id = s.sql_id WHERE sid = :持锁会话;
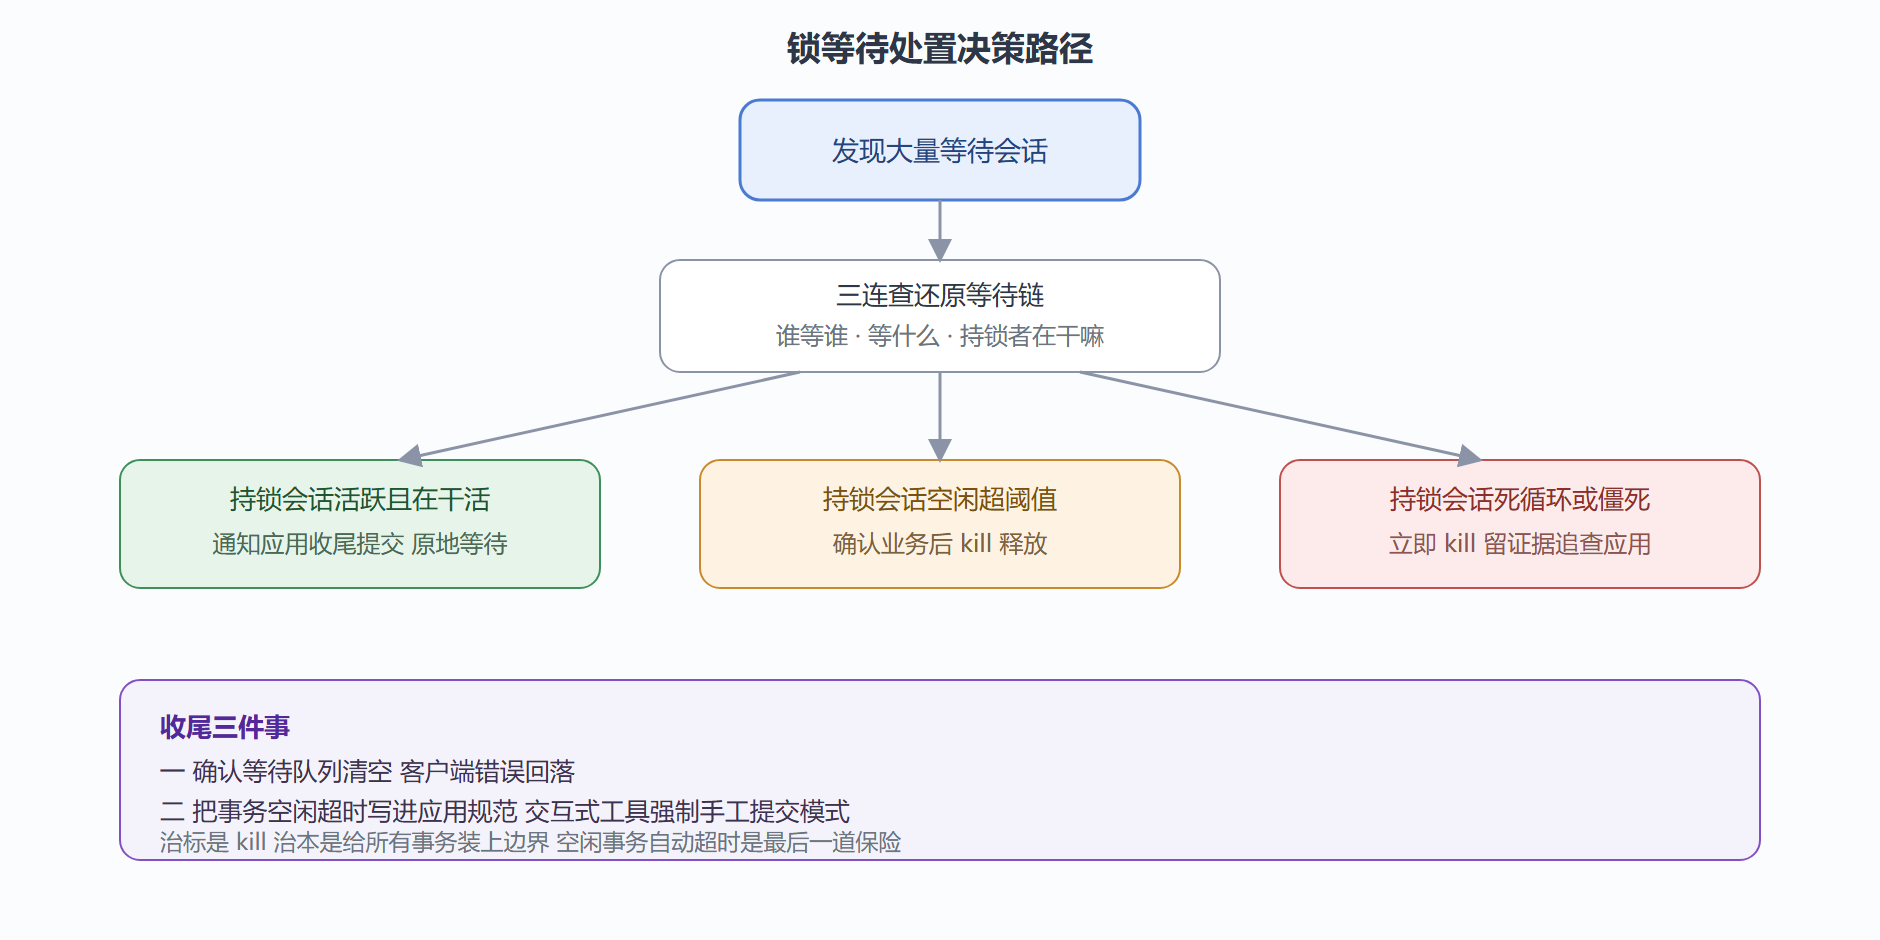
三查齐了,处置方案自然浮出来:持锁会话还活着且在干活——通知应用收尾提交,等它自己释放;持锁会话空闲(last_call_et 很大)——确认业务后 kill,回滚由 PMON 自动接管;持锁会话死循环——先 kill 再约应用排查。kill 的语法是 ALTER SYSTEM KILL SESSION 'sid,serial#',serial 变化后旧会话自动失效,这是防止误杀新会话的保险。
图 3-1:一次锁事故的处置决策路径
三、案例:挂了四小时的锁
背景。 周五 18:20,库存系统的出入库接口批量超时。第一响应者重启了应用,无效——连接一重建又挂起,说明问题在库端不在应用端。
操作。 三连查跑完:等待链头部是一个 sid 为 1937 的会话,last_call_et 显示已空闲 14100 秒(约四小时),运行的最后一条 SQL 是一张 PL/SQL 开发工具里的 SELECT FOR UPDATE。等待者 60 多个,全部堆在库存明细表的同一行——当天盘点作业把全部出入库都落在同一条汇总行上,一个空闲锁放大成了全表瘫痪。
结果。 与业务确认后 kill 1937,队列三十秒内清空。复盘在应用侧加了两道闸:接口层的 UPDATE 全部走短事务并立即提交;数据库侧开启资源限制,空闲超过 30 分钟的会话自动断开。
解读。 这个案例的三层教训值得抄进值班手册:其一,重启应用是锁等待的无效处置——锁在数据库端,应用重启只是换了一批排队的人;其二,热点行是放大器,判断"一个空闲会话能不能搞瘫系统"要看等待者是否都挤在同一资源上;其三,kill 是治标,事务边界管理(自动提交规范、空闲超时)才是治本。变式。 若三连查发现等待的不是 TX 而是 TM,且请求模式是 S(共享),典型场景是外键无索引——父表删除时全表锁子表,这种锁问题的解法在应用侧:给外键列补索引,五分钟解决一场反复发作的慢性病。
💡 关键直觉:锁等待几乎从来不是数据库配置问题,而是事务边界问题。看到一个等待,先问"持锁方为什么还没提交",再问"这段业务为什么需要这么长的临界区"——两问之后,多数锁事故在应用代码里现形。
问题四:等待事件显示"enq: TX"但找不到阻塞者怎么办? 极少数场景下阻塞链会"断头"——阻塞会话刚退出但资源尚未完全释放,或分布式事务的两阶段提交残留了悬空事务。处置顺序:等几秒重查(多数自动消散)、仍悬空则查悬空事务并按系统建议强制提交或回滚。这类残留一年遇不了几次,但值班手册里要有那一页。
本节要点回顾
- 三层锁结构:TX 行锁管冲突、TM 意向锁管层次、队列管公平;DDL 与 DML 互斥,高峰禁 DDL。
- 读不阻塞写:查询靠一致读绕开修改,锁矩阵里查询与 DML 共存是 Oracle 的标志性设计。
- 解套三连查:等待链、锁类型、持锁会话状态,三张查询背熟,处置不超五分钟。
- 治本在应用:短事务、立即提交、空闲超时、外键建索引——四道闸比任何参数调优都有效。
锁管住了"同时改"的秩序,但还有一个更隐蔽的问题:读到的是哪个时刻的数据。下一节进入隔离级别与一致读的语义世界。