5.1 备份与恢复
5.1 备份与恢复
本节摘要:备份的唯一目的是恢复,而恢复能力由三件事决定:归档模式是否开启、增量策略怎么排、恢复测试做不做。本节用 RMAN 把策略落成可执行的脚本,并用一次"恢复抽检"演示怎么验证备份真的能救你。
一、备份的真正问题是什么
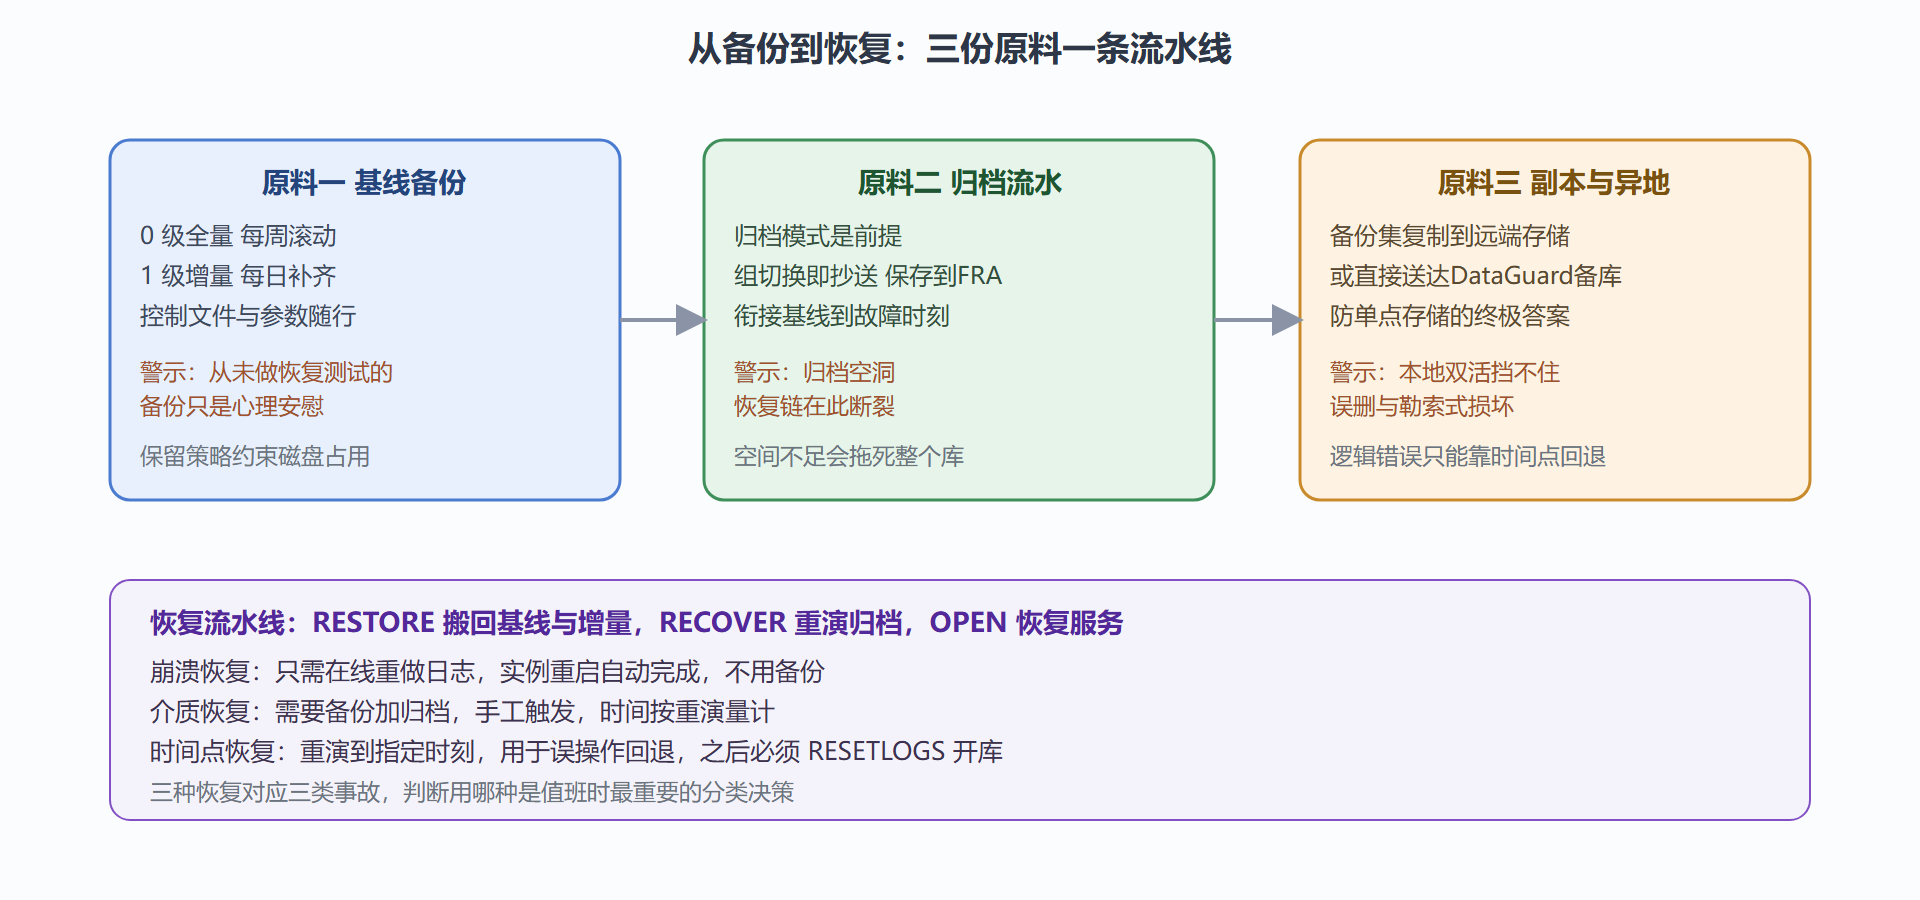
先回答一个反直觉的问题:凌晨两点全库备份,为什么白天十点存储阵列烧了,你还是可能丢一整天的数据?因为备份拷贝的是"那一刻的数据",十点烧的阵列上有白天九个小时的新变更——除非这些变更也被持续保护。所以备份体系的第一课不是学工具,是理解三种时间:备份时刻(全量拷贝的时间点)、故障时刻(最后一次全量之后的所有变更)、以及两者之间靠什么衔接。衔接靠的是第 2 章讲过的归档日志——变更流水一份不落,备份才能"起个头",重做日志把中间的账全部重演到故障前一刻。归档模式没开的库,任何备份策略都只保护"上一次备份为止的数据",这是备份体系的第一道生死线,接手任何库先查它。
二、RMAN 与增量策略
RMAN(Recovery Manager)是 Oracle 的官方备份工具,它的价值不止于自动化:块级追踪(变更跟踪文件)让增量备份只扫变更过的块,而不是全库翻一遍;备份集压缩与校验让介质成本和恢复可靠性同时改善;恢复目录记录全部历史,时间点恢复可以精确到秒。
一份常见的生产策略是"周全量 + 日增量 + 归档实时",落地成脚本长这样:
-- 0 级全量:每周日一次(0 级是增量的基线,不是普通的完全备份) RUN { BACKUP INCREMENTAL LEVEL 0 DATABASE FORMAT '/fra/backup/lv0_%U.bak' TAG weekly_lv0; BACKUP CURRENT CONTROLFILE; DELETE NOPROMPT OBSOLETE; -- 按保留策略清理过期备份 } -- 1 级增量:每天一次(差异增量,只备份 0 级或上一级之后的变更) RUN { BACKUP INCREMENTAL LEVEL 1 DATABASE FORMAT '/fra/backup/lv1_%U.bak' TAG daily_lv1; ARCHIVELOG ALL DELETE INPUT; -- 归档备份后从本地清理 } -- 配套保留策略:恢复窗口 14 天或冗余 2 份,二选一 CONFIGURE RETENTION POLICY TO RECOVERY WINDOW OF 14 DAYS;
策略设计的算术很简单:最长恢复时间 ≈ 最近一次基线之后需要应用的增量与归档总量。基线太久、增量链太长,恢复时间就失控。大库常见优化是按周滚 0 级基线、周中做 1 级累积增量,把恢复时需要重演的量压在可控范围。
三、案例:一次恢复抽检的完整记录
背景。 新 DBA 入职,交接清单里写着"每晚有备份"。老 DBA 只问了一句:最近一次做恢复测试是什么时候?没人答得上来。当晚安排一次抽检——不碰生产,把备份在测试机上恢复到另一个实例。
操作。 五步走完整流程:
-- 第一步:确认备份集与归档完整(理论上的账) RESTORE DATABASE VALIDATE; -- 只校验文件可读,不真正拷贝 -- 第二步:测试机启动到装载态(restore 需要 mount 不需要 open) STARTUP NOMOUNT; RESTORE CONTROLFILE FROM '/fra/backup/ctl_c-123456-20250820-01'; ALTER DATABASE MOUNT; RESTORE DATABASE; -- 第三步:恢复到指定时间点(演示时间点恢复能力) RUN { SET UNTIL TIME "to_date('2025-08-20 14:30:00','yyyy-mm-dd hh24:mi:ss')"; RECOVER DATABASE; } -- 第四步:以重置日志打开(时间点恢复后的标准动作) ALTER DATABASE OPEN RESETLOGS; -- 第五步:抽检数据——对比关键表行数与生产对账 SELECT COUNT(*) FROM ledger_entries WHERE entry_date = DATE '2025-08-20';
结果。 全流程 3 小时 20 分,其中 2 小时在恢复归档重演。第五步对账分毫不差,抽检通过。解读。 这次抽检真正买到三样东西:一是"备份可用"的证据(此前只是假设);二是恢复耗时的实测值——预案里的 RTO 从此有了依据,不用拍脑袋;三是流程暴露的一个隐患:归档备份有一段 40 分钟的空洞,某天归档作业静默失败过,若不抽检根本不会发现。变式。 若抽检目标是验证"误删表的恢复",流程改成表空间时间点恢复(只恢复目标表空间到辅助实例),时间从 3 小时压到 40 分钟——恢复技术选型跟着恢复目标走,别一刀切全库恢复。
图 5-1:备份体系与恢复路径全景
四、备份的边界:什么情况备份救不了你
把话说透:备份保护的是"存储坏了",不直接保护"逻辑错了"。误 UPDATE 没带 WHERE、应用 bug 灌了脏数据、勒索病毒把数据加密——这些情况下主库和备库(如果备库实时同步)会"一起错",唯一的退路是时间点恢复到出错之前,代价是重演时长加上出错窗口内的合法变更全部重录。这正是 5.4 预案里"逻辑错误应急线"独立于"介质故障应急线"存在的原因,也是闪回技术(闪回表、闪回数据库)存在的意义——轻量逻辑错误有更便宜的回退路径,备份留作最后的大招。
⚠️ 常见坑:备份作业"成功"了但实际备份了空气。归档空间满导致作业跳过、RMAN 脚本里目录写错但没人看日志、FRA 空间不足触发静默清理——三种都真实发生过。解药只有一种:恢复测试定期化,季度抽检写进值班日历。
问题一:备份要加密吗? 备份集离开机房(送到异地、云上归档)就应该加密:RMAN 的加密备份用库内密钥或口令,恢复时同样需要密钥——这与 7.2 的密钥纪律是同一套账。只存在本机快速恢复区的备份可暂缓,但"暂缓"要有明确边界,别演变成永远不做。
问题二:归档日志该留多久? 按恢复目标倒推:要支持"恢复到任意时刻"的业务承诺,归档保留期就覆盖该承诺的窗口;只要崩溃恢复能力,本地留够一到两天即可。保留期与磁盘容量直接挂钩,它是备份策略里最常被业务方低估的一项承诺——签 SLA 之前先算归档账。
问题三:增量备份会不会越攒越多? 差异增量在两次基线之间会累积(每天备份"自上次增量以来"的变更),所以基线要按周滚动。若变更高度集中在少数大表,可考虑块变更跟踪加累积增量的组合,或对超大表单独分区级备份——策略跟着数据的变化性格走,一套参数包打天下必然有短板。
问题四:FRA 空间告急时先动什么? 顺序是"先清旧、再扩容、绝不关归档":先按保留策略清理过期备份集与已备份的归档(DELETE OBSOLETE 与 DELETE INPUT 的组合),不够再扩快速恢复区。新手最常见的错误动作是删归档日志腾地方——归档一断,恢复链就断,腾出来的空间毫无意义。
本节要点回顾
- 归档模式是生死线:没开归档的备份策略只保护到上一次备份,接手任何库先确认它。
- 增量算术:最长恢复时间约等于基线之后的增量加归档重演量,基线节律决定恢复上限。
- 抽检五步:验证、还原、重演、开库、对账——恢复耗时的实测值就是预案里的 RTO。
- 备份的边界:介质故障找备份,逻辑错误找时间点回退或闪回;备库实时同步挡不住"一起错"。
备份数据保住了,但服务还停着。下一节看怎么让另一台机器把服务顶起来——Data Guard 的切换艺术。