3.1 定位策略体系与选型优先级
3.1 定位策略体系与选型优先级
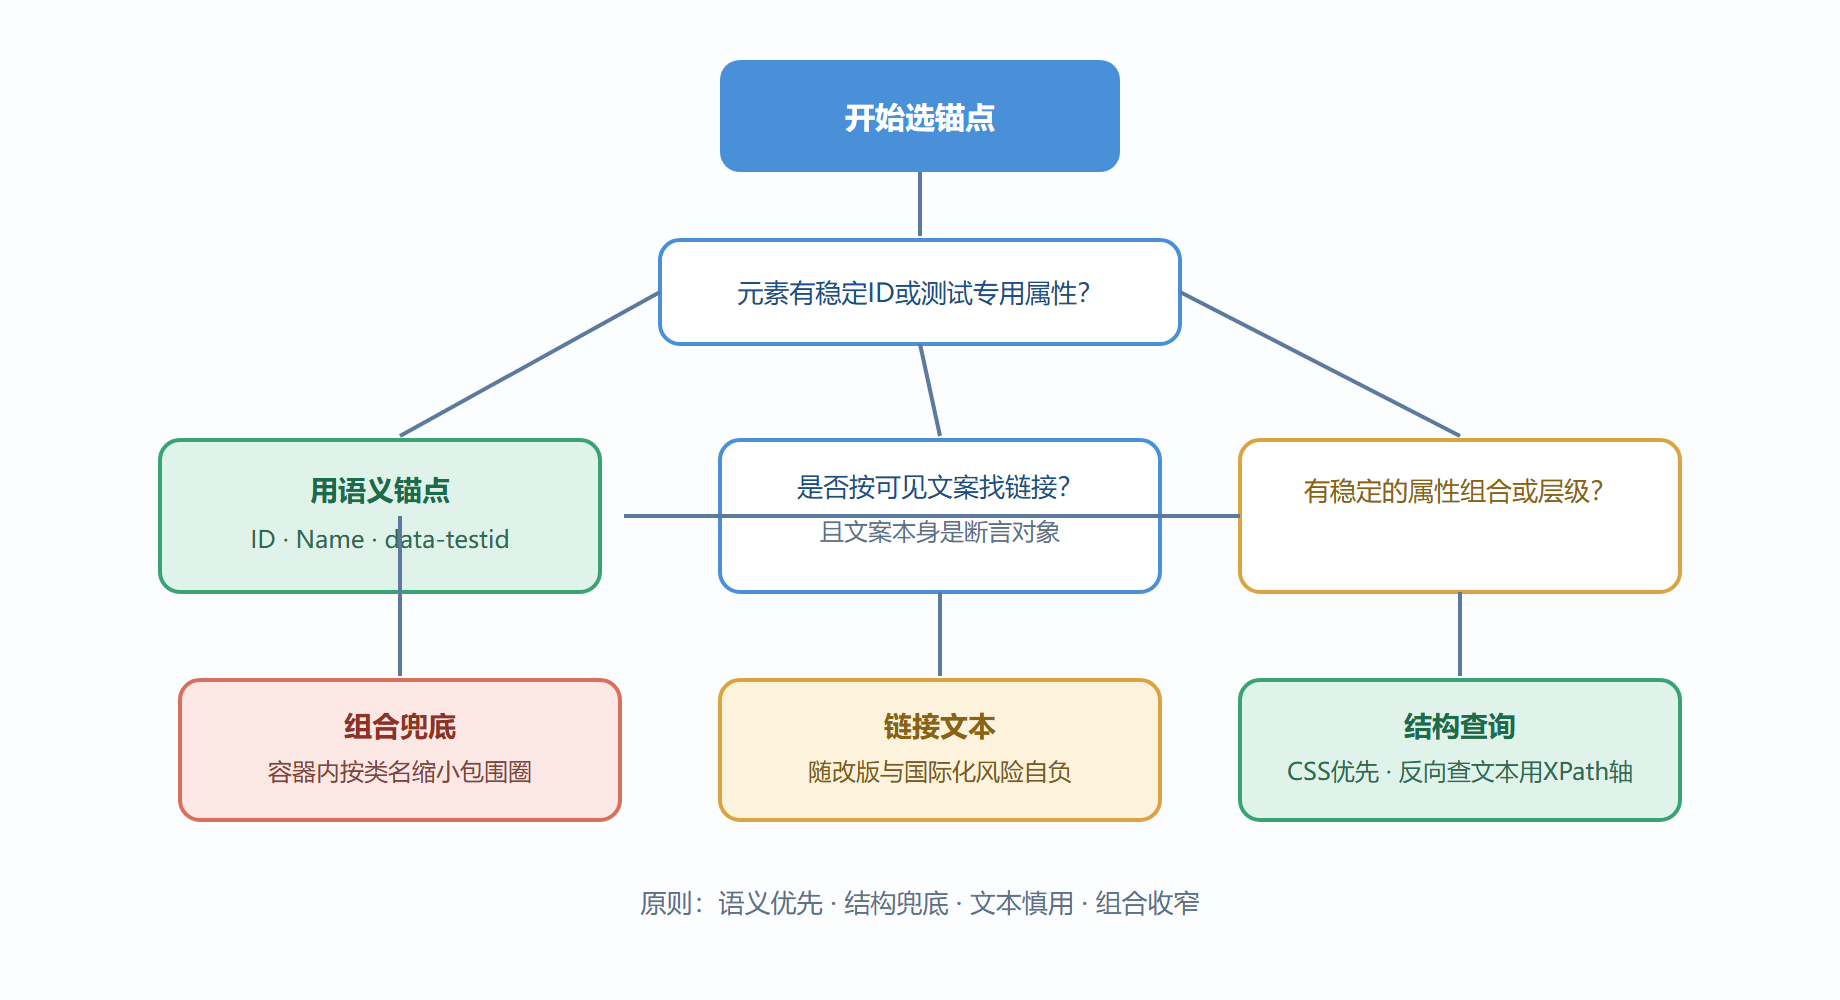
本节摘要:Selenium 提供八种内置定位策略,从语义锚点(ID、Name、测试专用属性)到结构查询(CSS 选择器、XPath 轴)再到文本匹配(链接文本),稳定性和表达力各有所长。本节给出一套"语义优先、结构兜底、文本慎用"的选型优先级,配一张决策树:写定位器之前先选对锚点,比写完再修省十倍力气——这是本章后续两节排错与等待设计的共同前提。
八种策略,一条优先级线
打开任何一段翻车的自动化代码,十个里有八个的病根在定位器:要么锚点选错了类型,要么锚点绑定了天生易变的属性。定位器的本质是"在 DOM 里描述你要的那个元素的唯一特征"——特征选得好,页面改版也不受牵连;特征选得差,页面动一个像素脚本就瞎。八种策略不是八个平等选项,它们排在一条从稳到脆的光谱上,选型的功夫就是记住这条光谱。
第一梯队:语义锚点。 ID 是首选,前提是它是人写的、稳定的(id="login-btn" 这类);Name 次之,在表单场景依然可靠。比 ID 更值得圈出来的是测试专用属性——data-testid、data-qa 这类约定属性,它们不为样式服务、不为逻辑服务,只为测试存在,前端重构时存活率最高。如果团队还没这个约定,本节的第一个行动项就是去推动它:一行前端代码的约定,换来整个自动化工程抗改版能力的质变。
第二梯队:结构查询。 CSS 选择器与 XPath。它们不依赖页面作者"好心"留下标识,而是靠结构关系与属性组合锁定目标,表达力最强,也是唯一能在复杂组件树里穿行的工具。两者内部还有偏好:属性与层级关系明确的场景优先 CSS(快、可读);需要"向上找祖先""按文本过滤"这类反向或语义查询时,XPath 的轴与函数无可替代。
第三梯队:文本匹配。 链接文本与部分链接文本按可见文字找元素,语义直观,但文案是产品最常改的东西——国际化站点更是重灾区。只在"这条用例本来就要验证这行文案"时才用它,把脆弱的文案当成断言对象而不是定位锚点。
第四梯队:泛化匹配。 类名与标签名单独用几乎必然命中多个元素,价值在于组合——在某个容器范围内按类名缩小包围圈,或者批量采集同类元素做列表断言。
图3-1 定位锚点选型决策树
动手写:同一目标,从脆到稳的四种写法
光背原则没用,看同一个按钮的四种定位写法,脆与稳的差距立刻具体化。目标是登录表单的提交按钮:
from selenium.webdriver.common.by import By # 写法一:绝对路径 XPath —— 最脆,页面结构一动就废,禁止使用 By.XPATH, "/html/body/div[2]/div/form/div[3]/button" # 写法二:样式类名 —— 脆,类名是样式语义,重构样式即失效 By.CLASS_NAME, "btn-primary-lg" # 写法三:结构化 CSS —— 较稳,绑定表单语义与按钮类型 By.CSS_SELECTOR, "form.login-form button[type='submit']" # 写法四:测试专用属性 —— 最稳,为测试而生,改版存活率最高 By.CSS_SELECTOR, "[data-testid='login-submit']"
四种写法今天都能跑通,差别在三个月后。写法一把"元素恰好在页面的第三个 div 里"写成了契约,前端加个轮播图就违约;写法二把"这个按钮长什么样"当成了身份,设计师换个配色方案它就失联;写法三把契约建立在业务结构上(登录表单的提交按钮),扛得住大多数改版;写法四直接要一个测试身份证。定位器的质量差异,全在"你绑定的是页面的哪一层信息"——绑定越表层越脆,越语义越稳。
XPath 并不天然脆,脆的是绝对路径。相对 XPath 的轴查询是处理复杂场景的利器,比如"找到商品卡片里价格文本旁边那个加购按钮":
# 相对XPath:语义清晰,抗结构微调 "//div[@data-testid='goods-card']//button[.//span[text()='加入购物车']]"
三个进阶工具
范围收窄。 find_element 在整个 DOM 里找,先定位容器再在容器内查找,能把全局歧义变成局部唯一:列表页五十张卡片,先按卡片标识锁定那一格,再在格内找按钮。嵌套查找还天然隔离了页面其他区域的干扰。
批量采集。 find_elements(复数)返回全部命中,用于列表断言与计数校验。注意空结果是返回空列表而不报错,判断"元素不存在"的场景要用它而不是捕获异常。
相对定位器。 Selenium 4 新增的玩法:按空间关系描述目标——"在搜索框上方的那个按钮""离价格标签最近的图标"。适合视觉布局明确但 DOM 关系混乱的页面,用的时候记得布局本身也是会变的,别拿它当第一梯队。
与后续两节的接口
选好了锚点只是买了一半的保险——锚点再稳,页面没渲染出来照样找不到。下一节我们直面"明明有却找不到"的六类高频工单,把排错路径走成肌肉记忆;3.3 再从机制上根治"时有时无"的竞态。定位、排错、等待,三节连起来才是完整的"让元素听话"的功夫。
选型的三个延伸问答
问:选择器越短越好吗? 不是。选择器的质量标准是"绑定语义的唯一性",不是长度。[data-testid='login-submit'] 比许多短选择器都长,却是全场最稳的写法;反过来为求短用 .btn 这种泛化类名,是把歧义埋进代码里。
问:老页面没有测试属性也不让改前端,怎么办? 退而求其次的顺序是:稳定的业务属性(表单的名称属性、链接的固有地址)→ 结构化 CSS 组合 → 相对 XPath 轴查询。同时把"推动前端输出测试属性"作为技术债登记,逐版本归还——多数前端团队在理解动机后都愿意配合,这本质上是给他们的代码补充可测性。
问:定位器要不要集中到一个文件里管理? 集中要按页面对象的边界集中(第 4 章),而不是全仓一个大文件——后者会变成人人争抢的公共冰箱。每个页面对象管理自己的锚点,跨页复用的组合(比如导航栏)拆成组件对象,这正是 4.2 组件化的内容。
一个定位器评审练习
把优先级内化的最快方式,是对着真实页面做一轮选型演练。任选你所在产品的一个常用页面,为其中五个交互元素各写一个候选定位器,然后按三个维度逐项打分:唯一性(命中几个)、稳定性(页面小改后还能不能命中,凭你对改版规律的了解预判)、可读性(三个月后同事能否看懂)。打完分会发现一个规律:得分最高的写法几乎都绑定业务语义,得分最低的都绑定表面样式或结构位置。这个练习的产出不止是五个好定位器,更是一双"看见锚点质量"的眼睛——往后写用例时,你会下意识地先问一句:这个选择器绑定的是页面的哪层信息?
收工清单
- 光谱记忆:语义锚点、结构查询、文本匹配、泛化匹配,从稳到脆一线排开。
- 优先级口诀:语义优先、结构兜底、文本慎用、组合收窄;绝对路径 XPath 一票否决。
- 绑定的信息层级:锚点绑定越表层越脆,越语义越稳;测试专用属性是最强锚点。
- 三个进阶:范围收窄、批量采集、相对定位器——分别解决歧义、列表与空间描述。
- 推动约定:让前端输出测试专用属性,是自动化工程师最值得做的一次跨岗沟通。