- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Selenium自动化测试·教程导读
又是深夜回归,流水线整页飘红。你盯着那份失败截图发呆:登录按钮明明就在页面上,脚本却报"无法定位元素"。值班群里没人承认动过前端,可前几天还全绿的回归套件,如今像一本越翻越厚的故障工单簿。这本教程,就是为这样的夜晚准备的——它教你把每回红屏都变成可以归档、可以复盘、可以预防的工单,免得回回抓狂重来。
这本教程为什么按"工单"来写
Selenium 是目前应用最广的 Web UI 自动化测试框架:它通过 WebDriver 协议驱动真实浏览器,把"打开页面、输入账号、点击登录、核对结果"这套人工操作变成可重复执行的脚本,是回归测试、跨浏览器验证和持续交付门禁的基础设施。学会 Selenium 不难,难的是让几百条脚本在频繁改版的前端面前长期稳定——绝大多数团队的自动化项目不是死于不会写,而是死于脆弱脚本日复一日制造的红屏,直到没人再信回归报告。
所以本册的写法不同于常见的"API 清单式"教程。每一章都围绕自动化项目里真实发生的一类故障展开:定位不到元素、等待时机不对、页面结构一改脚本全线崩、并行执行互相干扰、流水线里跑得比本地慢……先还原故障现场,再拆解背后的机制,给出修复方案与预防设计,最后留一道变式练习检验你是否真的会迁移。你读到的每个知识点,都挂在一张具体的"工单"上,而不是悬在半空。
全册结构与学习路线
全册 8 章 28 节,按"能跑通 → 站得稳 → 上了规模 → 守得住"的顺序推进。章与章之间有明确的依赖关系:第 3 章的定位与等待是一切脚本的地基;第 4 章的页面对象模型决定第 7 章的维护成本;第 6 章的并行执行要压在第 7 章的稳定性设计之上才有意义。若你在某一章卡住,多半是上游某章的功课还没做足,顺着路线图回溯即可。
图0-1 全册学习路线与依赖关系
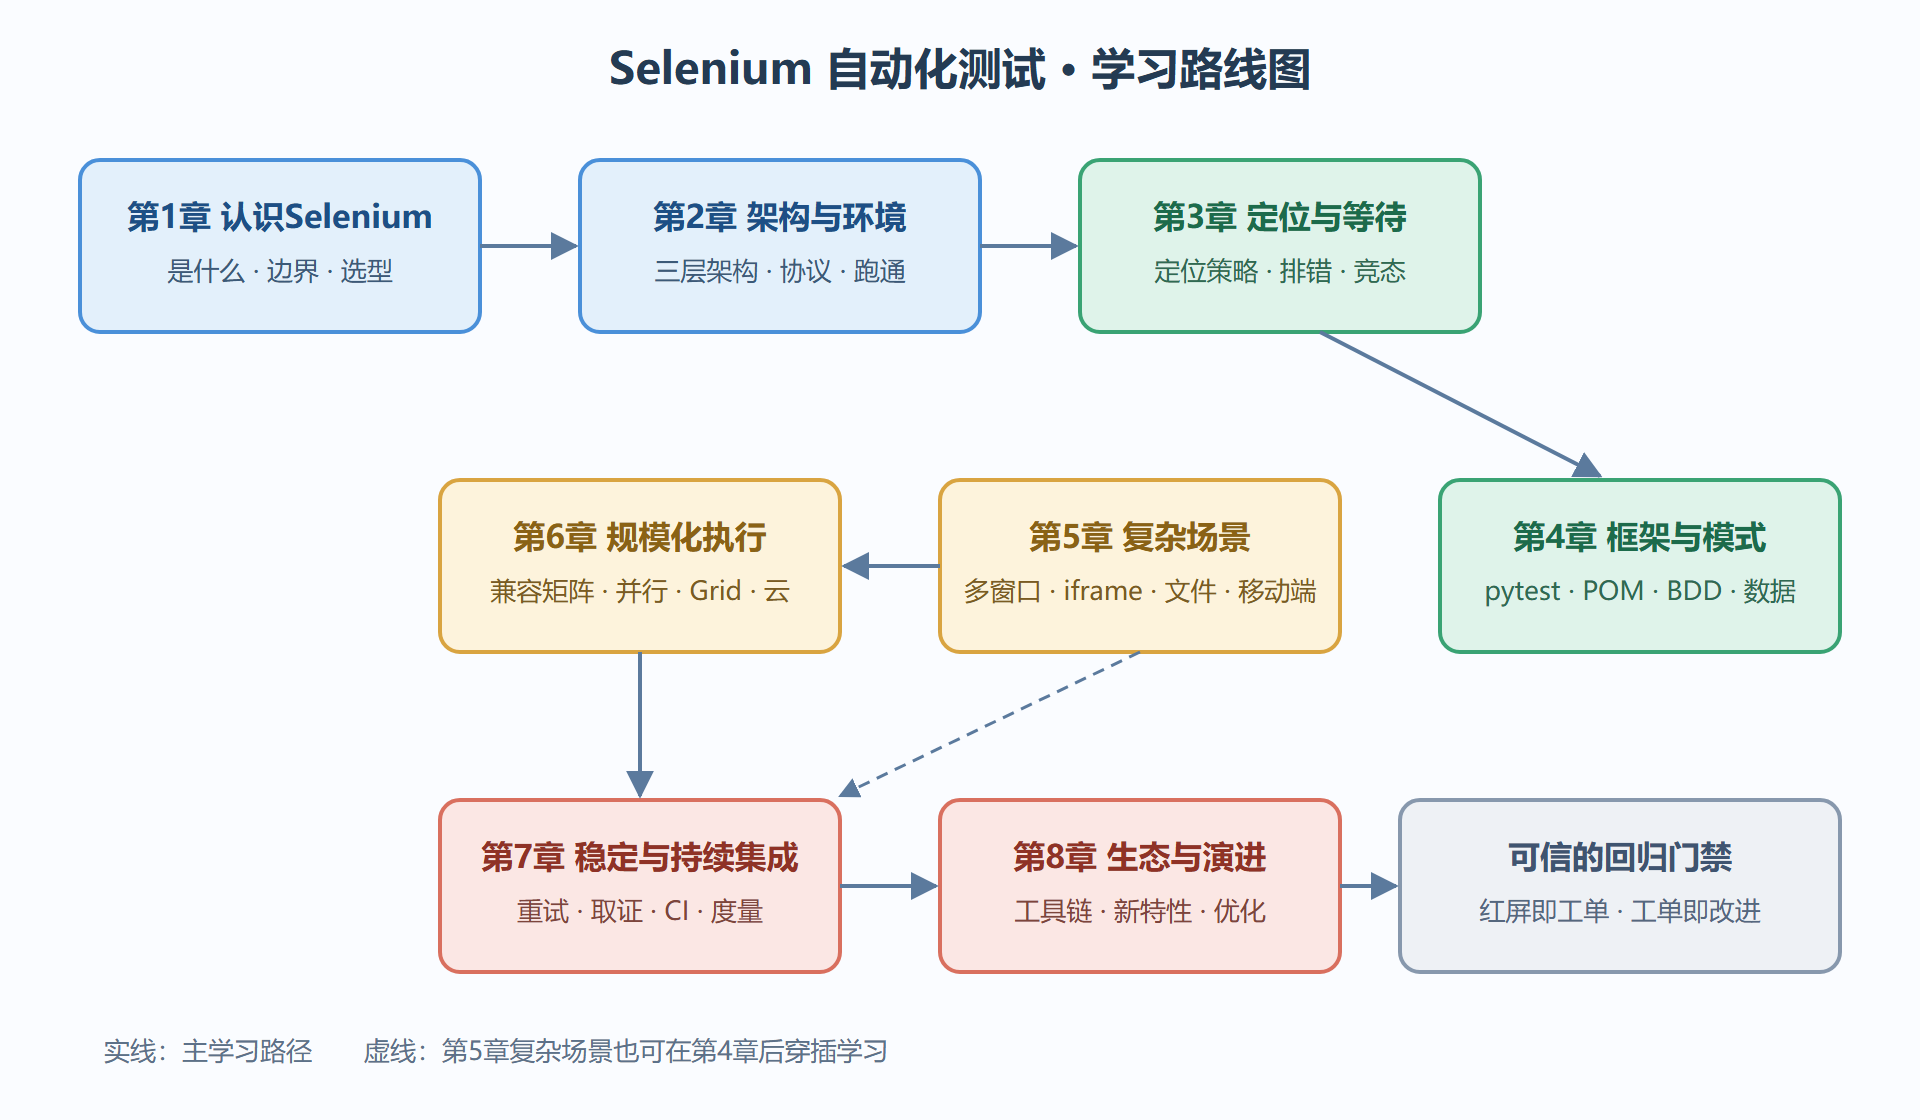
把这张图读成一张检查表:从左上角出发,每一个箭头都是"先有这个,才学得动下一个"。第 3 章被涂成绿色,因为它是故障率最高、也最值得反复回看的一章——本册将近三分之一的"工单"都出自定位与等待。
学完这本教程你能做什么
读完并动手做完各章练习后,你应当能够:独立搭好一套可运行的 Selenium 环境并跑通第一条脚本;面对"元素找不到、点了没反应、加载不完全"三类高频故障,按章给出的排错路径定位到根因;用页面对象模型把一套几十条用例的工程整理成改一处页面只动一处代码的结构;把脚本接入持续集成流水线,配上截图取证、失败重试与可读的报告,让回归结果重新被人信任;并在 Selenium 与 Playwright、Cypress 等新引擎之间,为具体项目做出说得清理由的选型决策。
动手约定与阅读建议
本册所有示例以 Python 语言为主——语法短、上手快,也是测试团队最常见的选型;涉及语言无关的机制(如 WebDriver 协议、Grid 调度)时会单独点明。建议边读边开一个练习项目,每章的"变式练习"务必亲手跑一遍:自动化是一门口碑与手感的技艺,只读不练,工单只会从别人的簿子里搬到你的簿子里。练习项目的形态不必复杂:一个普通的工程目录、一份 requirements 依赖清单、一个被测站点(自建小站或公开演示站均可),跟着各章的代码块逐段敲进去,观察输出与报错——本册的示例代码都按可独立运行的标准书写,输入输出与命令行会话在正文中配了说明。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...