4.2 PageObject模型:页面对象与分层设计
4.2 PageObject模型:页面对象与分层设计
本节摘要:页面对象模型(Page Object Model)把"页面长什么样、能做什么"封装成类,让用例只说业务意图、不碰页面细节,页面一改只需修改对应的页面对象。本节讲清它的分层纪律:页面对象放什么、绝不放什么,组件化拆分怎么做,以及一个真实改版案例里这套结构省下的维护账。它是第 4 章承重墙——前面两节的运行器与定位功夫在此收拢成结构。
一次改版,修三天:结构性疾病的发作
先看一张典型工单。某团队两百条用例,前端把登录方式从账号密码改成了验证码优先,登录相关字段调整了位置与属性。改版上线当天,回归套件红了六十条——不止登录用例,凡是要先登录才能操作的场景全挂。修复耗时三天:同一个登录流程的定位器与操作步骤,散落在六十个文件里,改一处漏一处,改完还要回归修复本身。
这三天不是技能问题,是结构问题。每一处"登录怎么操作"的知识都被复制到了每个需要它的用例里,页面改一次,知识就要同步几十次——这类病可以称为"知识散布症"。页面对象模型的药方是把知识收拢:为每个页面建一个类,页面的元素与操作只在此处定义一次;用例不再知道页面内部,只调用"输入用户名""点击登录"这样的业务动作。页面再改,只动一个类,两百条用例原样复用。
页面对象里放什么、绝不放什么
看一个最小的登录页面对象,再讲纪律:
from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC class LoginPage: URL = "/login" USER = (By.CSS_SELECTOR, "[data-testid='login-user']") PASS = (By.CSS_SELECTOR, "[data-testid='login-pass']") SUBMIT = (By.CSS_SELECTOR, "[data-testid='login-submit']") def __init__(self, driver, base_url): self.driver = driver self.base = base_url self.wait = WebDriverWait(driver, 10) def open(self): self.driver.get(self.base + self.URL) return self def login(self, username, password): self.open() self.wait.until(EC.visibility_of_element_located(self.USER)).send_keys(username) self.driver.find_element(*self.PASS).send_keys(password) self.driver.find_element(*self.SUBMIT).click() return HomePage(self.driver, self.base)
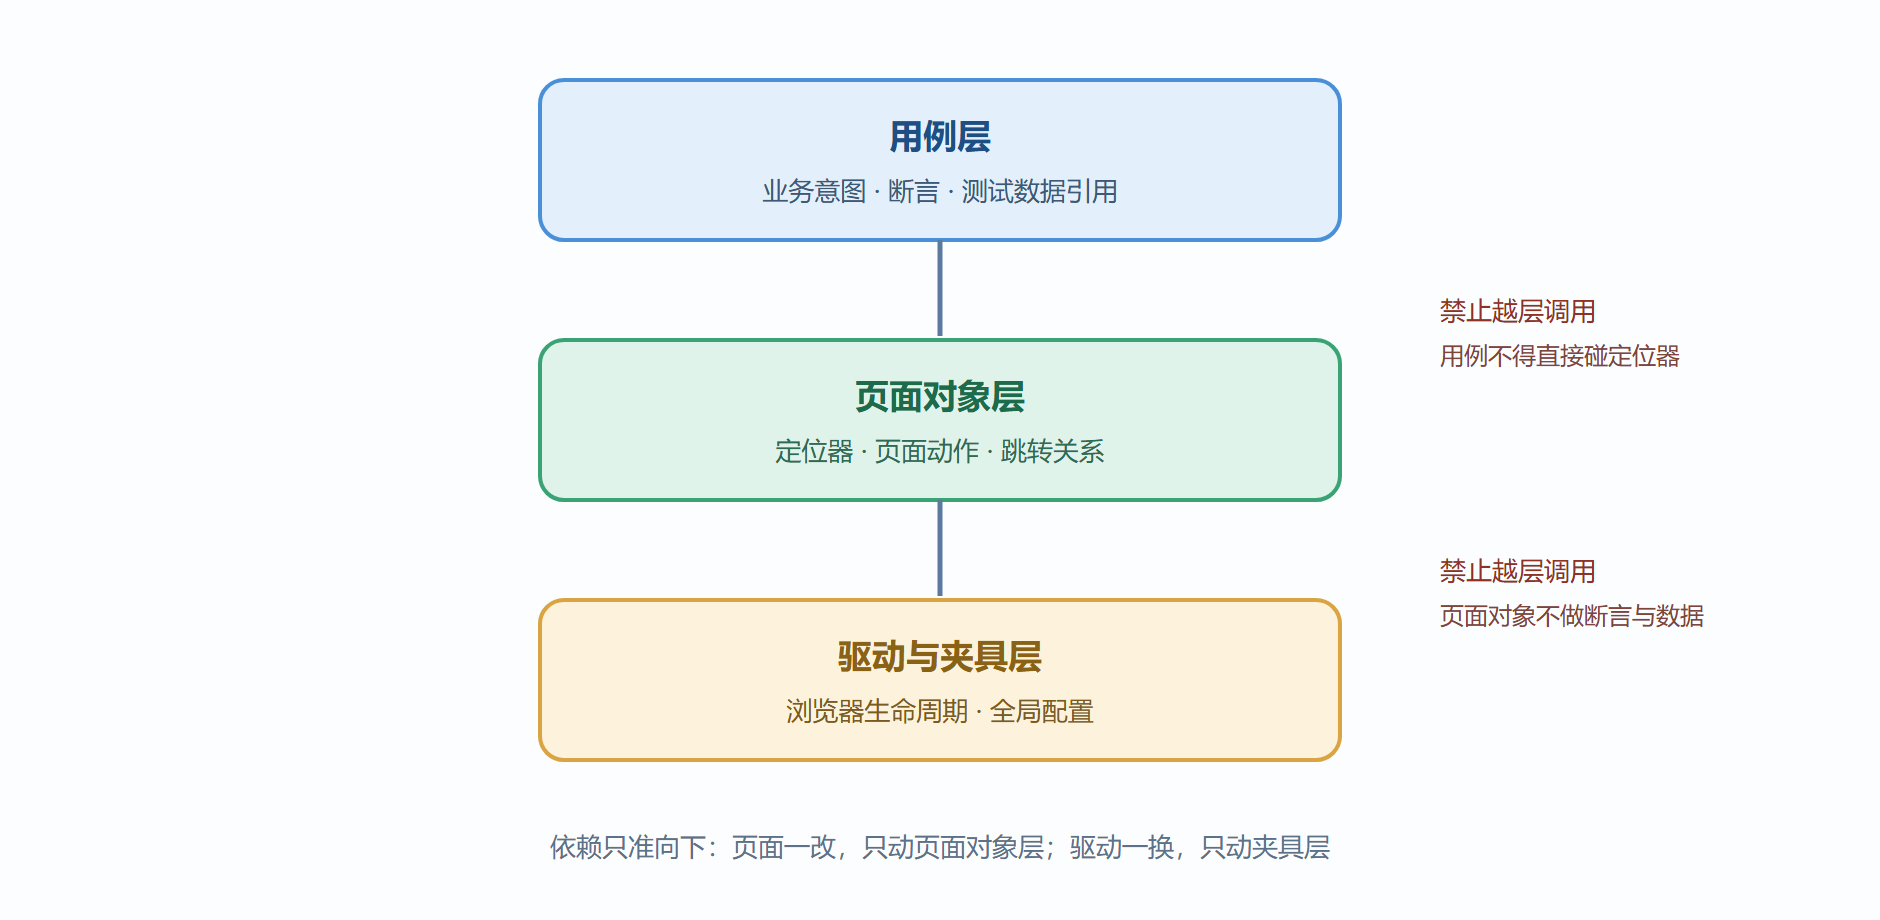
三条纪律从这段代码里长出来。第一,定位器是页面类的私有财产。 所有选择器集中在类顶部常量区,用例永远见不到它们——4.1 说的"改版只改一处",改的就是这几行。第二,方法返回下一个页面对象。 登录成功返回首页对象,用例链条自然连贯,页面的跳转关系被编码进对象图里。第三,方法名说业务语言。 login 而不是 fill_and_click——用例读起来是业务流程,不是控件清单。
而"绝不放"的部分更考验纪律。页面对象里不放断言:判断"登录成功与否"是用例的职责,页面类只提供读取状态的方法(比如"取欢迎文案"),断不加。页面对象里不放业务判断:不给 login_if_needed 这类带条件分支的方法,条件逻辑属于用例。页面对象里不放测试数据:账号密码永远由参数传入——数据从哪来是 4.4 的话题,页面类只管动作。
图4-2 自动化工程分层与依赖方向
组件化:当页面大到装不下
登录页一个类足够,门户首页则会撞上规模墙:导航、搜索、推荐位、购物车浮层挤在一个类里,方法上百个,照样难养。解法是组件化拆分:把页面上可独立变化的区域拆成组件对象(导航栏、页脚、购物车组件),页面对象持有并组装它们。
class NavBar: CART = (By.CSS_SELECTOR, "[data-testid='nav-cart']") def __init__(self, driver): self.driver = driver def open_cart(self): self.driver.find_element(*self.CART).click() return CartPage(self.driver) class HomePage: def __init__(self, driver, base_url): self.driver = driver self.base = base_url self.nav = NavBar(driver) # 页面持有组件 def go_to_cart(self): return self.nav.open_cart()
拆分粒度拿捏一个标准:按"变化的原因"拆,不按视觉大小拆。导航栏的改动独立于推荐位,就值得拆开;两个区域总是同起同落地改,合并反而省事。过度拆分的工程比不拆更难读——这是所有设计模式的共同陷阱。
回到那张工单:结构的价值账
现在重演开头那次改版:验证码优先的登录流程,需要动的只有一个登录页面对象——定位器与 login 方法内部,两百条用例一行不改。修复从三天缩到半小时,而且这半小时改动的类只有一个,回归修复的风险几乎为零。这就是页面对象模型的全部意义:它不让你少写代码,它让变化只发生在一个地方。
两个落地追问
问:页面对象要不要继承一个"基类页面"? 可以有轻量基类,放真正全局的公共能力:构造时保存驱动与等待对象、通用的高亮辅助、日志埋点。警惕把业务方法上提到基类——"所有页面都有 go_to_home"这类设计,很快会演变成互相纠缠的继承树。继承树越浅越好,组合优于继承在这里同样成立。
问:一个页面该建几个页面对象? 按"用户心智中的页面"建,不按技术组件建。路由变化但用户感知是同一页面的(弹窗、抽屉),归入同一对象;用户感知换了页面,即使技术上是单页应用的前端切换,也拆成新对象。用用户旅程做切分线,页面对象的命名与用例的语言才对得上。
收工清单
- 知识收拢:页面的元素与操作知识只定义一次,复制粘贴是结构疾病的根源。
- 三条放:定位器集中、动作说业务语言、方法返回下个页面对象。
- 三条不放:不放断言、不放业务分支、不放测试数据——各归其位。
- 组件化按变化原因拆:独立变化才拆分,警惕过度设计。
- 价值账:结构的回报在改版那天兑现,平时看不见,出事时是十倍差距。
页面对象让用例读了像业务流程;能不能让用例直接用业务语言写成文档,产品与测试读同一份文件?下一节看行为驱动的务实答案。