4.4 测试数据与配置管理
4.4 测试数据与配置管理
本节摘要:测试数据写死在用例里、环境配置散落在代码中,是自动化套件从"能跑"走向"能管"的最后一段路。本节给出一套双层方案:数据层把输入外置成文件并区分数据形态,配置层把环境参数做成"基础加覆盖"的分层体系,一条命令切换环境。它是第 4 章的收官——逻辑、表达、资源都理顺之后,输入与环境的收尾决定了套件能否支撑多环境并行。
把数据和配置请出代码库
先盘点散落在用例里的两种"异物"。一种是测试数据:账号、商品名、搜索关键词、预期金额——它们写在代码里,意味着改一条数据要改代码、走评审、重新发版,而数据的本质是"经常变的输入"。另一种是环境配置:被测地址、数据库连接、浏览器参数、超时时限——它们散落在代码里,意味着从测试环境切到预发布要全文搜索替换,漏一处就是一个深夜工单。
两种异物的解法同构:让变化的与不变的分离。用例逻辑是不变的主体,数据与环境是可变的两翼,各自外置成文件,用例在运行时加载。判断外置是否到位只有一个标准:切换环境或修改数据,是否一行代码都不用动。
数据外置:形态决定载体
数据外置第一步是给数据分形态,不同形态用不同载体。参数化用的最小数据(关键词、期望值)用参数化标记内联或列表即可,4.1 已示范;成组的结构化数据(完整的下单场景:用户、商品、地址、优惠券)外置成 YAML 或 JSON 文件,一文件一场景,可读可审:
# data/order_basic.yaml scenario: 基础下单流程 user: qa_buyer_01 goods: - sku: "KB-87-001" count: 2 coupon: "SAVE10" expect: total_after_discount: 898.00 status_text: "订单提交成功"
import yaml, pytest, pathlib def load_case(name): path = pathlib.Path(__file__).parent / "data" / f"{name}.yaml" return yaml.safe_load(path.read_text(encoding="utf-8")) @pytest.mark.parametrize("name", ["order_basic", "order_with_points"]) def test_order(driver, name): case = load_case(name) # 数据在文件里,逻辑在代码里 ...
第二步是数据的"生成与回收"。注册类用例需要唯一账号,手机号写死必然撞库;正确姿势是程序化生成(时间戳或随机数拼装),配合数据标记字段(专属前缀)便于定期清理。而下单类用例依赖的存量数据(商品、库存)要在数据文件里声明前置条件,由夹具在用例前校验——数据前置不满足时跳过并说明,好过跑一半莫名其妙地红。测试账号要建立"领用与隔离"意识:并行执行(下一章)时两个进程共用一个账号互相踢下线,是并发工单的常客;账号池加独占分配是基本功。
配置分层:基础加覆盖
环境配置的正确结构是"一份基础,多份覆盖"。基础配置写所有环境共用的默认值,每个环境一个覆盖文件只写差异项,运行时按环境名合并:
# config/base.yaml timeout_short: 5 timeout_long: 20 headless: true viewport: "1920x1080" # config/staging.yaml base_url: "https://staging.shop.example.com" db_host: "staging-db.internal" # config/prod_smoke.yaml base_url: "https://shop.example.com" timeout_long: 30
import yaml, os, pathlib def load_config(env): root = pathlib.Path(__file__).parent / "config" cfg = yaml.safe_load((root / "base.yaml").read_text(encoding="utf-8")) override = root / f"{env}.yaml" if override.exists(): cfg.update(yaml.safe_load(override.read_text(encoding="utf-8"))) cfg["base_url"] = os.environ.get("BASE_URL", cfg["base_url"]) # 环境变量最高 return cfg
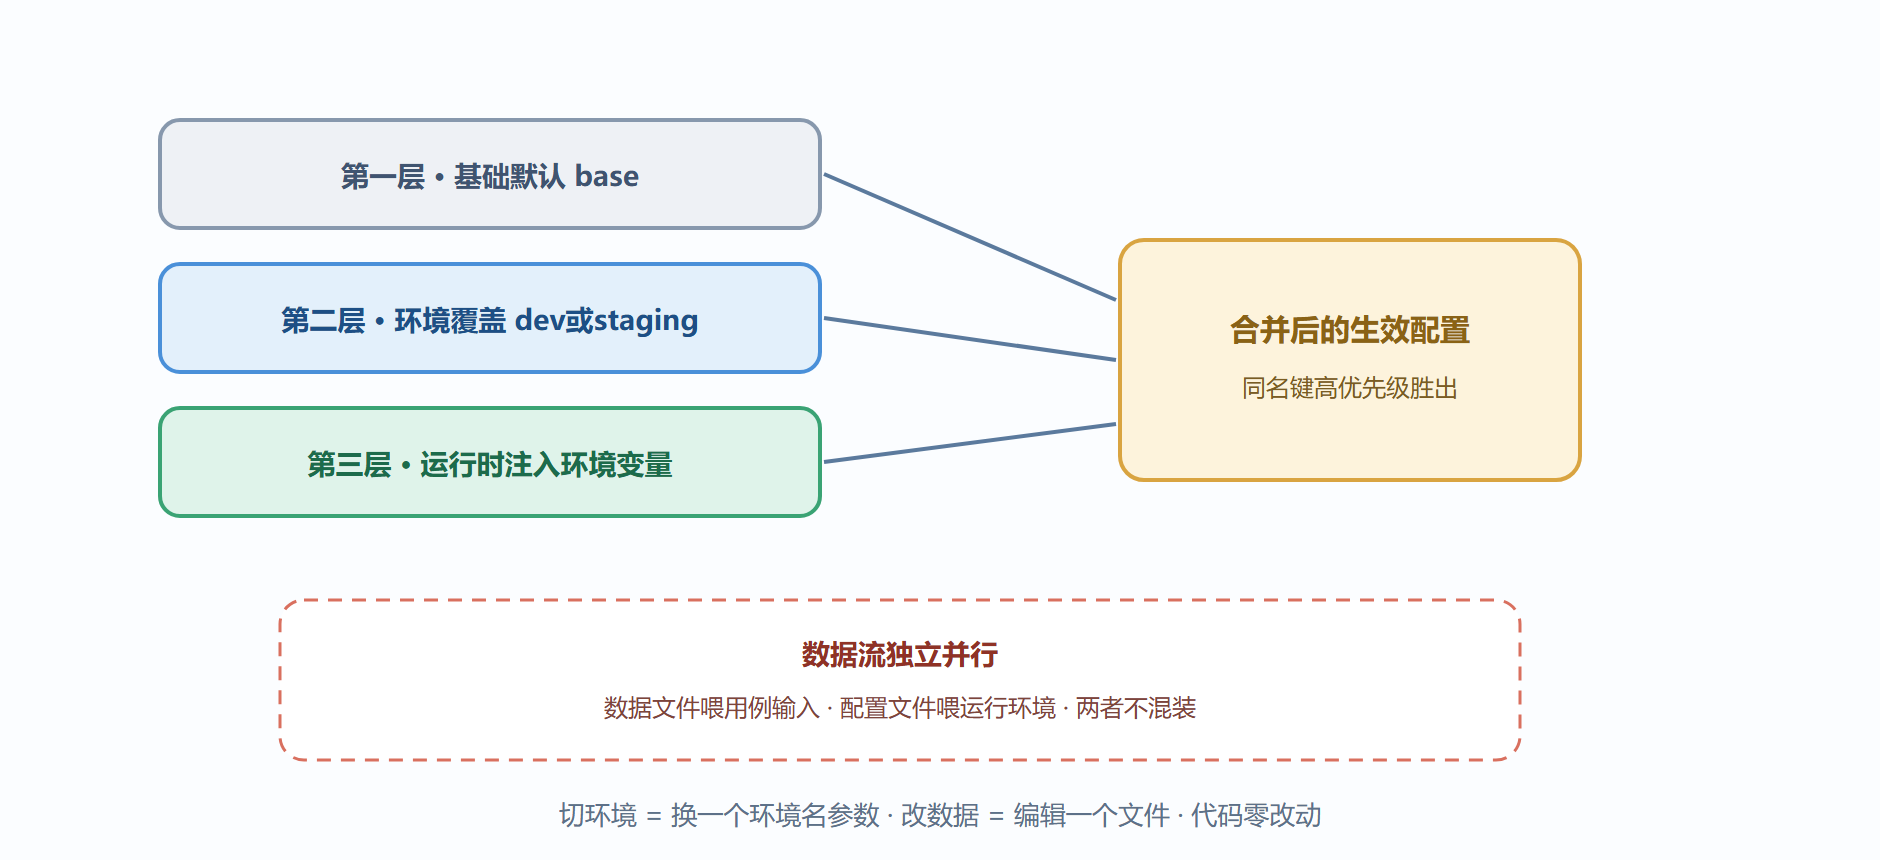
优先级从低到高是三层:基础默认、环境覆盖、运行时注入。最上层留给环境变量,因为流水线触发时传入的环境变量无需改任何文件即可生效——这是 4.4 与第 7 章 CI 集成的接口:流水线只负责设置环境变量,仓库里七七八八的配置一概不动。
图4-4 配置优先级与数据流
环境切换的验收演练
方案落地后做一次验收:在本地分别以开发与预发布两个环境名跑冒烟集,全程只改一个命令行参数;再让同事不改代码、只看文档,把新环境接进他自己的执行流程。验收通过的标准是"零代码改动、零口头指导"。如果做不到,说明还有配置残留在代码里——通常是某个超时数值、某个开关判断,顺藤摸瓜清出去。
最后划一条安全线:预发布与生产环境的配置文件里,永不落真实密码与密钥——敏感项一律走环境变量或密钥管理服务注入,仓库里的配置文件只留占位符。自动化仓库的访问面通常比业务代码更宽,它是安全审计里最容易被遗忘的角落。
数据管理的两个追问
问:数据文件越积越多,怎么治理? 给数据文件立命名与归属规则:一场景一文件、文件名含模块与场景语义、文件头部注释写清前置条件与负责人。每季度做一次数据文件的盘点,删除对应场景已下线的数据——数据文件是资产也是垃圾场,差别只在有没有盘点机制。
问:环境配置切换后怎么确认真的切过去了? 和 2.3 的版本自检同一个思想:打印生效配置的关键项。在夹具或启动日志里输出环境名与被测地址,让每次执行报告的第一行就写着"我在哪跑的"。排查"本地过预发挂"时,这行日志省掉的扯皮时间以小时计。
一个配置外置的演练
把本节方案落到你自己的工程,从最小可行开始:挑出一个写死了被测地址的用例文件,按三层结构建基础配置与两个环境覆盖文件,把地址迁出去;再跑一遍该用例,分别用两个环境名各执行一次,确认行为随环境切换。这个十五分钟的演练会暴露所有隐藏的写死项——每次报"找不到主机"就是又挖出一处。逐文件迁移,两三天后整个工程就告别了"改环境改代码"。外置这件事,动手一次胜过读十遍。
收工清单
- 分离判据:切环境、改数据是否零代码改动,是外置是否到位的唯一标准。
- 数据分形态:内联小数据走参数化,结构化场景走文件,动态账号程序化生成。
- 账号三意识:唯一性防撞库、前置校验防假失败、独占分配防并发互踢。
- 配置三层:基础默认、环境覆盖、运行时注入,优先级自下而上,接口留给环境变量。
- 安全红线:仓库配置不落真实密钥,敏感项只走注入。
至此,单机能跑、成套能养、数据能管的工程骨架成型。下一章把这套骨架抬上规模化舞台:多浏览器兼容、并行执行与网格调度。