2.1 整体架构与核心服务组件
2.1 整体架构与核心服务组件
本节摘要:SQL Server 实例由协议层、关系引擎、存储引擎与 SQLOS 四层组成,外加一组常驻的服务组件(代理、全文检索、复制)。本节沿一条查询的旅程逐层拆解,重点讲清两个决定运维思路的设计:协作式调度与计划缓存。掌握本节,后面所有章节的机制讨论就有了共同坐标。
把实例拆成一条流水线看
第 1 章回答了"这台机器是谁",现在打开引擎盖。一条 SQL 语句进入实例后要过四道工序:协议层把网络字节流解成请求(TDS 是客户端与服务器之间的通用语言,共享内存、TCP、命名管道是三种运输方式);关系引擎负责"翻译与决策"——命令解析器检查语法,代数优化器把对象名绑定到物理对象并产出逻辑树,查询优化器基于成本估算挑出物理计划,执行器按计划调度算子;存储引擎负责"搬运与记账"——访问方法把索引和页的操作翻译成对缓冲池的读写,锁管理器维持秩序,事务日志记录每一笔改动;最底层 SQLOS 是一个嵌入在数据库进程里的"迷你操作系统",管理调度器、内存与 I/O。
流水线上还有几位"编外员工",第 2 章旧版教材称它们为核心服务组件,办案时经常碰到:SQL Server 代理是自动化中枢,作业、计划、告警都归它管(第 8 章的巡检体系就靠它);全文与语义检索把非结构化文本查询纳入 T-SQL;复制服务在库与库之间搬运数据变更,是老一代数据分发的默认答案;再往外还有集成服务(ETL)、分析服务(多维与表格模型)、报表服务这组 BI 兄弟。新版本把不少外围能力收编进了引擎本体,但代理作业与复制的地位至今无可替代。
协作式调度:一个需要换脑子的设计
操作系统调度线程用抢占式:时间片用完就换人,谁也别想独占 CPU。SQL Server 的 SQLOS 反其道而行——工作线程运行在协作式调度器上,只有主动"让出"(yield)时才轮到别人。为什么这么设计?数据库线程频繁访问共享结构(缓冲池页、锁哈希表),抢占式切换会产生大量需要善后的中断点;协作式让线程在安全点让出,上下文切换成本低得多,吞吐更高。
代价是:一个不让出的任务能霸占调度器。长 CPU 密集查询、.spinlock 争用、某些 CLR 代码,都可能表现为"一个查询拖慢整台机器"。经典症状是调度器上出现大量可运行任务却只有少数活跃工作者,等待类型 SOS_SCHEDULER_YIELD 攀升。值班遇到"CPU 不高但吞吐掉底"的怪象,先想到协作式调度这个特性,再查谁在长时间不让出。
-- 调度器取证:有几个调度器、多少工作者、多少在排队 SELECT scheduler_id, cpu_id, is_online, current_tasks_count, runnable_tasks_count, work_queue_count, load_factor FROM sys.dm_os_schedulers WHERE scheduler_id < 1048576; -- 排除内部调度器 -- runnable_tasks_count 长期大于 0 且攀升:任务在排队等 CPU 让出, -- 结合 sys.dm_os_waiting_tasks 里 SOS_SCHEDULER_YIELD 的占比,基本可锁定 CPU 密集负载。
计划缓存:用空间换决策时间
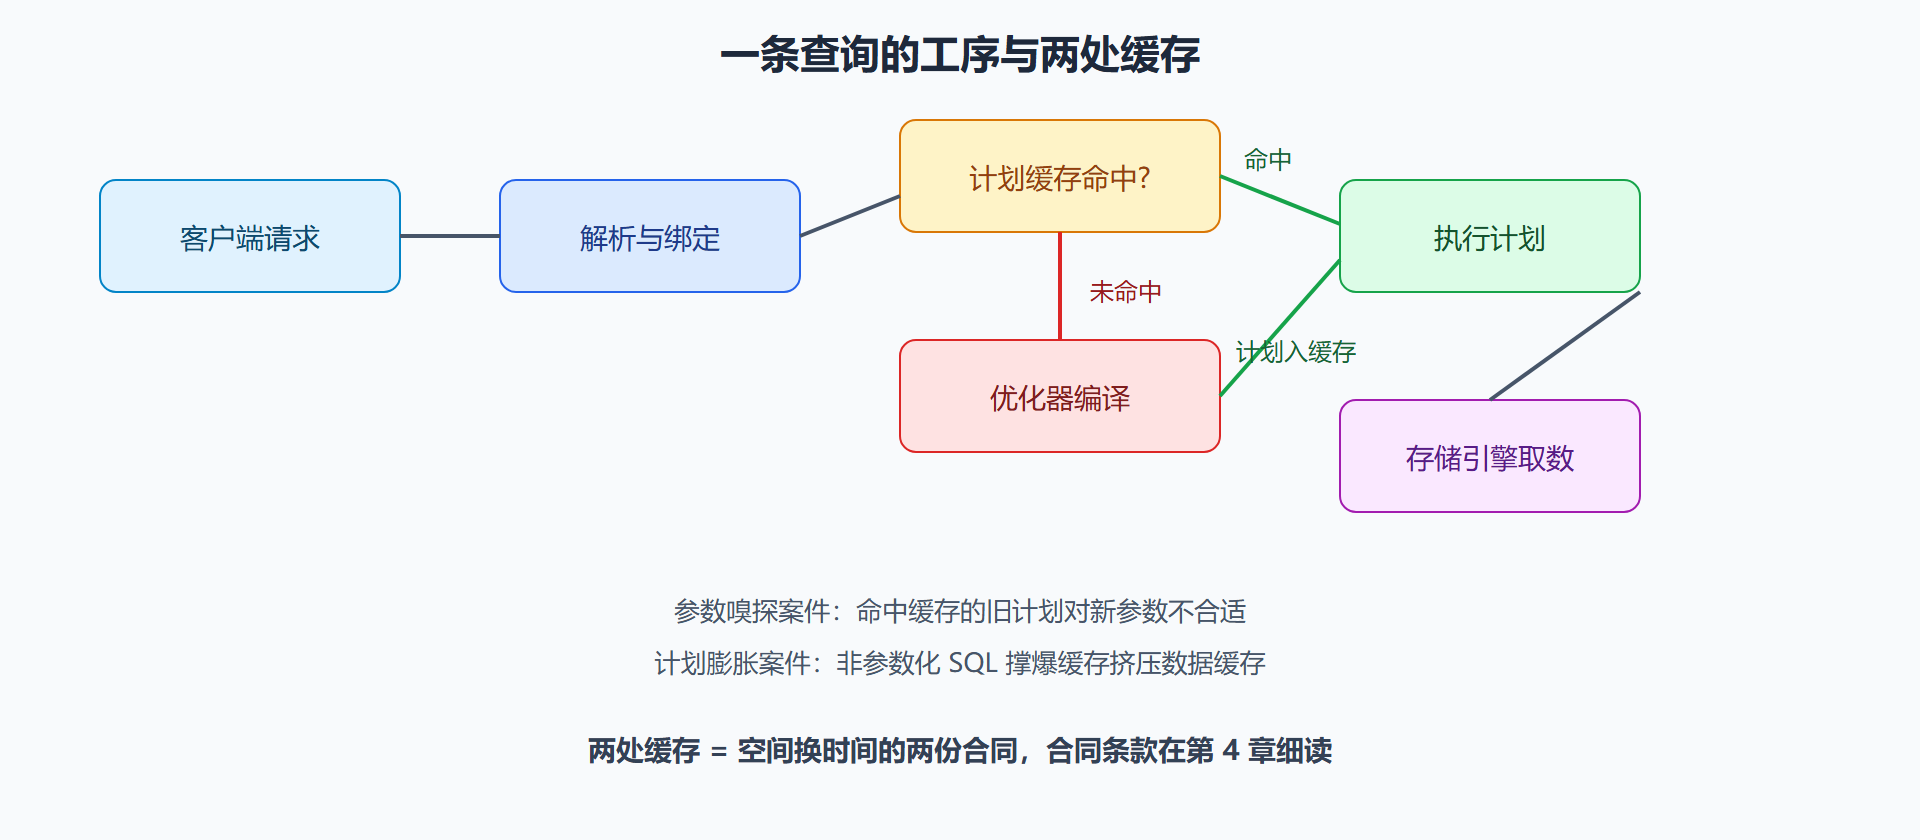
优化一条复杂查询的代价可能远超执行它——所以优化器产出的计划会被缓存复用,这是"计划缓存"机制。它带来两个工程后果。其一是参数嗅探:同一段参数化 SQL,首次编译时的参数分布决定了计划形状,后续参数进来直接复用;当参数分布极不均匀(比如客户ID有的大户有百万订单,有的散户三五行),缓存的计划对某些参数就是灾难。其二叫计划膨胀:ORM 生成的海量非参数化 SQL 会把缓存撑爆,挤占本可用于数据缓存的内存。第 4 章会专门给出这两类案件的完整侦破过程,这里先记住机制本身。
图 2-2 从请求到结果集的工序与缓存
一次值班推演:从架构图到病灶
把架构图用起来。周三上午,业务方报告"系统全慢"。按流水线顺序走一遍:先排除协议层——连接数正常、无认证风暴;再看关系引擎——计划缓存命中率正常、无编译风暴(否则批量重编译的告警会先亮起来);然后到存储引擎——发现等待统计里 WRITELOG 与 PAGEIOLATCH 都不高,但 SOS_SCHEDULER_YIELD 占了近四成;最后落到 SQLOS——某调度器上有一个跑了八分钟的聚合查询反复让出,同一 NUMA 节点的轻量任务全在排队。处理:与业务方协调给该查询加会话级资源限制(资源调控器),并推动开发给聚合加预聚合表。全程每一步都能在架构图上指出"我现在查的是哪一层"——这就是本章真正要交给你的东西:一张能定位任何故障的地图。
再进一层:NUMA 与调度器的亲缘关系
多核服务器如今都是非一致内存访问(NUMA)架构:每个 CPU 节点挂自己的本地内存,访问远端节点的内存要贵一个量级。SQLOS 按硬件 NUMA 拓扑建立调度器,并尽量让任务用本地内存页——这就是为什么跨节点的内存访问比例值得监控。两个运维含义:其一,大型并行查询若被调度到多个节点,节点间的内存远端访问会拉低效率,这也是控制最大并行度的一个考量;其二,某些内存表与缓冲池配置支持按节点绑定,混合负载下能减少跨节点流量。排查"CPU 平均不忙但个别核忙"的问题时,按调度器分组看指标,比看整机平均更接近真相——8.2 的误诊案正是这个视角的实战。
另一个值得记录的细节是热添加内存与热添加处理器:少数环境开启了在线增配,但 SQLOS 对运行中变化的 NUMA 拓扑支持有限,生产实践更稳妥的做法是在维护窗口完成硬件变更,让实例重启后按新拓扑重建调度器与内存节点。
本节要点回顾
- 四层流水线:协议层收请求、关系引擎做翻译与决策、存储引擎管搬运与记账、SQLOS 是传送带控制器;
- 协作式调度:线程主动让出才切换,吞吐高但怕独占,SOS_SCHEDULER_YIELD 攀升是它的指纹;
- 编外员工:代理作业管自动化、复制管分发、全文检索管文本,办案时它们常是"隐藏关联人";
- 计划缓存是双刃:省编译时间,但带来参数嗅探与缓存膨胀两类案件,卷宗在第 4 章;
- 办案方法:沿流水线逐层排查,每一步说出"在查哪层",避免无从下手的乱翻。
流水线的地图有了,本节的最后一个问题:给这条流水线供血的两条线——内存与磁盘 I/O——怎么管理?下一节专讲。