2.2 内存与 I/O 管理:缓冲池的运作与调校
2.2 内存与 I/O 管理:缓冲池的运作与调校
本节摘要:SQL Server 把几乎所有可用内存都拿来做数据缓存(缓冲池),用"先记账再改页"的方式协调内存与磁盘。本节讲清缓冲池的工作循环、检查点与惰性写入器的分工、最大服务器内存的设置依据,并给出判断内存压力的第一组指标。这一节是全书性能办案的最高频现场。
先立一个反直觉的观点
很多从应用开发转来的工程师把数据库内存当"仓库",以为数据都该装进去。更准确的图像是"剧场前厅":磁盘是坐满观众的会场,缓冲池是容纳少数人的前厅,谁被叫到(被访问)谁进前厅,前厅满了就请最久没露面的人退场。理解了这个模型,"为什么内存加了还慢""为什么每次查询都读盘"这类问题就有了提问的框架:要么前厅太小(内存不足),要么人流太杂(访问模式太随机),要么进出通道太窄(I/O 子系统慢)。
缓冲池的工作循环
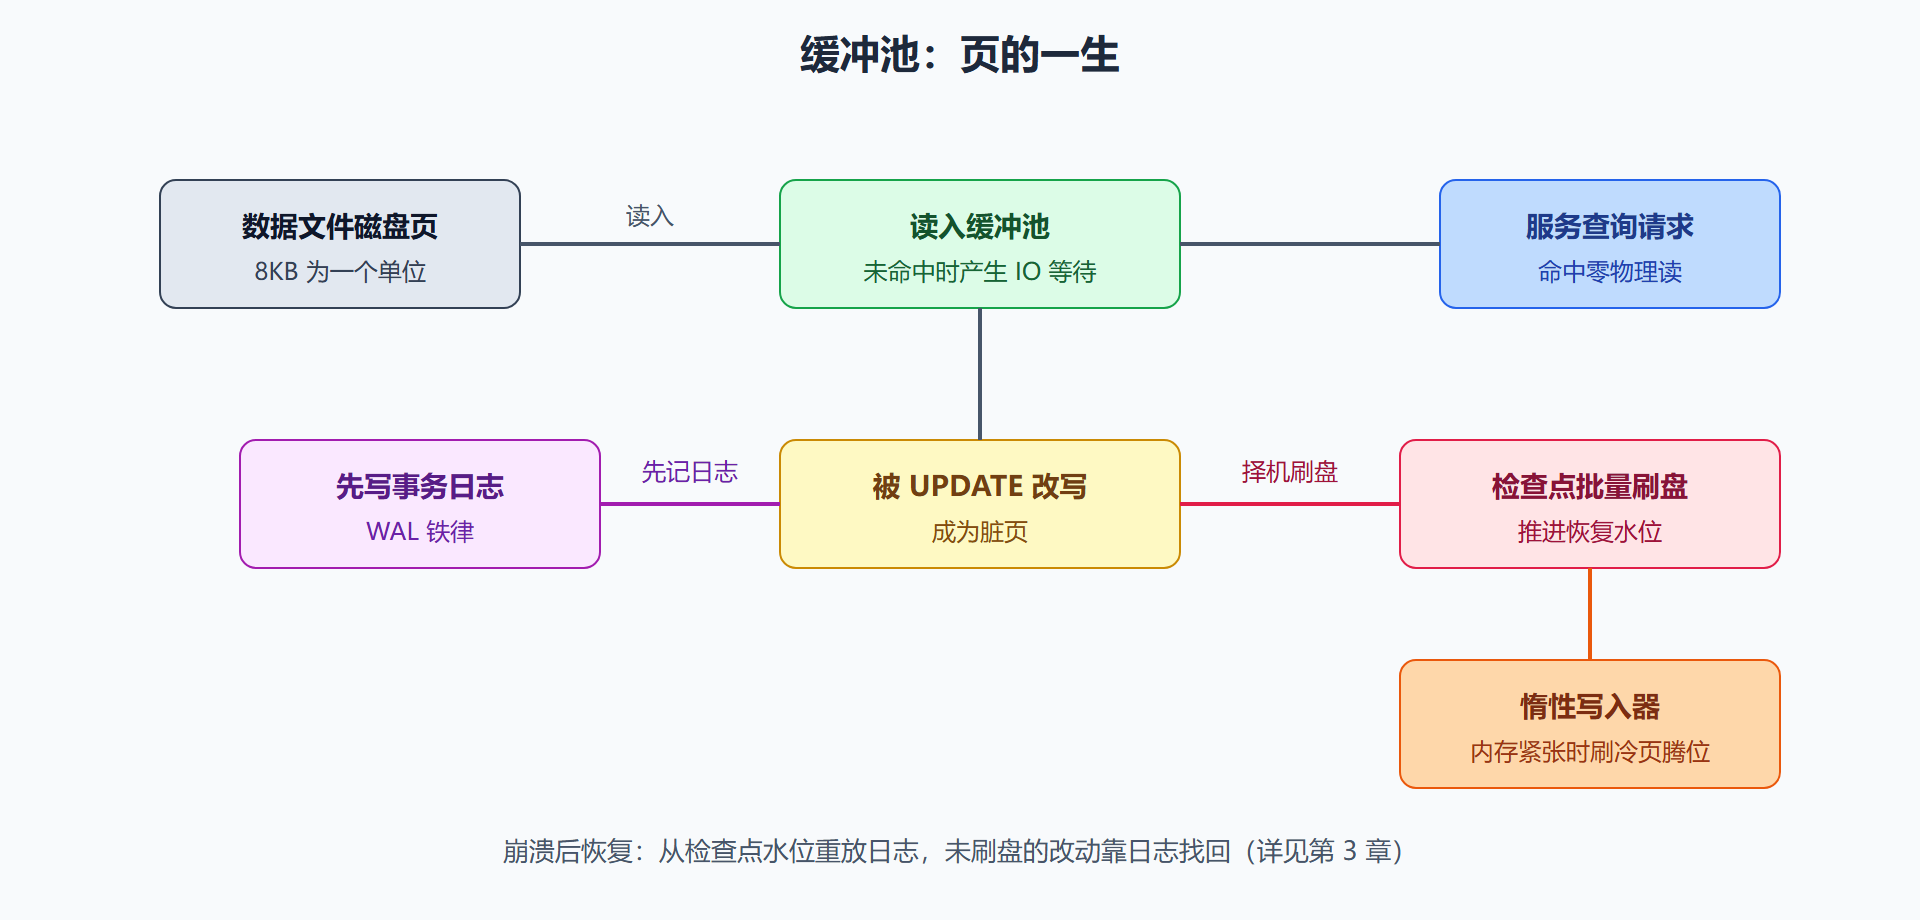
一切以 8KB 页为单位。查询需要某页时,先在缓冲池找;找不到(缓存未命中)就从数据文件读入,这次读的成本就是后面第 8 章会反复出现的 PAGEIOLATCH 等待。页进入缓冲池后,修改不会立刻写回磁盘——被改过的页叫脏页,脏页在内存里继续服务请求,落盘交给两位清洁工:检查点按节奏把足够旧的脏页批量刷盘,推进"检查点 LSN"水位,保证崩溃恢复不用从头扫日志;惰性写入器在空闲内存吃紧时提前把冷脏页刷出去腾地方。两者一个为恢复速度服务,一个为内存供给服务,写入路径还有第三个角色"预写日志"(WAL)约束:任何脏页落盘前,对应的日志必须先落盘——这就是第 3 章崩溃恢复能成立的前提。
图 2-3 缓冲池页生命周期与两条落盘路径
内存压力的三个体征与一剂处方
判断内存压力,用三个指标交叉验证。第一是页面预期寿命(PLE):一页在缓冲池平均停留的秒数,健康实例动辄数千;PLE 骤降说明有大量页被快速换进换出——要么来了一个巨大的扫描查询把前厅冲了一遍,要么内存真不够了。第二是缓冲池命中率:命中率从 99% 掉到九成出头的意义远大于长期 95% 的意义,要看趋势不看绝对值。第三是内存授予等待(RESOURCE_SEMAPHORE):查询要排序或哈希时申请工作内存,申请不到就排队,这个等待攀升说明"工作内存"而不是"数据缓存"紧张。
-- 三个体征一条查齐 SELECT (SELECT COUNT_BIG(*) FROM sys.dm_os_buffer_descriptors) * 8 / 1024 AS 缓冲池占用MB, (SELECT cntr_value FROM sys.dm_os_performance_counters WHERE counter_name = 'Page life expectancy' AND object_name LIKE '%Buffer Node%') AS 页面预期寿命秒, (SELECT cntr_value FROM sys.dm_os_performance_counters WHERE counter_name = 'Buffer cache hit ratio') AS 命中率分子; -- 命中率需要与 Buffer cache hit ratio base 配对相除,或直接看监控平台的比率图。
处方在配置层。最大服务器内存(Max Server Memory)限的是缓冲池及相关缓存的规模,不是实例进程的全部内存。共识做法:给操作系统与其他进程留出 4 至 8GB(或总内存的一到两成,取大者),其余交给实例——192GB 的专用数据库服务器,设 176GB 左右是常见起点。设置过小浪费内存,过大则 Windows 文件缓存与备份进程被挤到换页边缘,整机卡顿。多实例共居一台服务器时,务必给每个实例分别设上限,否则先来的实例会吃到撑,后来的实例饿肚子。
一次内存办案的完整卷宗
月末结账日,财务库查询延迟翻倍。值班记录如下:先看等待统计,PAGEIOLATCH_SH 高居第一——读盘等待严重,方向指向缓冲池失效;再看 PLE,从平时的五千秒跌到两百秒,坐实"前厅被反复冲刷";追凶用这条查询找出谁在大量读页:
SELECT TOP 5 r.session_id, r.logical_reads, r.reads, t.text AS 语句片段, r.start_time FROM sys.dm_exec_requests r CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) t ORDER BY r.logical_reads DESC; -- 凶手:一条 SELECT * 的月末汇总查询,缺索引导致扫描两张千万行表, -- 一次性把几十 GB 的页灌进缓冲池,把热页全部冲走。
处理分三步走:当场与业务方沟通错峰,先让结账跑完;次日给汇总查询补上覆盖索引,逻辑读降两个数量级;一周后把类似大扫描纳入资源调控器工作负载组限制内存授予。结案归档写了一句话:内存问题多数不是内存的错,是扫描查询的错;先补索引、再谈扩容,是成本最低的顺序。
tempdb 的配置清单
tempdb 值得在本节末尾单独立一张配置卡,因为它是内存与 I/O 的交汇处:排序与哈希溢写是它的 I/O,版本存储是它的内存压力来源。五项配置一次到位——初始大小给足(避免上线后频繁自动增长,8GB 起步是常见口径);数据文件按核数摊(四到十六个之间取值,均等大小,摊开页分配争用);放在最快的盘上(它的 I/O 几乎全是随机小量读写,实例重启即清空,不值得省好盘);监控使用率(按会话与对象拆解版本存储占用);禁用自动收缩(收缩又膨胀的循环只会制造碎片)。这张卡与 3.1 的文件规划合起来,构成新实例初始化的完整清单。
本节要点回顾
- 缓冲池是前厅不是仓库:页按需进出,8KB 一个单位,未命中才读盘;
- WAL 是落盘铁律:脏页刷盘前对应日志必须先落盘,这是崩溃恢复成立的前提;
- 检查点与惰性写入器分工:前者为恢复速度推进水位,后者为内存供给清冷页;
- 三个内存体征:PLE 骤降、命中率趋势下滑、资源信号量等待攀升,交叉验证再下结论;
- 最大服务器内存:留给系统 4 至 8GB 或一到两成取大者,多实例必须分别设限;
- 先补索引再扩内存:大扫描冲刷缓冲池是最常见的"伪内存不足"。
内存与 I/O 这条生命线理顺了,下一章我们把镜头再拉近:磁盘上那一个个 8KB 的页、成组的区、组织数据的堆与 B 树,到底长什么样——存储引擎与索引设计,是索引优化一切讨论的原点。