2.1 CPU核心结构拆解
2.1 CPU核心结构拆解
本节摘要:CPU 是单片机的执行核心,由运算器、控制器与寄存器组三大部分构成,靠"取指—译码—执行"循环驱动一切。本节拆开这颗心脏看三大部件如何协作,解释程序计数器为什么是理解程序行为的钥匙,并说明流水线如何让执行效率翻倍、又在什么场合翻车。这是第 3 章"指令与执行"的硬件底座。
一个反例开头:程序"跑飞"了,问题出在哪
一块运行中的板子偶尔死机,复位后一切正常。新手怀疑编译器,老手先查两处:程序计数器(PC)是否被意外改写、堆栈是否被冲破。为什么老手直奔这两个目标?因为这两样东西是 CPU 结构里最"脆"的命门——理解了 CPU 内部结构,你对故障的想象就有了解剖图,而不是对着黑箱念咒。本节的任务就是把这张解剖图交给你。
三大部件:干活的、指挥的、记事的
**运算器(ALU)**是干体力活的。加、减、与、或、异或、移位、比较——MCU 上八成的指令最终都落到它身上。它有两个"进出口":进来的操作数、出去的结果与状态标志。状态标志值得多看一眼:进位标志 C、零标志 Z、负数标志 N、溢出标志 V,它们是条件跳转指令的判断依据。C 语言里一行 if (a > b),到了硬件层面就是一次减法加一次对标志位的查询——高级语言的逻辑判断,物理本体是 ALU 顺手留下的几个标志位。
控制器是指挥部。它从指令译码器接收"当前这条指令要干什么",然后按节拍发出一串控制信号:打开哪个寄存器的门、ALU 执行哪种运算、结果写到哪去。CISC 与 RISC 的分野在这里最直观:8051 的控制器要应对两百多条长短不一的指令,而 Cortex-M 靠相对整齐的指令集把译码电路做得又快又省电。
寄存器组是 CPU 手边的记事本。距离运算单元最近、访问零等待。按用途分两类:通用寄存器,存放正在参与运算的数据,数量越多、编译器越能少跑内存;专用寄存器,各司其职,其中三个必须认识——程序计数器 PC(存放下一条指令的地址,程序流动的方向盘)、堆栈指针 SP(指向栈顶,函数调用的后台账房)、状态寄存器 PSR(收容 ALU 的标志位)。
取指(从Flash读指令) 译码(控制器翻译) 执行(ALU运算) ┌─────────────────┐ ┌─────────────────┐ ┌─────────────────┐ │ PC 指向 Flash │───►│ 指令译码器 │───►│ ALU + 寄存器组 │ │ 取出指令码 │ │ 产生控制信号 │ │ 读写数据与标志 │ └─────────────────┘ └─────────────────┘ └────────┬────────┘ ▲ │ │ PC 自动加一,指向下一条 │ └─────────────────────────────────────────────┘
程序计数器:理解一切程序行为的钥匙
PC 值得单独一节,因为嵌入式里大量"玄学现象"最终都落在它身上。正常运行时,PC 逐条加一,程序顺序流动;遇到跳转指令,PC 被直接赋值为目标地址,程序改道;遇到函数调用,返回地址先压栈再跳转;遇到中断,硬件强制把 PC 指向中断入口。所谓"程序跑飞",就是 PC 的值被写坏(野指针、栈溢出、电磁干扰都可能),CPU 从一个不该取指的地址开始执行随机数据。调试器单步运行时,本质上就是在盯着 PC 的值一步步走——理解了 PC,你就在程序文本与硬件执行之间架起了第一座桥。
用一小段伪汇编感受 PC 的流动:
; PC 值 指令 行为 0x0800 MOV R0, #5 ; 取指后 PC 变为 0x0804 0x0804 ADD R0, R0, R0 ; 顺序执行,PC 变为 0x0808 0x0808 B 0x0810 ; 跳转:PC 直接改为 0x0810 0x080C ;(被跳过,永不执行) 0x0810 SUB R0, #1 ; 从这里继续
流水线:让取指与执行并行的流水作业
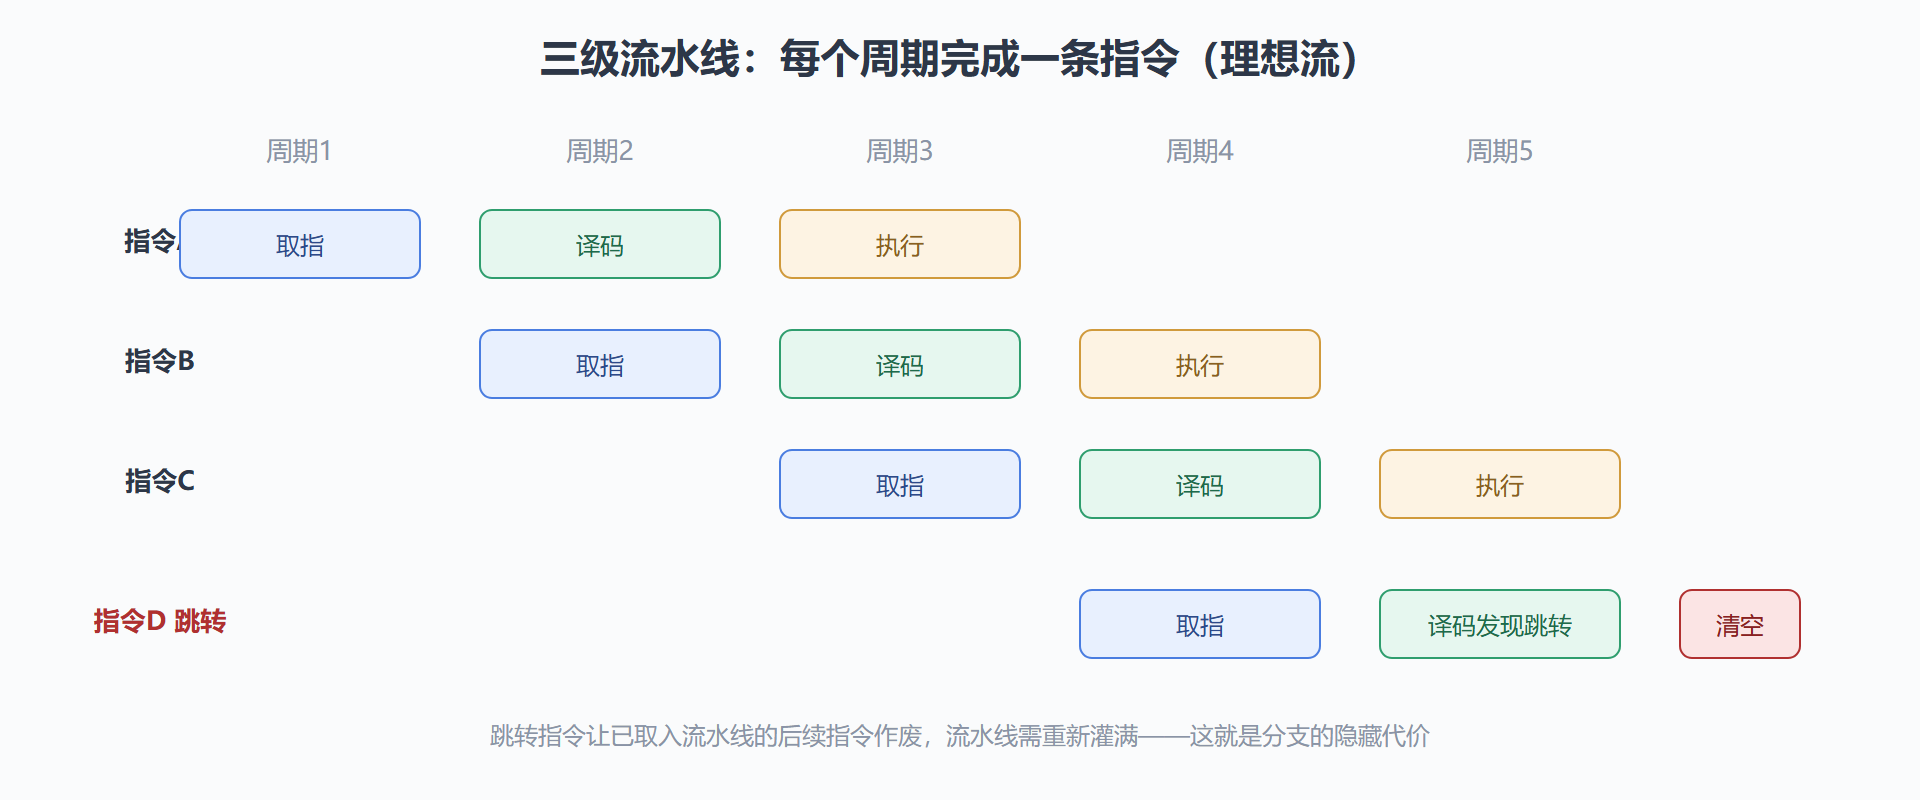
三步循环串行跑的话,CPU 大部分时间在等:取指时 ALU 闲着,执行时取指通路闲着。流水线的思路与工厂装配线一致——把指令处理切成若干工位,第一条指令进入执行工位时,第二条指令已经进入译码,第三条正在取指。理想情况下,每个时钟周期都能完工一条指令,吞吐率提升数倍。Cortex-M3 采用三级流水线(取指、译码、执行),更高端的内核还有五级以上。
流水线有代价。第一个代价是跳转破坏流水:遇到跳转,已取入流水线的后续指令全部作废,流水线要重新灌满——这就是为什么循环里的分支比顺序代码"贵",也是第 3.2 节要展开的话题。第二个代价是指令与数据抢总线:取指要读 Flash、执行要读写 RAM,总线仲裁的细节决定了实时性的下限,这为 2.2 存储系统的学习埋下伏笔。
图 2-1:三级流水线指令推进示意
寄存器与指令集的配合:一可视化补丁
三大部件如何协同,值得用一个完整指令的视角再串一遍。执行 ADD R0, R1 时:控制器从译码得知"做加法,源 R1,目标 R0";寄存器组把 R0 与 R1 的值送上 ALU 的两条输入通路;ALU 做完加法,结果与四个标志位一起回写;控制器同时把 PC 预增到位。整个链条在一个时钟周期内流水般完成——寄存器间运算是一切指令里最快的一类,因为数据不需要离开 CPU。这也解释了编译器的优化直觉:能用寄存器搞定的事绝不访问内存(访问内存要多等一两个甚至更多周期),能在一个循环外算完的绝不放进循环里。C 代码里 register 提示、循环不变量外提这些优化,本质都是在为"数据离 ALU 更近"创造条件。
理解这个配合关系还有个隐藏福利:看懂手册的"指令周期表"。数据手册的附录通常列着每条指令的周期数,有了部件级的图景,你能看懂为什么访存指令普遍比寄存器指令慢、为什么乘除法在低端内核上要十几个周期——周期数的差异,就是数据搬运距离与电路复杂度的差异。
工程视角:结构知识怎么变成排查能力
把本节知识翻译成实战动作。其一,死机先查栈:局部大数组、递归、中断里套函数,都可能让 SP 越界踩到别的变量,链接生成的内存报告里"栈大小"一栏要养成瞄一眼的习惯。其二,看懂反汇编:调试器里单步走的不是你的 C 代码而是指令流,理解 PC 与流水线后,断点落在哪、为何跳过某行,都有了物理解释。其三,估算执行时间:顺序代码一条指令约一个周期,分支、访存要打折——这个感性认识在后面定时器与通信时序章节会反复用到。
💡 关键直觉:CPU 不是黑箱魔法,它只是一台严格按 PC 指引、以时钟为节拍、在寄存器与 ALU 之间搬运数据的机器。你写的每行 C,最终都化成这台机器的搬运动作清单。
常见疑问两则
问题:两颗芯片主频相同,为什么实测速度差一大截?
主频只是节拍器的快慢,每个节拍里干多少活取决于结构。因素至少有四个:流水线级数与分支预测能力、指令的编码效率(同样的 C 代码编译后谁的指令更少)、存储器等待周期数(Flash 跑不满主频的内核要插等待拍)、以及总线位宽与 DMA 分担能力。所以数据手册里"每条指令周期数"表与存储加速模块的说明,往往比主频数字更值得读——这也是"位数不是性能全部"在结构层面的解释。
问题:调试器为什么能让运行中的芯片停下来?
靠的是内核里的调试模块:它监视地址或数据匹配事件,命中后请求内核挂起——CPU 停在当前拍、寄存器现场保持、外设可以继续跑或同步暂停。单步运行本质是"跑一条、停一拍"的重复挂起。理解了这一点,你就能明白为什么某些低功耗模式下调试器会掉线(内核时钟被关,调试模块跟着断粮),也能明白断点为什么打在 Flash 里的代码才可靠。
本节要点回顾
- 三大部件:ALU 干运算并留标志,控制器译码发号,寄存器组提供零等待的临时存储。
- PC 是方向盘:顺序执行时自动加一,跳转、调用、中断都会强行改写它;跑飞就是 PC 失守。
- 流水线提升吞吐:多工位并行让理想流每周期完工一条指令;代价是跳转清空流水、总线竞争。
- 标志位是条件判断的物理本体:
if语句的硬件真相是一次减法加标志查询。 - 体系位置:本节讲的是"算的机构",下一节看"记的机构"——程序与数据在存储器里如何安家。