5.3 中断服务程序设计:纪律与协作模式
5.3 中断服务程序设计:纪律与协作模式
本节摘要:中断服务程序(ISR)是运行在"被打断的程序之上"的特殊代码,它有独特的纪律:短小、无阻塞、通过标志与主循环协作、对共享数据设防。本节把纪律逐条讲透并解释每条背后的硬件原因,给出裸机编程最安全的协作模式,示范 volatile 与临界区的正确用法。这是全章的实践核心——5.4 节的故障都是违反本节纪律酿成的。
先明确处境:ISR 运行在什么特殊状态
写 ISR 前先认清它的处境,每条纪律都由此推导。其一,你打断了别人:主循环(或更低优先级 ISR)被你暂停在半空,它的时间被你占用——所以你要快。其二,你随时可能被打断:更高优先级中断随时插入,你的执行时间不可预测地拉长——所以你不能依赖连续执行的前提。其三,你没有返回值与参数:硬件跳进来时不会传给你什么,主循环也收不到你的 return——所以 ISR 与外界的通信只能靠全局变量或外设寄存器。处境决定纪律,纪律不是美学偏好,是从硬件机制里长出来的生存法则。
四条纪律逐条过
纪律一:短小,只做必须立刻做的事。 ISR 的时间账直接写进全系统的最坏响应时间(5.1 的延迟公式)。"必须立刻做"的清单通常很短:读数据寄存器(不清就走)、清中断标志(不清就一直重进)、置一个通知标志、必要时做时间戳登记。其余一切——解析、计算、打印、决策——搬去主循环。
纪律二:无阻塞等待。 ISR 里禁止任何"忙等":等发送完成、等应答、延时函数,都是拿全系统的响应时间做燃料。典型反例是 ISR 里调 printf——多数实现内部自旋等待,一次调用可能占几百微秒;正确做法是往发送缓冲区塞数据、置标志,让主循环或发送空中断慢慢发。
纪律三:与主循环用标志协作。 4.5 节的"中断置标志、主循环干活"模式在这里升格为标准范式:
/* 标准协作范式:ISR 置标志,主循环消费 */ volatile uint8_t tick_flag = 0; /* volatile:见下文 */ void TIM2_IRQHandler(void) /* ISR:只干三件事 */ { TIM2->SR &= ~TIM_SR_UIF; /* 1. 清中断标志 */ tick_flag = 1; /* 2. 通知主循环 */ sys_ticks++; /* 3. 时基累加 */ } int main(void) { for (;;) { if (tick_flag) { tick_flag = 0; /* 主循环消费标志 */ do_periodic_work(); /* 重活在这里干 */ } idle_or_other_tasks(); /* 其余业务 */ } }
纪律四:共享数据设防。 ISR 与主循环共享变量时,两件事必须做,缺一不可。第一件:共享变量加 volatile 修饰。它告诉编译器"这个变量随时会被你看不见的执行流改动",禁止把读取优化进寄存器缓存。不加 volatile 的经典事故:主循环 while (!flag); 被优化成只读一次 flag 的死循环——编译器看不到 ISR 会改它。第二件:多字节或多步骤的共享访问要临界区保护,原因见下。
竞态的三个前提与临界区的两种武器
竞态发生的必要前提有三条:存在共享资源、存在至少两个访问方、访问中存在"中间态"(读改写、多字节、先查后改)。三条同时成立,交错执行就可能踩踏。
主循环与 ISR 之间的典型踩踏:主循环正在执行 counter++——这条 C 语句编译后是"读、加、写"三条指令,读到一半 ISR 插入并把 counter 改了,主循环接着用旧值写回,ISR 的修改被无声覆盖。单字节的标志位读写是原子的(一条指令完成),无需保护;但 32 位以上的数据、结构体、队列、先查后改的逻辑,都要保护。
武器一:关中断临界区。进入共享访问前关闭中断(或只关相关中断源),访问完立即打开。简单可靠,但窗口要短——窗口越长,5.1 说的响应延迟越糟。
/* 武器一:关中断保护共享结构体的更新 */ disable_irq(); status.timestamp = get_ticks(); /* 多字段更新是一个整体, */ status.value = sensor_raw; /* 中途被打断会被读到半新半旧 */ status.valid = 1; enable_irq();
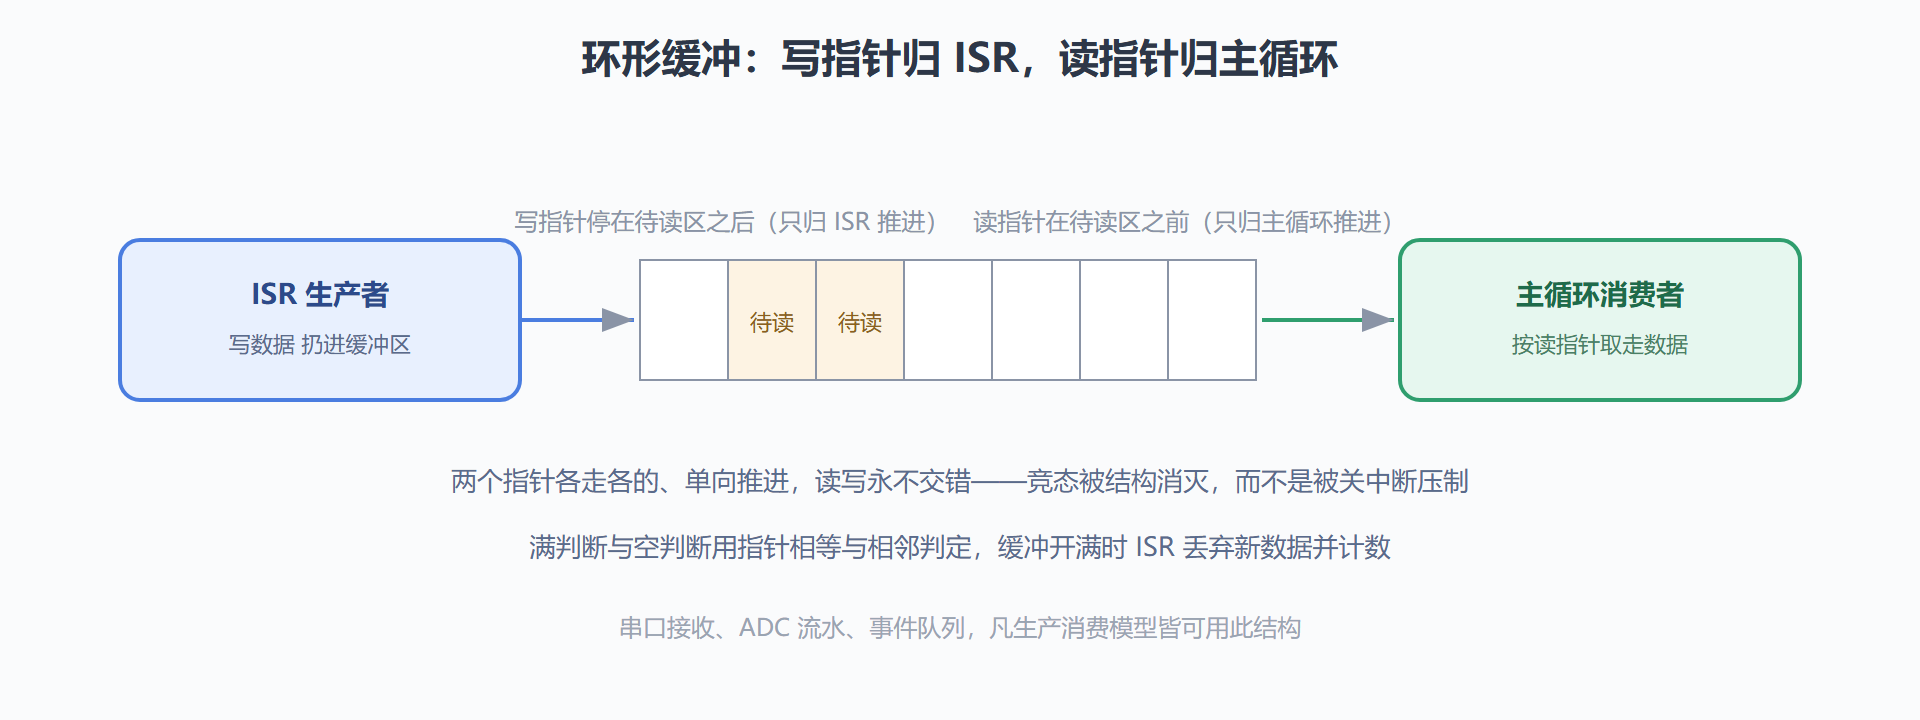
武器二:环形缓冲区。让 ISR 只写写指针、主循环只读读指针,单向推进、各自独立,天然免锁。串口收发、ADC 数据流的标配方案,比关中断高效得多——能用缓冲解的竞态,就不要用关中断解。
/* 武器二:环形缓冲区,免关中断的生产消费 */ void USART1_IRQHandler(void) /* 生产者:ISR 只推进写指针 */ { rx_ring[rx_head] = USART1->DR; /* 读数据顺带清标志 */ rx_head = (rx_head + 1) % RING_SIZE; /* 单向推进 */ } uint8_t ring_pop(void) /* 消费者:主循环只推读指针 */ { uint8_t c = rx_ring[rx_tail]; rx_tail = (rx_tail + 1) % RING_SIZE; return c; }
图 5-2:环形缓冲区的免锁协作
常见反模式清单
⚠️ 五个高频反模式,看到就该警觉:ISR 里调用 printf 或任何阻塞发送;ISR 里做浮点运算与复杂解析(慢,且部分内核要软件保存浮点寄存器,更慢);ISR 里调用非可重入的库函数(被打断重入后内部状态错乱);在 ISR 与主循环共享多字节变量却不加 volatile 或不加保护;用全局中断开关当万能锁、把临界区开到几十条语句长。每一条对应的症状分别是:偶发丢数据、中断延迟超标、随机死机、变量神秘错值、低优先级中断集体饿死。
HAL 回调与手写 ISR:两层皮的关系
用库开发的读者会注意到:HAL 库里你写的常是"回调函数"(如串口接收完成回调),而不是向量表指向的真 ISR。理清两层关系能避免大量困惑。真正的 ISR 是库实现的:它先读外设状态寄存器判断事件类型、清标志,再调用你注册的回调——回调只是 ISR 的"下半段"。这个分层的代价与收益都要看清:收益是可移植(换芯片不改业务回调)与事件分类省心;代价是每次中断多一层函数调用与状态判断,且回调依然运行在中断上下文里——ISR 的四条纪律对回调一字不改地生效。实际工程里的高频事故正是忘了这一点:有人在回调里慢慢腾腾处理协议,以为"我写的是普通函数"。判断标准就一条:你的代码被谁调用,你就活在谁的上下文里。第 6 章讲 RTOS 时会给出更彻底的解法——把重活搬到任务里,回调只做"投递"。
问题:ISR 里能不能调用自己写的普通函数?
能,但要过三道检查。一看时长:被调函数的全部执行时间都算进 ISR 的账,一个"顺手"的格式化函数可能让 ISR 从两微秒膨胀到两百微秒。二看重入:该函数是否也被主循环调用?若是,它操作的内部状态(静态缓冲、标准库内部锁)在被打断重入时就可能错乱——要么保证它只被一侧调用,要么把它做成无静态状态的可重入纯函数。三看阻塞:函数内部有没有等待循环(等发送完成、等标志位置位)?ISR 里的任何等待都是死等——没有人来置位。三道检查全过,函数才能进 ISR;过不了就把它"搬家"到主循环,ISR 只留置标志与收数据。这条问答其实是四条纪律的另一种说法:纪律约束的是 ISR 的执行时间总量,不管代码在不在同一个函数里。
本节要点回顾
- 处境决定纪律:打断别人所以要快、随时被打断所以不依赖连续性、无参数无返回所以靠全局通信。
- 四条纪律:短小、无阻塞、标志协作、共享设防——每条都能从硬件机制推导出来。
- volatile 是给编译器的声明:不加它,主循环的等待循环可能被优化成死循环。
- 两种防竞态武器:关中断临界区简单有效但要短;环形缓冲用结构消灭竞态,能缓冲就不关中断。
- 体系位置:纪律建立完毕,下一节看违反纪律的真实代价——两例中断丢失与竞态故障的完整解剖。