5.4 中断丢失与时序竞态排错实录
5.4 中断丢失与时序竞态排错实录
本节摘要:中断类故障有两大惯犯——偶发丢事件与共享数据神秘错值,它们都满足"低复现率、强随机性、桌面测试难现形"的作案特征。本节用两个真实项目的完整排查过程当教材:从现象记录、假设清单、逐项证伪到根因确认与修复验证,把排错方法论提炼成可复用的路径。读完你能用同样的节奏解剖自己的"玄学故障"。
排错方法论先行:三步走
中断故障的排查最忌"改改试试"——随机改动叠加随机故障,时间花完也未必撞上根因。可靠的方法是三步走。第一步,固定现象:让故障可观测(计数器、事件日志、GPIO 翻转打点),把"偶尔发生"变成"有数据的发生频率与发生条件"。第二步,列假设清单并逐项证伪:把所有可能原因写下来,按验证成本从低到高排序,每项用最小实验证伪或证实——改一个变量,看一次结果。第三步,确认根因后先写复现用例:修复前先能稳定复现,修复后用同一用例验证,否则你不知道是修好了还是碰巧好了。下面两个案例都严格按这个节奏走。
案例一:偶发丢脉冲的计数系统
背景与现象:一台流量计用外部脉冲中断计数,交付测试后客户反馈:日累计量比参考表偏低约千分之二,且偏低量随机。实验室跑整夜却一次错也没有——典型的"现场有、桌面无"。
假设清单(按验证成本排序):一,机械抖动导致重复计数——证伪方向是偏差应偏大而非偏小,且现象是丢不是多,暂缓;二,脉冲间隔低于中断响应能力——查波形即可,成本最低;三,ISR 执行过长导致后续脉冲挂起期间又被新脉冲合并——需要推算 ISR 耗时与最短脉冲间隔;四,临界区关中断窗口吞掉脉冲——查共享数据访问路径。
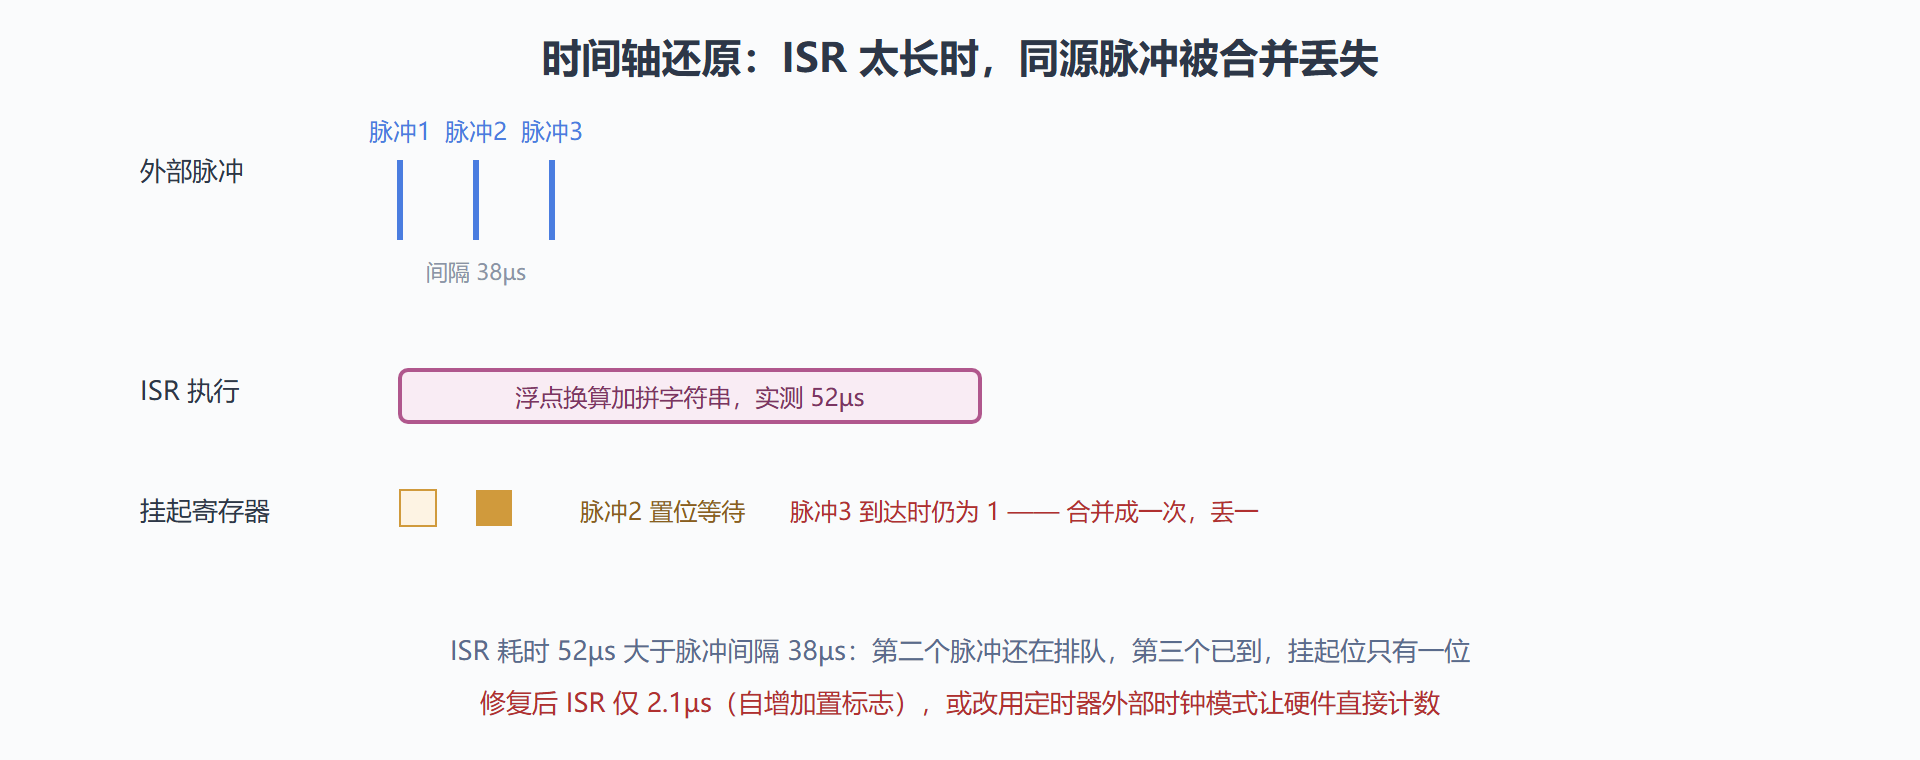
逐项验证:第一步用示波器长期录制脉冲流(带时间戳),现场跑了三天抓到一段异常:两个脉冲间隔 38 微秒。第二步测 ISR 执行时间:打点法(进 ISR 拉高调试引脚、出 ISR 拉低)量得 ISR 执行 52 微秒——已经超过了 38 微秒的脉冲间隔。第三步翻 ISR 代码,找到元凶:工程师在 ISR 里对计数值做了浮点换算并拼了一行显示字符串,"顺手"的 50 微秒。
根因确认:脉冲间隔 38 微秒时,第一个脉冲的 ISR 还没执行完,第二个脉冲虽然被硬件挂起登记,但若第三个脉冲在 ISR 结束前又到——挂起位只有一个,二三次事件合并,净丢一次。这正对上 5.1 节"同源连发合并"的丢失机理。
修复与验证:ISR 瘦身到只剩"计数值自增加置标志"(实测 2.1 微秒),换算与显示全部搬进主循环;同时把计数改为硬件定时器的外部时钟模式(脉冲直接推计数器,完全不占 ISR)。修复后现场连续监测一个月,偏差归零。教训沉淀:ISR 耗时必须实测——打点法五分钟的工作量,很多人从没做过;而"处理速率必须大于事件到达速率"这条 5.1 定律,差的那 14 微秒就是千分之二的损失。
图 5-3:丢脉冲机理的时间轴还原
案例二:结构体字段的神秘错值
背景与现象:一个带串口协议解析的项目,主循环维护一个状态结构体(时间戳、采样值、有效位三个字段),解析任务定期更新,上报任务定期读取。上线初期一切正常,某次改版加入高频率的定时器中断后,上报数据偶发"时间戳是新的、采样值是旧的"——字段之间明显不同步,但每个字段单独看都合法。
假设清单:一,传感器本身出了坏值——证伪:本地日志记录的写入侧数据一直正确,排除;二,解析逻辑有分支漏洞——代码审查未发现;三,上报读到的结构体处于"更新到一半"的中间态——与本例现象高度吻合,优先验证。
验证过程:在结构体每个字段写入处打点(记录写入序号),上报侧同时记录读取序号,抓到一次异常现场:上报任务在读取 value 字段后、读 valid 字段前,被一个高频中断打断,中断处理路径恰好触发了一次结构体更新——读到的三个字段分属两次更新。根因确认:主循环把三字段结构体的读取当成了原子操作,而它实际是多条指令,中断随时可插入;改版前中断频率低,撞上的概率小到从未现形;改版后概率放大,故障现身。
修复与验证:方案按代价递增三选一。最轻:上报侧先复制整个结构体到本地(复制包在关中断临界区里,仅几条指令),后续解析用副本——中断窗口缩到最短。中等:给结构体加序号校验(更新侧递增序号,读取侧复制后核对序号连续)。最重:改为环形缓冲传递。本例选方案一,复现用例连跑十万次无错。教训沉淀:任何"多个字段应该一起变"的数据,读写两侧都必须成块保护;"以前没出过事"只是概率没到位。
提炼:中断故障排查路径图
两个案例走完,把共性提炼成可复用的路径:先固定现象(计数、日志、打点),再按成本排序验证假设,ISR 相关故障优先量两样东西——ISR 实际执行时长(打点法)与事件到达间隔(示波器带时间戳录制);共享数据故障优先画一张"谁在哪条执行流里读写这个变量"的表,凡有两个执行流共见的变量,逐一追问"访问是原子的吗、成块保护了吗、加了 volatile 吗"。修复前先写复现用例,修复后用它收口——没有复现用例的修复,只是下一次故障的倒计时。
💡 关键直觉:中断故障的"随机性"几乎总是假象——真实原因是概率被低估的确定性缺陷。当你把执行时间、到达间隔、临界区长度三个数字量出来,随机性就塌缩成一道算术题。
复盘会的五个追问:把个案变成规范
两案解剖完,最后一步是把教训制度化——个人经验变成团队规范,靠的是复盘时把五个追问问到底。一问"这个 bug 为什么恰好被测出来了"(答不出来的地方就是测试盲区,补一条针对性用例)。二问"同类结构在代码库里还有几处"(案例二的成块读取,搜一遍共享结构体的引用点,往往再揪出两三处隐患)。三问"什么静态手段能在编译期拦住它"(volatile 清单、临界区长度 lint、ISR 耗时上注——能自动化的一律自动化)。四问"故障复现时间从三天缩到三分钟,靠的是哪一步"(把那一步写进排错手册置顶)。五问"如果这发生在量产现场,损失单上的数字是多少"(这一问不是恐吓,是给"规范值得维护"提供预算理由——愿意为质量花时间,从来都是算出来的,不是喊出来的)。五个问题问完,一场故障才算真正结束:代码修了、盲区补了、规范立了、手册厚了一页。
问题:加打印、加断点之后故障就"好了",怎么办?
这是中断类故障最会捉弄人的一面:观测行为本身改变了时序(海森堡式故障)。打印慢、断点停机,恰好把竞态窗口错开,故障被"吓退"。应对思路有三。其一,改用无侵入观测:关键变量经 DMA 周期性搬进一块后台缓冲,或用第二个 GPIO 电平标记状态(逻辑分析仪看),不占 CPU 时间也不停机。其二,拉大压力代替加观测:既然故障是概率性的,就把触发条件加倍——提高事件频率、加长临界区(临时注入延时放大窗口),让故障在可复现的密度下现形,这比反复等待高效得多。其三,接受统计证据:修复后用"连续高压运行 N 小时零错"作为收口标准,而不是"我没再看到"。记住 5.4 的立场:随机性是假象,观测不到只是手段不够。
本节要点回顾
- 三步排错法:固定现象、假设清单逐项证伪、修复前先有复现用例——拒绝"改改试试"。
- 案例一的根因:ISR 耗时超过事件间隔触发同源合并丢失;ISR 耗时必须实测,打点法五分钟搞定。
- 案例二的根因:多字段结构体的读取不是原子操作;成块数据必须成块保护。
- 量化三数字:ISR 执行时长、事件到达间隔、临界区窗口长度——量出来,玄学就变成算术。
- 体系位置:裸机下靠纪律守住的并发秩序,当任务变多、系统变大后还能守住吗?下一章引入 RTOS 与更工程化的开发体系。