4.4 宏基因组时代的数据驱动分类
4.4 宏基因组时代的数据驱动分类
本节摘要:宏基因组把分类学从"先培养后研究"扭成"先见序列后寻活体":扩增子测序清点"谁在场",鸟枪测序与组装分箱拼出"谁的基因组"。本节讲清 OTU 与 ASV 两代清点单元的区别、MAG 的质量标准,以及"数据库投影"这个当代分类学的核心风险——检出的名字,有多少是数据的投影而非知识的确认。
本节是第 4 章的收口,也是全册视角的转折点:到此为止的所有方法都以"拿到活体"为前提,本节的方法第一次系统性放弃了这个前提。代价与红利同样巨大——1.4 节 Candidatus 制度的存在理由、第 5 章多样性规模的来源,都在本节落地。
两代清点单元:OTU 与 ASV
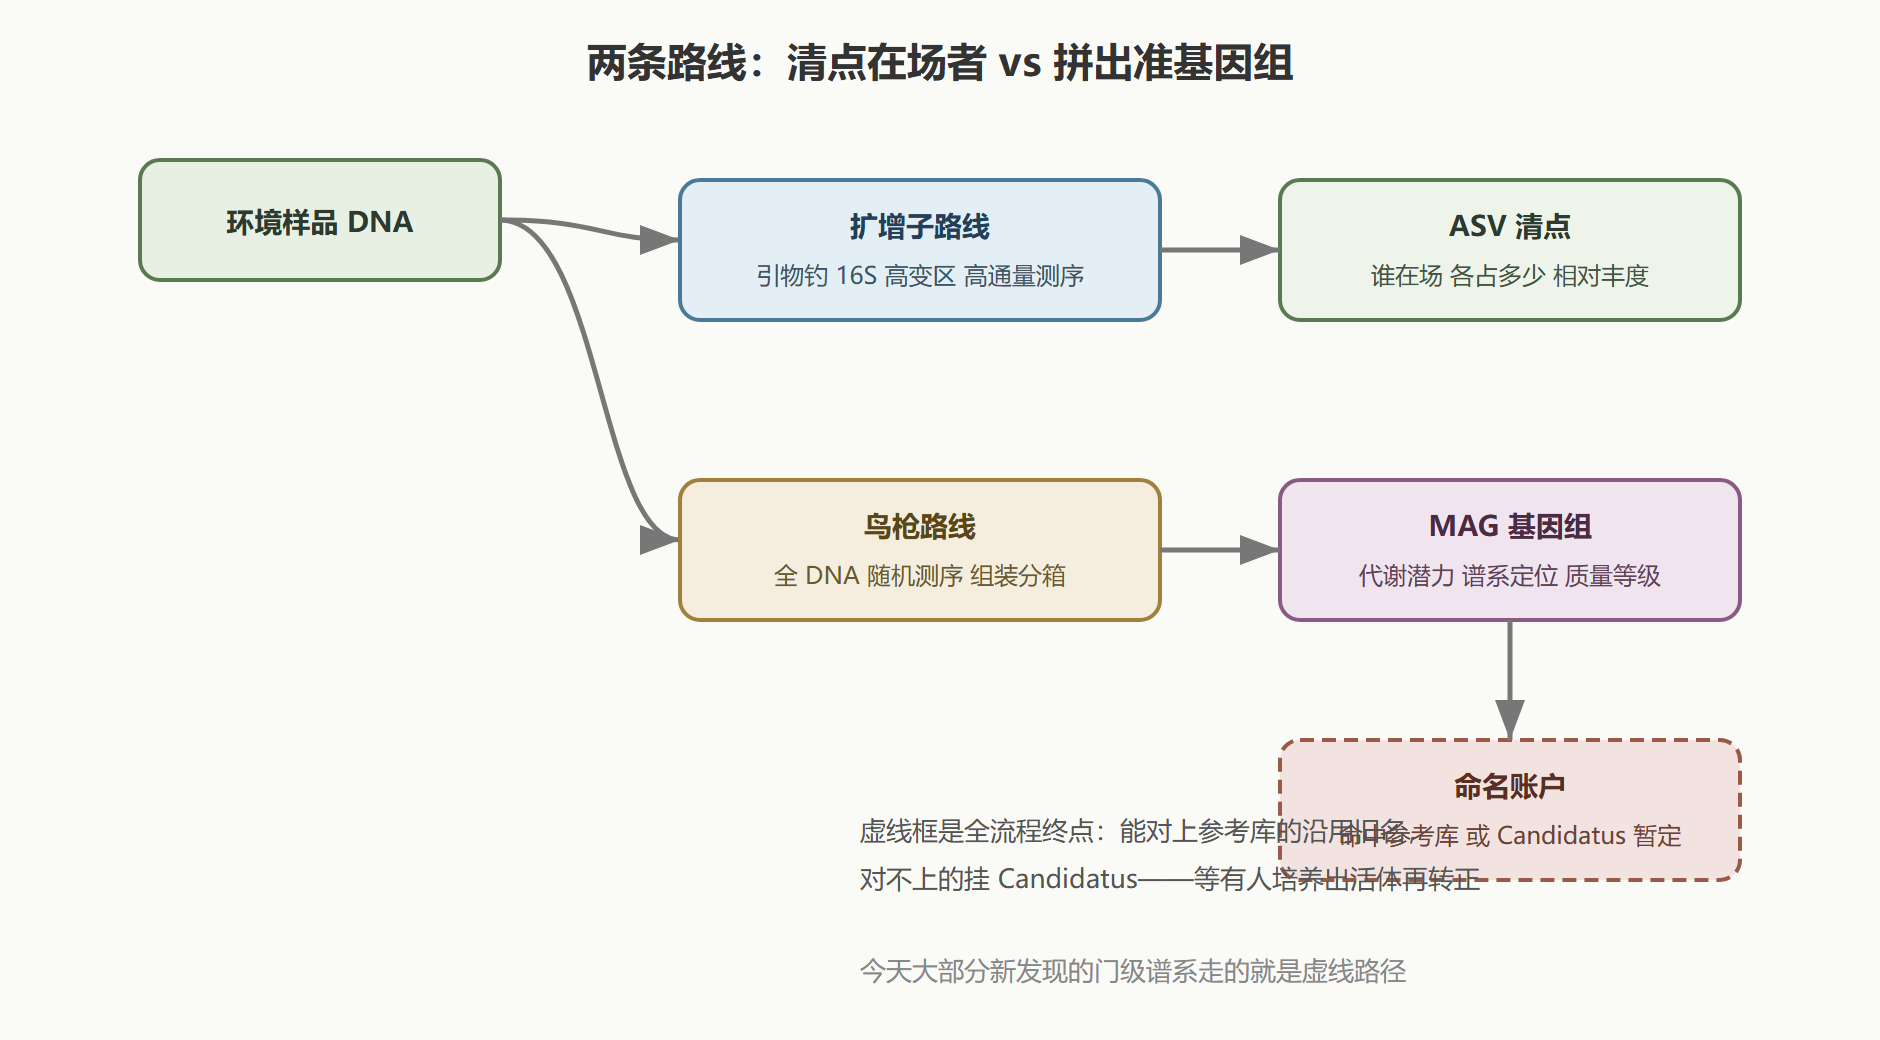
扩增子路线(只测 16S 的高变区)回答"样品里有哪些谱系、各占多少"。清点单元有两代标准。
**OTU(操作分类单元)**是第一代:按序列相似度聚类(常用 97% 一刀切),每簇算一个单元。缺陷内生于聚类:同样 97% 的阈值在不同谱系里对应的生物学边界不一样;两批样品各自聚类的 OTU 还对不上号。
**ASV(扩增序列变异)**是第二代:不再聚类,用算法纠正测序误差后,把每条真实的序列变体直接当作单元。同一序列在不同研究中就是同一个 ASV,跨研究可比;分辨率也不再被人为阈值压扁。
| 维度 | OTU | ASV |
|---|---|---|
| 定义方式 | 相似度聚类 | 去误差后的真实序列变体 |
| 跨研究可比性 | 差(各聚各的簇) | 好(同序列即同单元) |
| 分辨率 | 被阈值压扁 | 直达单碱基差异 |
| 遗留问题 | 已被 ASV 逐步取代 | 拷贝异质与引物偏差仍无法根除 |
注意最后一行:换单元解决不了引物层面的偏差——不同引物钓到的谱系集合不同,两份用不同引物做的研究,结论层面依然要谨慎对接。
MAG:不培养也能拼出基因组
鸟枪路线更激进:把环境 DNA 全部打断随机测序,再用算法把碎片按序列组成与覆盖深度归堆(分箱,binning),每个堆拼出一个宏基因组组装基因组(MAG)。MAG 意味着:不培养任何活体,也能拿到一个谱系的"准基因组"——它的代谢潜力、系统发育位置、乃至新纲新门级别的发现,都从序列直接读出。
但 MAG 有质量等级,读文献必须查这行字。通行标准:完成度不低于九成且污染低于半成算高质量;完成度七成上下、污染半成以内算中等质量。完成度低的 MAG,缺的恰好可能是关键代谢基因——把低质量 MAG 的"没检出某通路"当成"没有该通路",是组学论文审稿意见里的高频批评。
图 1 从环境样品到命名账户的两条路线
数据库投影:检出不等于定名
本节最重要的一课藏在一个朴素的问题里:扩增子报告里那些属名种名,可靠程度各是多少?
要害在于:物种注释是"你的序列 vs 参考库"的比对,结论质量由两边共同决定。参考库本身分层——模式菌株的序列可靠;环境克隆的序列是"某处环境里见过类似序列";更麻烦的是错标序列会把邻近序列整体带偏(4.2 盲区三的放大版)。于是注释结果天然带着置信度梯度:命中级(与模式菌株几乎一致)、属级(属内稳定聚簇)、门级(只能落到高层级)、以及"未知门"——四档信息的可靠度天差地别,而自动注释流水线往往把它们渲染成同等可信的名字列表。
读报告的三个动作:一看注释置信度分档,别让"属级"的结论冒充"种级";二查参考序列的身份(模式菌株还是环境序列);三对关键结论做系统发育验证(建树看位置,而不是只看相似度数字)。
案例一桩收尾:某团队报道"土壤中检出大量某致病菌属序列",引发关注;复核发现其引物非特异扩增了邻近属,参考库命中又指向错标的文献序列——报告里的"致病菌"实为无害近缘。这条新闻级乌龙的三处失守(引物、库、验证)恰好就是本节三个动作的镜像。
选路线决策表与成本账
两条路线怎么选、能不能互相替代,用一张决策表说清:
| 你的问题 | 合适路线 | 产出 | 局限 |
|---|---|---|---|
| 群落里谁在场、比例多少 | 扩增子 | ASV 表与丰度谱 | 只有标记基因片段,代谢信息近乎零 |
| 某谱系的代谢潜力如何 | 鸟枪加分箱 | MAG 与功能注释 | 低丰度菌拼不出、拼出未必高质量 |
| 特定菌的绝对定量 | 扩增子加定量手段 | 每克样品的拷贝数 | 相对丰度表直接换算有系统误差 |
| 发现全新高阶谱系 | 鸟枪加长读长 | 高质量 MAG,可达门级 | 成本最高,样本量要求大 |
成本之外再记一笔"灵敏度账":扩增子路线钓的是引物能配上的序列,引物错配就意味着该谱系在你眼里不存在;鸟枪路线不挑序列但拼装依赖覆盖深度,群落里的稀有种往往读次不够拼不出来。两路线的盲区形状不同——结论里"没检出"三个字的含义,因此完全取决于走了哪条路线。这是读组学论文时比 p 值更要紧的背景信息。
表外还有第三条路线值得一提:全程培养组学(6.4 会再出场)。用高通量手段把环境样品成百上千地平行培养,长出来的直接是活体与命名材料——它绕开了两条测序路线共同的"命名账户"尴尬。代价是成本与覆盖率:多数娇气谱系依旧不出芽。三条路线在现实研究里是投资组合而非单选题,配比取决于你要的是清点、功能还是名分。
一份注释报告的解剖示范
把"读报告三动作"用到一份典型报告上,逐段解剖:
样品注释报告(节选) ASV-0017 占比 12.3% 注释:某属某种(99.1%) ASV-0042 占比 8.7% 注释:某属(96.8%) ASV-0231 占比 5.1% 注释:某科(90.2%) ASV-0588 占比 3.4% 注释:未知门级分支
动作一,分档:四条 ASV 的注释分别落在种级、属级、科级、未知门——报告里它们排在一起,可信度却逐级塌方。动作二,查身份:ASV-0017 的最优命中若指向模式菌株序列,种级注释可以采信;若命中一条环境克隆序列,注释要自动降级为"与某种相似的环境谱系"。动作三,验证:占比前三的 ASV 值得各建一次定位树,看拓扑与百分比是否同向——尤其是 ASV-0042,属级注释要求"属内稳定聚簇",树上落错了位置就该改写结论。
解剖完的结论可以写成三句话:这份样品约一成二的序列定到了种,近一成定到属,其余结论都在科或门级徘徊;任何"样品里有多少致病菌"之类的下游计算,都只配使用种级那部分数据;未知门分支不是垃圾数据,是本样品最可能上新闻的部分。读宏基因组报告的职业素养,就是把这三句话从手动做成习惯。
把本节放回第 4 章的弧线上收个尾:4.1 的多相分类要求"先培养后定名",本节的世界里大多数类群永远走不到培养那一步——范式从这里开始真正断裂。断裂不是崩塌:命名制度在打补丁(Candidatus),方法在打补丁(防投影三动作),理论在打补丁(连续谱语言)。看懂这套"边运行边修补"的状态,你就把握住了当代分类学最真实的脉搏——它不完美,但它诚实,并且活着。
本节要点回顾
- 两代清点单元:OTU 靠阈值聚类、跨研究不可比;ASV 是去误差的真实变体、跨研究可比,但引物偏差仍在;
- MAG 的质量分级必须查:完成度与污染度两个数字,低质量 MAG 的"未检出"不是"不存在";
- 两条路线各答一问:扩增子答"谁在场",鸟枪答"谁的基因组长什么样";
- 命名账户分层:命中参考库的沿用旧名,对不上的挂 Candidatus,新门级发现多走后者;
- 数据库投影是头号风险:注释自带置信梯度,模式菌株命中、属级聚簇、高层级落位三档可靠性完全不同;
- 读报告三动作:看置信分档、查参考身份、建树验证。