4.3 基因组种标准:ANI 与 dDDH
4.3 基因组种标准:ANI 与 dDDH
本节摘要:基因组时代的定种标准是两个可计算的数字:平均核苷酸一致性(ANI)与数字 DNA-DNA 杂交值(dDDH)。前者把两个基因组共有的同源片段逐一比对取平均,后者用比对相似度回算传统杂交值。本节讲清两个指标的算法思想、阈值来历与判读纪律,并用一桩"16S 定不了、ANI 一下定"的案例收尾。
本节在知识地图上接住 4.2 留下的接力棒:16S 分不开的近缘种,全基因组一比就现形。位置上它也是 1.3 节"基因组种"概念的机器化——那句"阈值是约定不是定律",这里给出约定的来历。
从水浴杂交到数字比对
理解 ANI 之前要先知道它替代了什么。二十世纪后期的基因组种标准是 DNA-DNA 杂交(DDH):把两株菌的 DNA 分别打断、变性、复性,测杂交双链的形成率与热稳定性——杂交率越高、解链温度越高,两基因组越相似。这条物理化学路线硬撑了三十年,痛点一堆:需要培养大量细胞、实验室之间结果难复现、无法利用公开序列数据。
测序普及后,研究者把杂交逻辑搬到计算机里:比对两个基因组,算出数字化的杂交当量——这就是 dDDH。随后又出现更直观的 ANI:找出两基因组间所有同源片段,逐段算核苷酸一致率,取平均值。
两个指标的算法思想
**ANI(平均核苷酸一致性)**的通俗版本:把两个基因组的序列互为题库互相检索,只保留足够长、足够相似的同源片段(典型门槛:片段约 3000 碱基、一致率不低于七成),对入选片段的碱基一致率求平均。两个输出数字都要看:平均值(相似程度)与比对覆盖率(同源范围)。只报平均值不报覆盖率是常见错误——覆盖率过低说明两基因组共享内容太少,平均值再高也说明不了"同种"。
**dDDH(数字 DNA-DNA 杂交值)**用经验公式把比对相似度换算成"等效于传统杂交值"的分数,为的是与几十年的 DDH 文献口径衔接:传统金标准线 70% 杂交值(对应约 99% 保真判定)平移过来,即 dDDH 70% 为种界推荐线。
| 指标 | 阈值口径 | 优点 | 注意事项 |
|---|---|---|---|
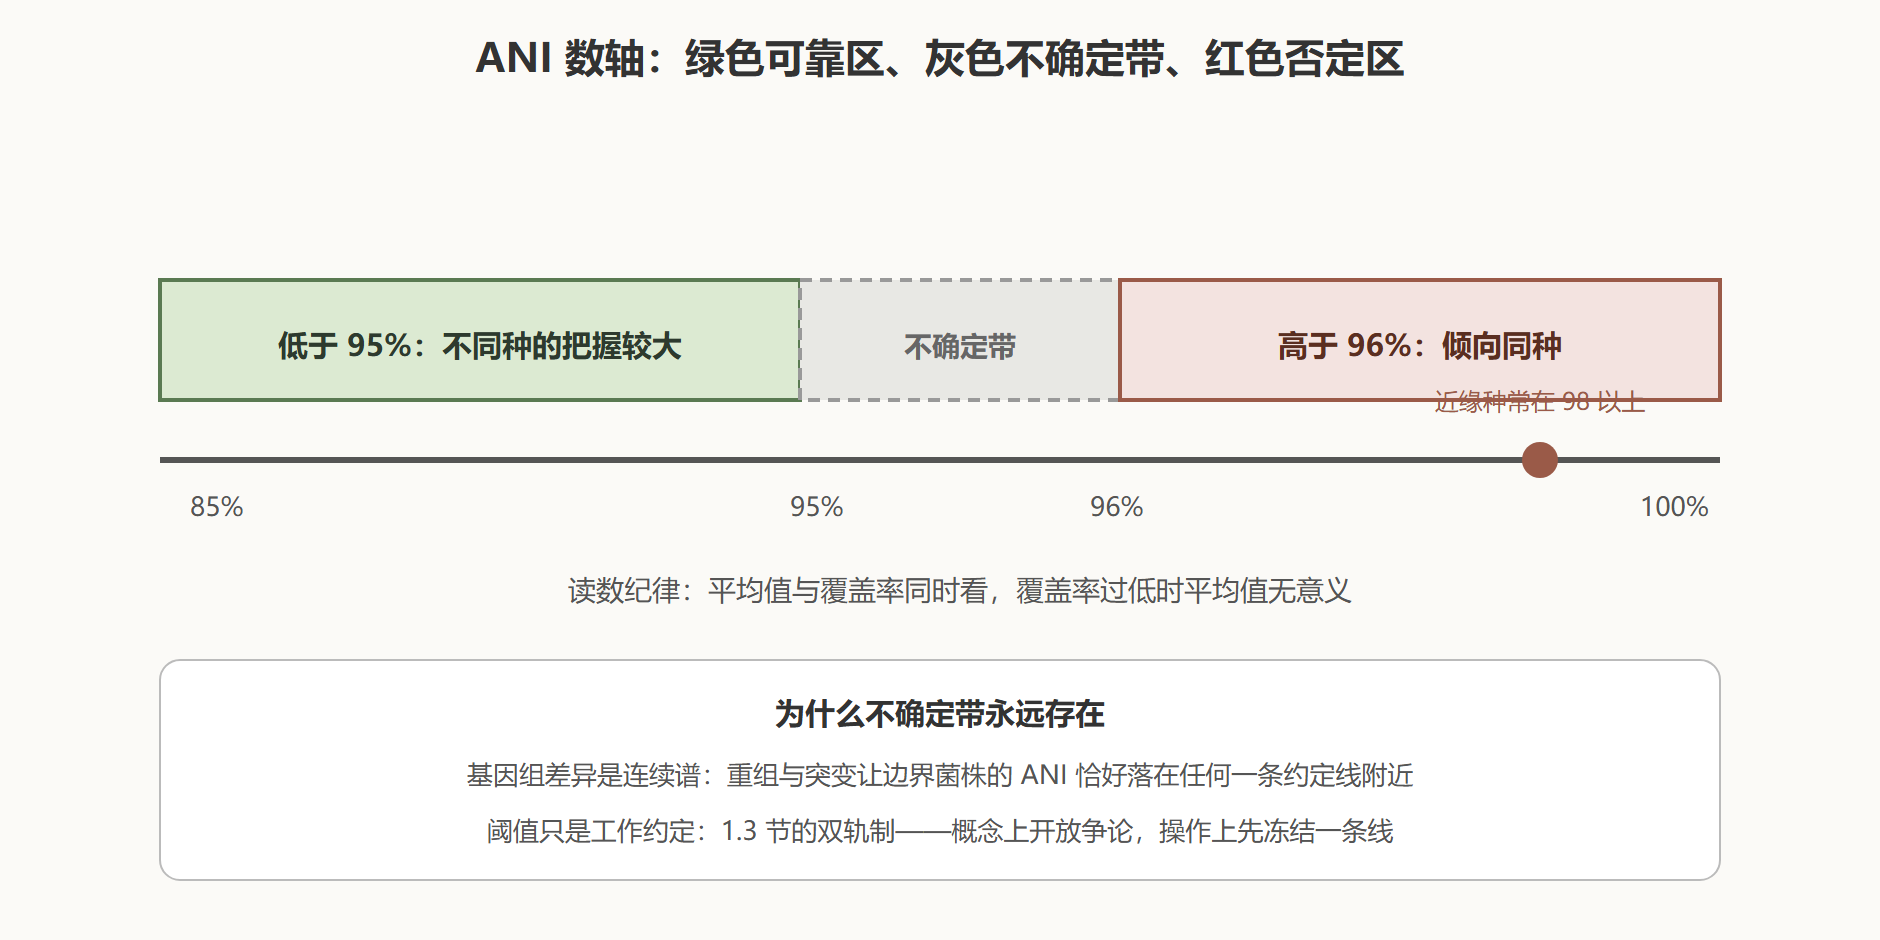
| ANI | 约 95% 至 96% 为种界 | 直观、计算快、双向可比 | 必须同时报覆盖率;近缘高于 99% 时仍需 dDDH 复核 |
| dDDH | 70% 为种界推荐线 | 与历史文献口径连续、置信区间完整 | 需专用服务计算,非本地速算 |
| 16S | 98.65% 种界参考线 | 快速初筛 | 近缘种盲区,只作初筛(4.2) |
三个阈值的关系是漏斗:16S 初筛,ANI 常规定种,dDDH 边缘复核。层层递进的每一步都在缩小"不确定地带"。
图 1 ANI 阈值与不确定地带
案例复盘:一株"16S 拒绝表态"的菌株
背景:3.4 案例外的另一株环境分离株 S-2417,16S 比对最优与次优命中只差 0.3 个百分点(4.2 的判读记录),表型试验条给出混合画像——按多相流程卡在种级定名。
操作:对 S-2417 与两个候选种的模式菌株分别做全基因组测序(覆盖深度不低于五十倍,组装后查污染与完整性),随后两两计算 ANI 与 dDDH。
结果:与候选甲模式菌株 ANI 98.9%、覆盖率 81%、dDDH 78%;与候选乙 ANI 94.1%、覆盖率 74%、dDDH 52%。数字清晰指向候选甲:两对比较里,甲组的两项指标都双双越过种界线,乙组双双未达。
解读:注意覆盖率这一行的分量——与乙的覆盖率只有 74%,意味着两基因组约四分之一内容不同源,即使平均值再高也不能下"同种"结论;幸而其均值本身就低,结论无歧义。真正需要警惕的是另一种情形:均值 96.5% 而覆盖率只有 70% 上下,此时高均值只属于共享的那一小部分,结论必须悬置。双数字判读的价值正在于此。
变式:若两对指标的结论互相矛盾(一对说同种、另一对说不同种),按多相纪律处理:检查组装质量与污染,复算;仍矛盾则如实报告并保留"待定种"身份,同时补全表型证据供后续研究裁决。
动手判读:一张双数字结果表
案例之外,给一张可以自己练的结果表。三个待测株与参考种甲模式菌株的比较数据摆在这里,判读三遍再往下看答案。
ANI 判读练习(参考:种甲模式菌株) 待测株 ANI 均值 覆盖率 dDDH 初步判读 A-01 97.2% 88% 74% ______ A-02 96.4% 91% 68% ______ A-03 95.1% 62% 55% ______
参考判读:A-01 双数字过线,倾向同种,可直接归档;A-02 均值在不确定带内、dDDH 低于 70%,两证据分歧,按纪律补证据——建树看拓扑、加测看家基因,仍悬则报告"疑似同种,待定";A-03 是本节最想让你识别的陷阱——均值 95.1% 看似贴线,覆盖率仅 62%,意味着近四成基因组互不同源,高均值只属于共享的少数区域,结论应为"明显非同种",且这株可能压根是远缘 contamination 或新谱系,值得单独追查。
进阶加练一题:若新增待测株 A-04,ANI 98.3%、覆盖率 83%、dDDH 81%,但已知参考种甲有两个亚群(模式株所在的亚群甲一与 ANI 相互约 96.5% 的亚群甲二),你的判断应当再加一层——A-03 式的"对种甲整体"判断之外,还要分别对两个亚群算值:若 A-04 与甲一 98.3% 而与甲二只有 96.1%,结论是"甲一成员";若两边都 98% 上下,则种甲内部的亚群结构本身值得重新审视。亚群结构使双数字判读从"两两比对"升级为"网络比对"——这正是当代基因组种研究把边界越画越细的引擎。
做完练习你会发现判读的动作结构:先看覆盖率定"可比性",再看均值定"方向",分歧时按证据升级路径走。三步的顺序不能乱——拿均值裸判的人,就是 A-03 陷阱的收货人。
还有半句给动手族的提示:ANI 的计算不需要超算,一台普通工作站跑现成工具几分钟到几十分钟就能出结果,真正的门槛不在算力而在判断——用什么组装结果喂进去、覆盖率阈值取多少、结果怎么写进报告,这些环节每一步都嵌着本节的纪律。工具会把计算变便宜,但不会把判断变多余;这句话是本章对所有"自动化"许诺的总回答。
本节要点回顾
与 5.1 的接口:为什么连续谱是演化学的必然
本节的"不确定带"在第 5 章会拿到根源解释,这里先把接口搭好。
基因组差异是连续谱,因为生成差异的机制是连续运行的:突变每代都在发生,重组时不时地稀释差异,水平基因转移干脆成段成段地搬运内容。三套机制没有一道在"种界线"处停下——线是人类画的,机制不知道它的存在。所以边界菌株年年有,不确定带永远存在,这不是技术缺陷,是研究对象的本性。
由此还能推出一个实用预言:快速辐射的类群(病原菌新分支、高转移环境如口腔菌群),不确定带会比慢节奏类群宽得多。实际工作里遇到"这个属怎么这么多骑墙株",先别怀疑自己的算法——先看看这个属的演化节奏。带着这个预期去读 5.1 的种内多样性,你会发现 ANI 数轴上的灰色地带,就是演化机制亲手画出来的。
本节要点回顾
- ANI 的算法思想:全基因组互检索同源片段、逐段算一致率取平均,平均值与覆盖率双数字判读;
- dDDH 的存在理由是把历史 DDH 文献口径接续下来,种界推荐线 70%;
- 三个阈值构成漏斗:16S 初筛、ANI 定种、dDDH 复核边缘案例;
- 不确定带是演化学事实:基因组差异是连续谱,任何约定线都会切到边界菌株;
- 矛盾结果的处理纪律与多相分类一脉相承:查污染、复算、如实报告、悬置定名。