6.1 经典鉴定技术体系
6.1 经典鉴定技术体系
经典鉴定依托形态学特征、检索表与腊叶标本完成物种识别。即使测序成本一降再降,这套体系依然是植物分类的法定根基——新种描述必须指定模式标本,命名争议最终要回到标本柜前裁决。
学习目标
阅读完本节,你应当能够:
- 说明模式标本在命名法中的"锚"作用;
- 区分定距检索表与平行检索表并会使用;
- 掌握鉴定的标准工作流与常见易错点;
- 理解腊叶标本在基因组时代的新价值。
一、为什么标本柜仍是终审法院
《国际藻类、菌物和植物命名法规》规定:每个物种名称必须永久绑定一份模式标本(nomenclatural type)。名称怎么改、属怎么拆并,最终的裁判依据是那张压干的植株——它像法律条文里的"原件证据"。伦敦邱园、纽约植物园、巴黎自然历史博物馆合计收藏数千万份植物标本,全球标本数字化计划已将上亿份标本的图像与采集数据上线。当形态鉴定与分子结果冲突时,回答"这个名字到底指哪个物种"的,仍是模式标本。
标本柜还在产生新科学:从采集于 1800 年代早期的标本上提取 DNA,已经重建了灭绝物种(如圣赫勒拿橄榄)的系统位置;标本上的花粉与虫瘿记录了两百年间传粉网络的变化。腊叶标本从"静态档案"变成了"时间序列数据库"。
二、检索表:把鉴定变成二选一的决策树
检索表把鉴别特征组织成一串二选一的分支。两种主流格式:
- 定距检索表:成对特征错开缩进排列,适合印刷阅读;
- 平行检索表:每条分支编号并注明"去往哪一条",适合计算机化与野外快速查询。
一段鉴定华北落叶树科的平行检索表示例:
1a. 单叶互生,有托叶,痕痕盾状 ……………………………… 2 1b. 单叶对生或轮生,无托叶 …………………………………… 4 2a. 叶缘有锯齿,坚果外包总苞(壳斗) ……… 壳斗科(栎属) 2b. 叶缘全缘或浅裂,翅果 …………………………………… 3 3a. 翅果两侧对称,双翅展开成一字 ………… 槭树科(槭属) 3b. 翅果一侧有翅,单翅下垂 ………………………… 榆科(榆属) 4a. 对生,叶掌状复叶 ………………………………… 七叶树科 4b. 对生,单叶全缘 ………………………………………… 木犀科
使用检索表的第一纪律:不要只走一条路。走到与标本不符的死胡同时,回头检查上一个分支是否被误判——营养枝特征、荫蔽叶、幼树性状常与典型描述偏离。
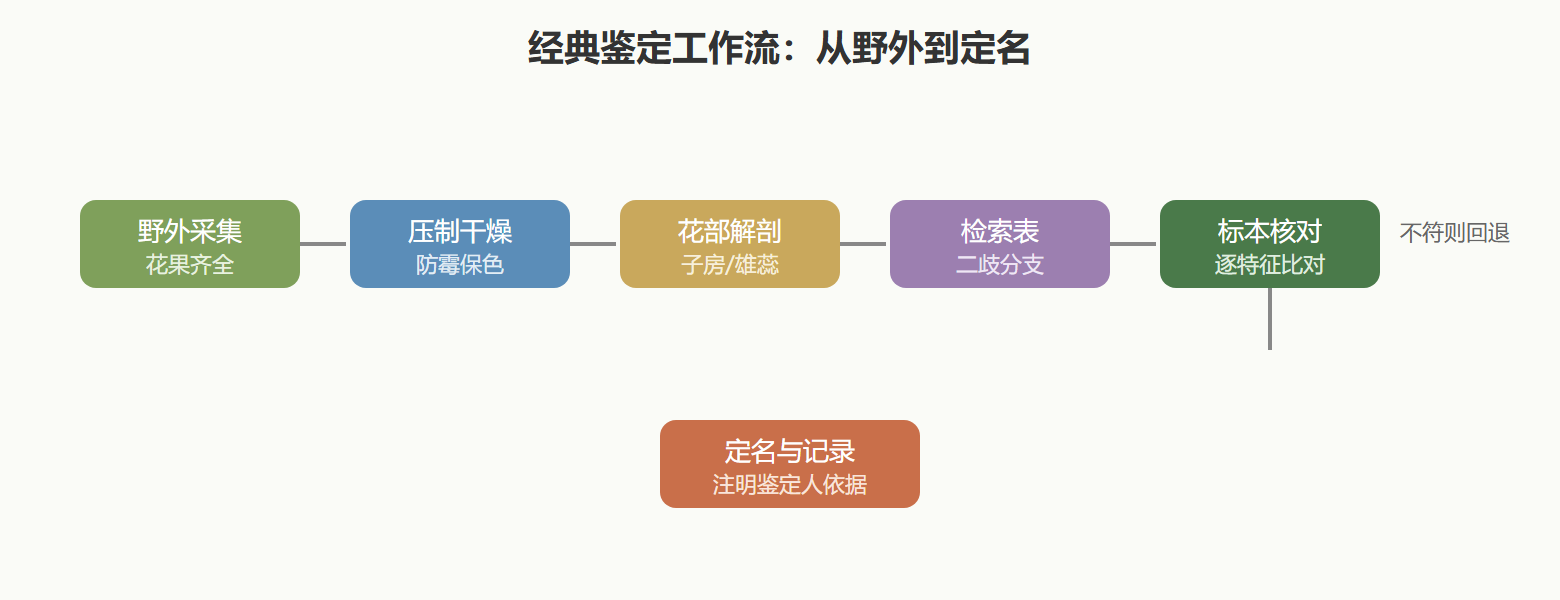
三、鉴定工作流:从野外到定名
| 步骤 | 关键动作 | 常见易错点 |
|---|---|---|
| 野外采集 | 取带花或果的完整枝条,记录生境与伴生种 | 只采营养枝,关键特征缺失 |
| 压制干燥 | 吸水纸压制、每日换纸或烘干 | 干燥缓慢导致叶片发霉变黑 |
| 观察 | 花部解剖:花瓣数、雄蕊着生、子房位置 | 忽略子房上/下位这类稳定特征 |
| 检索 | 交替使用地方植物志与检索表 | 只依赖单一特征"秒判" |
| 核对 | 与标本馆同名标本逐特征比对 | 只看照片不核对实物 |
| 定名记录 | 注明鉴定人与依据文献 | 名字层层转抄,无人负责 |
💡 关键直觉:鉴定依据应优先选生殖器官特征(花部结构、胚珠数、果实类型),因为它们演化上更保守;叶形、毛被这类营养特征可塑性强,是误判的重灾区。
图 经典鉴定工作流
四、形态鉴定的边界
再严谨的形态鉴定也有天花板。隐存种(cryptic species)形态几乎无法区分:中国的青冈属多个类群、龙胆科的若干复合群,形态学处理为一种,分子数据拆成数种。杂交与多倍化让连续变异压过间断特征:柳属与蔷薇属的杂交带是检索表的噩梦。反过来,表型可塑性让同种不同生境的个体像两个种。知道形态鉴定在哪里失效,才知道何时把样本送去做下一节的分子鉴定——这不是替代关系,而是分工。
五、把检索表写成可执行的程序
检索表既然是决策树,就可以直接翻译成代码,让野外记录在几秒内跑出科属判断:
def identify(specimen: dict): # specimen 键: leaf_arrangement(互生/对生), stipule(有/无), # fruit_type(坚果/翅果/其他), wing(双翅/单翅) if specimen["leaf_arrangement"] == "互生": if specimen.get("stipule") == "有": return "壳斗科(栎属)方向" return "槭树科" if specimen["wing"] == "双翅" else "榆科(榆属)" return "七叶树科" if specimen["leaf_arrangement"] == "对生复叶" else "木犀科方向" print(identify({"leaf_arrangement": "互生", "stipule": "有", "fruit_type": "坚果", "wing": "-"}))
同一段逻辑,纸上叫平行检索表,机器里叫条件分支——区别只在于后者可以同时挂上地理范围与花期约束,自动排除掉此刻不可能出现的选项。数字植物志 App 的离线鉴定功能,内核正是这样的检索树加上标本图像比对。
标本数据的质量控制同样可以半自动化:
录入字段 自动校验规则 违例处理 采集日期 1900-01-01 至今日历范围内 标记待核 坐标 落在行政区内且非(0,0) 回退到县级质心 海拔 与坐标地形的±300m带内 标记异常 鉴定名 命名法规格式正则+异名库比对 自动附加当前接受名
值得强调的是,经典鉴定并非分子时代的"过渡技术",而是分子结果的地面对照。每一条参考条形码序列都必须挂在凭证标本上,而凭证标本的定名又靠形态学完成;数据库里鉴定人的签名与鉴定年份,正是这条证据链的责任链。一个实用的训练建议:每年重新鉴定自己前一年压制的十份标本——你会发现过去的判断里总有需要修正的地方,这种自我纠错的习惯,比背熟多少检索表都更接近分类学的工作伦理。
本节要点回顾
- 模式标本是命名的锚:名称争议最终回到标本柜裁决。
- 标本柜即时间数据库:古 DNA、花粉、虫瘿记录两百年生态变迁。
- 检索表是二歧决策树:定距式宜印刷,平行式宜数字化。
- 优先生殖特征:花部结构保守可靠,叶形毛被可塑易误导。
- 知道边界才有分工:隐存种、杂交、多倍化是分子鉴定的入口场景。