6.2 分子鉴定与大数据整合
6.2 分子鉴定与大数据整合
DNA 条形码用短而保守的标准基因片段识别物种,植物界公认的组合是 rbcL 加 matK 两个质体片段,辅以核核糖体 ITS2;**环境 DNA(eDNA)**则把鉴定推进到"不见到植株也能开出物种名单"。当条形码遇见亿万级标本与观测大数据,植物种类研究进入了可批量复核、可全球对账的阶段。
学习目标
阅读完本节,你应当能够:
- 说明为什么植物条形码需要"组合拳"而非单一片段;
- 复述条形码鉴定从取样到物种判定的流程;
- 举出 eDNA 在植物监测中的真实应用与局限;
- 解释大数据平台如何改变区系研究与保护决策。
一、为什么不用一个片段包打天下
动物条形码用线粒体细胞色素氧化酶一段(COI)几乎畅通无阻,植物却不行:植物线粒体进化太慢、种间区分度不足;叶绿体基因组又常随杂交与质体渗入在物种间"串门"。对策是组合片段,形成互补三角:
| 片段 | 来源 | 特点 | 角色 |
|---|---|---|---|
| rbcL | 叶绿体 | 通用性极强、分辨率低 | 通用锚,先归到科属 |
| matK | 叶绿体 | 分辨率较高、扩增偏难 | 主力种级区分 |
| ITS2 | 核糖体 | 种级分辨高、多拷贝 | 补位:近缘种与杂交识别 |
| trnH-psbA | 叶绿体间隔区 | 变异快 | 特定类群补充 |
实践中先用 rbcL 把未知样本锚到科属,再用 matK 与 ITS2 下探到种。校园里一片不知名的落叶、海关截获的种子粉末、混入药材的伪品,走的都是这条流水线。
二、从叶片到名字:鉴定流水线
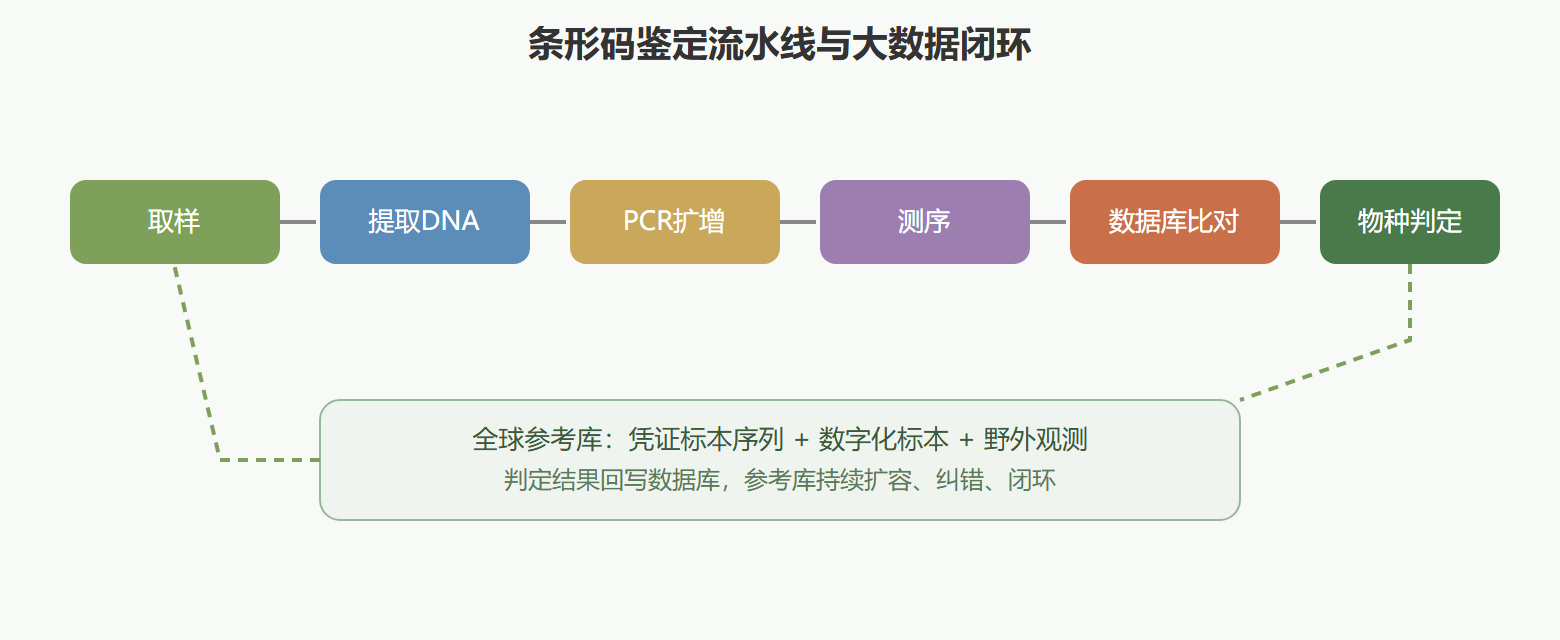
流程概括为五步:取样(硅胶干燥保存叶片)→ 提取 DNA → 通用引物扩增目标片段 → 测序 → 与参考数据库比对(BOLD 与本地参考库),以相似度阈值结合系统树位置判定物种。真正的瓶颈往往不在实验室,而在参考库质量:数据库里错误鉴定的参照序列会把未知样本带偏,"垃圾进、垃圾出"在条形码领域体现得淋漓尽致。建立本地类群的凭证标本参考库,是每个区域性项目绕不开的苦工。
图 DNA 条形码鉴定流水线与数据闭环
三、eDNA:不见其树,先见其"字"
环境 DNA 指从土壤、水体、花粉团、动物粪便中提取的混合 DNA。森林地表土壤里的植物 DNA 主要来自根系与落叶腐解,宏条形码测序后可以直接给出样点的植物种类名录,与传统样方调查的一致性可达七八成,且常"捞出"调查者漏掉的早春短命植物与难以开花的蕨类。蜂巢花粉团的 eDNA 则被用于绘制传粉网络——哪种蜂采访了哪些花,一次测序给出整张互作矩阵。
局限同样明确:DNA 残留反映的是"曾在此",无法区分活体与残留、母株与被风雨搬来的碎片;定量能力弱(序列数不等于丰度);检测概率受降解条件影响。eDNA 名录最好与样方调查互为校验,而不是取代。
四、大数据整合:区系学的新底座
单一调查回答"这里有什么",大数据平台回答"整个分布区发生了什么"。全球生物多样性信息机构汇聚了数亿条植物 occurrence 记录,其中相当部分来自标本数字化与公众科学观察;结合遥感物候与气候图层,研究者完成了过去需要数十年野外工作才能实现的跨洲比较:某属的多样性中心在哪里、物种分布区是否在收缩、保护地覆盖是否存在空隙。评估流程中的实际分布区面积与占据面积两个指标(详见第 5 章),如今正是靠这些海量记录网格化计算得出。
⚠️ 常见坑:把 occurrence 记录直接当分布事实。公众科学数据存在采样偏差(道路与城市附近记录密度高得多)、鉴定错误与坐标精度不一。规范做法是先做数据清洗:剔除坐标落于自然保护区质心或首都坐标的记录、按时间与精度分层过滤,再进入分析——否则"数据越多、结论越歪"。
用最小距离法做一个袖珍条形码比对
比对判定的核心逻辑——找参考库中遗传距离最近且低于阈值的序列——可以用十几行代码完整演示:
ref = { # 参考库: 凭证标本序列(简化为8位点) "毛竹": "AAGCTAGC", "桂竹": "AAGCTACC", "茶秆竹": "AAGTTAGT", } query = "AAGCTAGT" # 待鉴定样品测序结果 best = min(ref, key=lambda s: sum(a != b for a, b in zip(ref[s], query))) d = sum(a != b for a, b in zip(ref[best], query)) / len(query) print(f"最近参照: {best}, p距离={d:.3f}") print("判定: 种内变异范围内" if d < 0.02 else "判定: 最近属而未能定种, 建议补ITS2")
阈值一改,结论就从"定到种"退回"定到属"——真实流程里 rbcL 与 ITS2 各有阈值,两者裁决不一致时必须回到形态核对,这段小代码就是整套流水线争议处理机制的缩影。
eDNA 名录与样方调查的一致性检验也有标准记法:
样点号 样方记录种数 eDNA检出种数 交集 仅有eDNA 仅有样方 Q01 23 19 16 3(蕨类2) 7(早春短命植物) Q02 18 21 15 6(草本4) 3 判定: 一致率~75%, eDNA补足不开花类群, 样方补足低拷贝降解种
两条技术路线正在合流:标本数字化把两百年积累的形态档案变成可检索的图像库,而标本测序计划又给这些档案补上分子条码——同一份腊叶标本,既是形态鉴定的原件,又成了参考库的序列来源。未来的鉴定场景很可能是三重交叉:野外拍照比对图像库、叶片取样跑条形码、存疑时回标本馆核对模式。任何一环单独使用都有失败案例,三者互证才构成可靠的证据闭环。
对初学者而言,进入这条证据链的门槛其实不高:一台便携测序仪已经能把从取样到比对压缩到一个下午,而开放数据库的查询接口对任何人免费。真正的门槛转移到了判断力——能否识别参考库的空缺、能否察觉一条序列背后的错误定名、能否在三个证据源打架时知道先信谁。工具越普及,使用者的分类学素养反而越成为稀缺资源。## 本节要点回顾
- 组合条形码:rbcL 锚科属、matK 下探种级、ITS2 补近缘与杂交,三角互补。
- 参考库是命门:凭证标本序列的质量决定比对可信度。
- eDNA 价值与边界:能捞出隐匿类群,但定性不定量、见"字"不见树。
- 大数据对账:亿级记录让分布评估、保护空隙分析从十年尺度压缩到月尺度。
- 先洗再用:采样偏差清洗是大数据分析不可跳过的前置步骤。