4.1 相空间重构:从一列数据重建吸引子
4.1 相空间重构:从一列数据重建吸引子
本节摘要:系统有十个变量,传感器只给你其中一列——吸引子还能画出来吗?塔肯斯的延迟嵌入定理给出了肯定的回答:把一列标量数据的"过去"当作额外的坐标,就能重建与原系统拓扑等价的相空间。本节复盘延迟嵌入的完整实操:为什么可行、延迟时间怎么定(自相关与互信息两套判据)、嵌入维数怎么定(虚假最近邻法),并用洛伦兹的 x 分量单独重建出双翼吸引子做验收。
上一章的洛伦兹实验里,我们把三个变量全都握在手里,双翼随便画。现在收紧条件:假设我们只在 x 上装了一个探头,y、z 完全测不到——这恰是真实测量的常态(心电图只测电位、地震台只测位移)。本节的任务是证明并演示:一列数据里藏着整个系统的影子。
学习目标
阅读完本节,你应当能够:
- 写出延迟嵌入的构造式,说明"用过去当坐标"为什么不是文字游戏;
- 用自相关首次过零与互信息首次极小两种方法确定延迟时间,说出各自的适用差别;
- 用虚假最近邻法确定最小嵌入维数,解释"虚假"从何而来;
- 对洛伦兹 x 分量执行完整重构,并把重建吸引子与原图对照验收;
- 列出重构失败的常见原因:采样过疏、噪声过强、数据过短。
一、原理复盘:过去为什么能当坐标
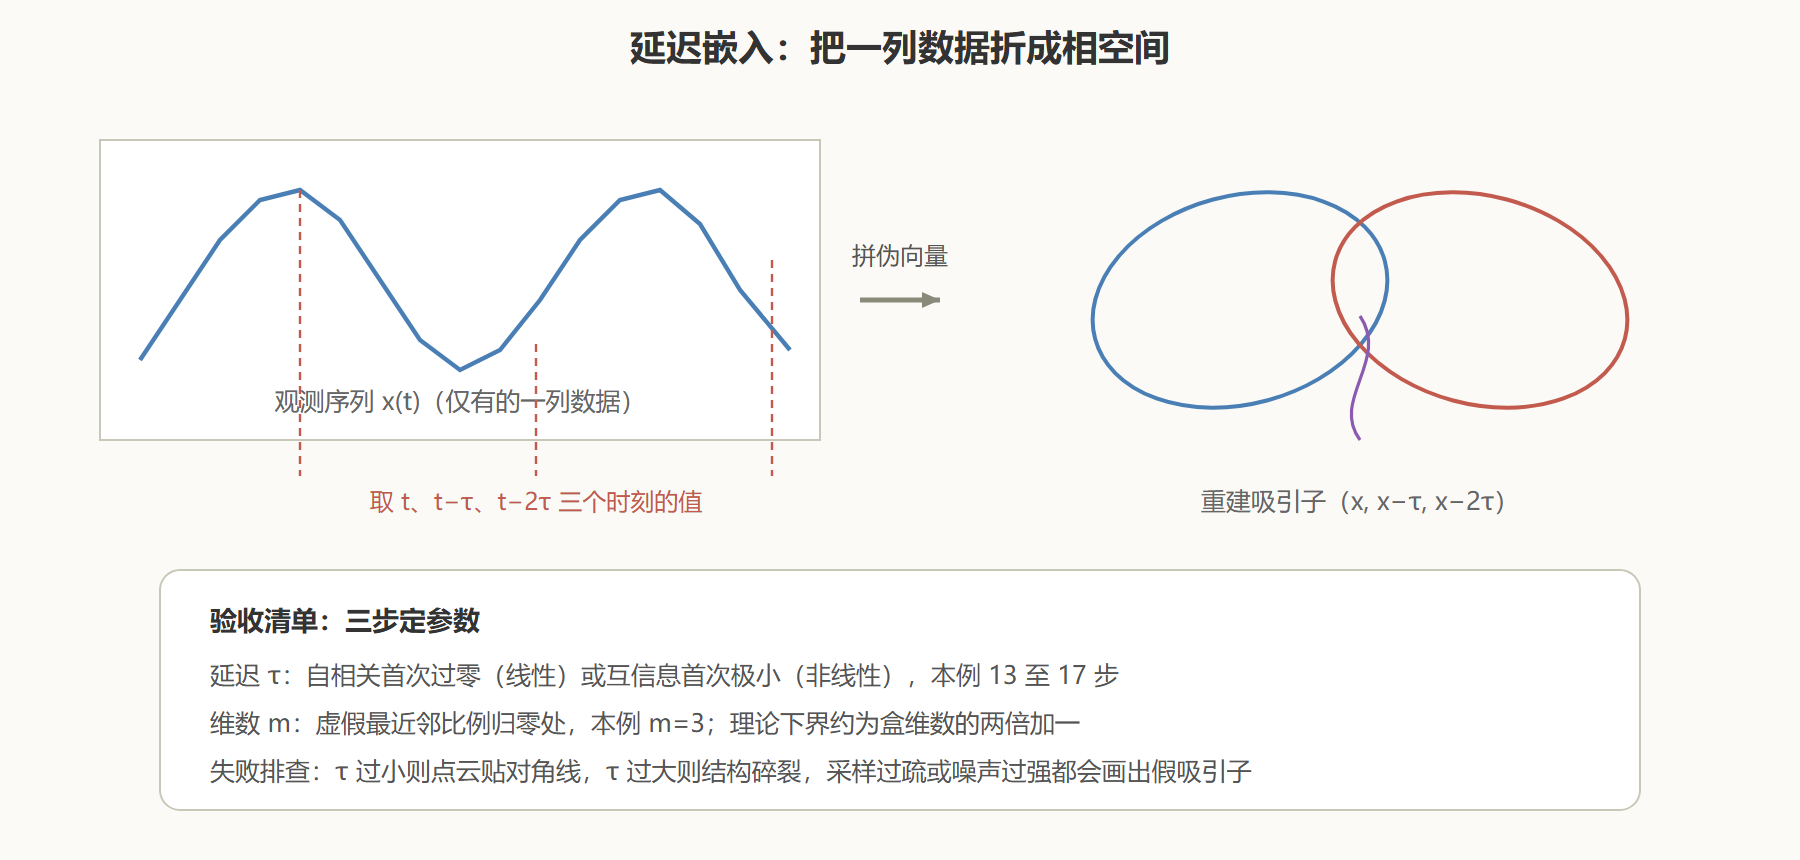
先想清楚问题的形状。系统的真实状态是高维的(洛伦兹三维,真实系统可能几十维),但轨道在相空间里被吸引子约束,不会随便走。一条轨道路过某处时,它的"现在"与"最近的过去"之间存在确定关系——否则轨迹就无从连续。于是有个朴素想法:既然看不到完整状态,就拿同一列观测的不同时刻拼一个伪向量——现在值、一个延迟前的值、两个延迟前的值……拼成的新向量在数学上相当于从高维轨道向低维投影的延时切片。塔肯斯在八十年代初证明的定理说:只要观测函数足够-generic(不与系统对称性特殊对齐)、嵌入维数足够大(经验下界约为吸引子盒维数的两倍加一),这个伪向量空间里的轨道与真实吸引子微分同胚——拉伸弯曲可以不同,但邻近关系、环绕结构、洞的个数全部保持。通俗讲:影子不是本体,但影子的拓扑就是本体的拓扑。
定理里那个"足够大"的下界值得记一下:三维吸引子按盒维数二点零六算,下界约为二点零六乘二加一,即五点一二,故取五维以上嵌入稳妥。实践中人们常用三维到五维画图,用作展示;用作维数估计时则必须按定理下界给足。
二、定延迟:两个判据的分工
延迟时间 τ 是第一个要定的参数。τ 太小,相邻坐标几乎相等(一秒拍六十张几乎相同的照片),伪向量挤在相空间对角线上,什么结构都看不清;τ 太大,相邻坐标已近乎不相关(照片之间隔了一整个剧情),重建的吸引子被"撕碎"。规范定法有两条思路。
思路一:线性判据——自相关首次过零。 计算观测序列的自相关函数,取它首次降到零的延迟。直觉是:过零意味着线性相关被耗尽,作为坐标的"过去值"携带了新信息。优点是便宜,几十行代码;缺点是只看线性关系,对非线性系统常常偏保守。
思路二:非线性判据——互信息首次极小。 互信息度量两个时刻取值的统计依赖(包含非线性部分),取其第一次跌到局部极小的延迟。直觉是:此刻"过去"对"现在"的预测力恰好降到谷底,作为新坐标信息增量最大。代价是计算量大一些(要对延迟扫描直方图估计),但对强非线性系统更可靠。
# 重构参数实验(伪代码):数据为洛伦兹 x 分量,采样步长 h=0.01 1. 自相关法: 扫描 lag = 1..200, 计算 r(lag) r(lag) 首次 < 0 的位置: lag 约 13 -> tau_acf = 13 步 (0.13 个时间单位) 2. 互信息法: 扫描 lag = 1..200, 以 64 箱直方图估计 I(lag) I(lag) 首个局部极小: lag 约 17 -> tau_mi = 17 步 3. 虚假最近邻法定 m: 对 m = 2..8, 在嵌入空间找最近邻, 阈值判虚假 虚假比例: m=2 为 31%, m=3 为 4.8%, m=4 为 1.1%, m>=5 约 0% -> 最小嵌入维数 m = 3 (与洛伦兹真实维数一致)
第三段输出是本实验的验收章:只用一列 x,方法本身"猜"出了系统是三维的。这不是巧合而是定理的兑现——虚假最近邻法度量的正是"维数不足时投影把不相邻的点挤到一起"的比例,比例归零即维数足够。
三、实操复盘:一列 x 重现双翼
参数齐备,执行重构:伪向量取三维,坐标为 x(t)、x(t−τ)、x(t−2τ),τ 取互信息定出的十七步。把约一万个伪向量画进三维图(纸上取其两两投影),复盘得到的图像与第三章用真实三变量画的吸引子对照:双翼结构赫然在目,环的圈层、脊椎的位置、翼的朝向一一对得上——形状细节与原图有形变(这是投影许可的),但拓扑完全一致,正是微分同胚承诺的样子。
图 4-1 延迟嵌入的构造与验收:一列数据如何长出吸引子
四、陷阱清单与变式实验
重构是把好刀,但刀刃朝内的三处经典陷阱必须写进肌肉记忆。陷阱一:采样过疏。 数据按远大于系统特征时间的间隔采集,相邻样本已无关联,任何 τ 都救不回来——判据是自相关在第一步就几乎为零。陷阱二:噪声过强。 测量噪声在小尺度上淹没邻近结构,互信息极小被填平、虚假最近邻比例永不归零;对策是先平滑或改用对噪声更稳的统计量。陷阱三:数据太短。 经验上至少需要跨越吸引子几十圈的样本,几百个点连"像样的"重构都支撑不起,更别提在它上面估维数。
变式实验一:把 τ 强行取二(过小)重画——伪向量云挤成一条斜线,什么结构都没有;再取一百(过大)——双翼碎成不相干的散点。这一大一小两个失败样本建议亲手做一遍,比任何文字都更有效地校准你对 τ 的手感。变式实验二:拿一段真实的日气温序列(或任何你手头的等间隔序列)走完整流程——不管结论是不是混沌,把三个参数定出来、把失败模式排查一遍,流水线就算真正上手了。
问:随机数据经过延迟嵌入会画出什么?
画出实心的一团。随机序列各点互不关联,嵌入点云会均匀填满嵌入空间的一块区域,没有层面、没有骨架、没有褶皱;而确定性吸引子的点云有清晰的分层结构。这一特征是肉眼初筛的依据——但“看起来有结构”不能代替替代数据检验,两者要一起用。
问:噪声大时还能重构吗?
轻度噪声会让吸引子“发胖”——细管变成雾管,骨架仍在;重度噪声会让分层粘连成实心团,重构宣告失败。经验分界大致在信噪比二十分贝上下,且与数据长度相关:噪声越大,越要靠更长的数据把结构从噪声里平均出来。6.3 节心脑现场的谨慎结论,一半的根源就在这里。
最后一个变式留给好奇心强的人:把延迟时间取到自相关函数过零点之外很远的位置,观察重建吸引子如何“散架”。散架的样子与延迟过小时的斜对角拉线恰好相反——两种失败形态对照着看,对延迟参数的直觉会立刻成形。
本节要点回顾
- 定理背书:延迟嵌入在维数足够、观测不对齐对称性的条件下与真实吸引子拓扑等价,"影子即拓扑"。
- 延迟两法:自相关首次过零便宜而偏保守,互信息首次极小贵一些但更贴非线性;两者结论通常同量级。
- 维数自证:虚假最近邻比例归零处即最小嵌入维数,洛伦兹 x 分量自证 m 等于三,与真实维数吻合。
- 验收方式:重建吸引子与已知原图做拓扑对照,形变可容、结构必须对上。
- 三处陷阱:采样过疏、噪声过强、数据过短;两个极端 τ 的失败样本是最好的手感训练。
吸引子重建出来了,下一节给它配上一把动力学的尺子:Lyapunov 指数——从一维手算到洛伦兹的正规算法复盘。