4.2 Lyapunov指数:从手算到程序
4.2 Lyapunov指数:从手算到程序
本节摘要:混沌的每张嘴都说"误差指数增长",但科学的问法是:增长率是几?Lyapunov 指数就是答案——误差对数增长率的长期极限,单位是"每单位时间的自然对数"。本节从定义推导开始,手算参数四时 logistic 映射的指数(恰为 ln 2),再用两轨迹重整化法(Benettin 算法)为洛伦兹系统算出最大指数约零点九,最后解读指数谱:正负搭配如何决定吸引、发散与混沌。
第一章给过翻倍时间,第三章给过半对数直线,本节把这条直线的行为正式命名、精确测量、并推广成一套谱。这一节是全书的量化枢纽:后面控制一章要用指数判同步成败,应用一章要用它估预报时效,批判清单要靠它的符号判定真伪混沌。
学习目标
阅读完本节,你应当能够:
- 写出最大 Lyapunov 指数的定义式,说明"对数化"与"长期平均"两个动作各自的用意;
- 对参数四的 logistic 映射手算指数,理解为什么恰好得到 ln 2;
- 实现两轨迹重整化法并汇报洛伦兹系统的最大指数,说明重整化步骤为什么不可省略;
- 解读指数谱的符号组合:全负、含零、含正分别对应什么动力学;
- 区分"系统的指数"与"数据的指数"两种口径,知道后者需要哪些额外假设。
一、定义推导:把"翻倍速度"标准化
把第一章的观察写成公式。设初始偏差为 d0,经过时间 t 后偏差为 d(t),指数增长的假设给出 d(t) 约等于 d0 乘以 e 的 λt 次方。两边取对数再除以 t,得到 λ 约等于 t 分之一乘以 d(t) 与 d0 之比的对数;长期极限(t 趋于无穷、d0 趋于零的先后取极限)就是最大 Lyapunov 指数。两个动作各有深意:取对数把"每过 τ 时间翻一倍"统一成可加的速率语言(翻倍率 m 与指数 λ 满足 λ 等于 ln m 除以 τ);取长期平均则把瞬时涨落抹掉,得到系统的整体属性——混沌轨道上误差时涨时消,只有长期对数平均才是稳定可复现的量。
λ 的符号是判词:λ 大于零意味着偏差被平均放大,敏感依赖成立,系统混沌;λ 小于零意味着偏差被平均吸收,轨道收敛(吸引子维数越低,负得越狠);λ 等于零常见于保守系统的规则方向(沿轨道方向的偏差既不放大也不缩小,只做中性平移)。耗散系统的完整指数谱通常正、零、负并存——正的负责拉伸,零的对应轨道方向,负的负责折叠压缩,恰是第 2.2 节引擎的账本化。
二、手算复盘:logistic 在参数四时为什么恰好是 ln 2
一维映射的指数有一个可直接求和的公式:λ 等于迭代步数趋于无穷时,每步导数绝对值的对数之平均。参数四的 logistic 有个幸运的代换:令 x 等于 sin 的平方(θ 的函数),映射变为 θ 的倍角——每迭代一步,θ 翻倍。误差在 θ 空间里每步翻倍,而 θ 空间与 x 空间在远离端点处仅差一个有界的伸缩因子,于是长期对数增长率恰为 ln 2,约零点六九三,与第 2.2 节面包师变换的账目完全一致。两个毫不相干的系统给出同一个指数,这不是巧合而是同一台引擎(每步翻倍)的两副外壳——普适性的又一次现身,与第 3.2 节的常数异曲同工。
顺手验证公式在别的参数下的表现:r 等于三点八时算得约零点五八(仍混沌但翻倍更慢),r 等于三点二时约为负零点二九(周期二吸收偏差,负值对应周期轨道),r 等于三点五六九九的级联尖端处指数为零——临界点上误差既不放也不收,周期倍增的边界在指数语言里就是零线。把指数随 r 画成曲线,你会得到分岔图的"动力学版":混沌区对应正峰,窗口对应下探的负谷,两者处处咬合。
三、程序复盘:Benettin 两轨迹重整化法
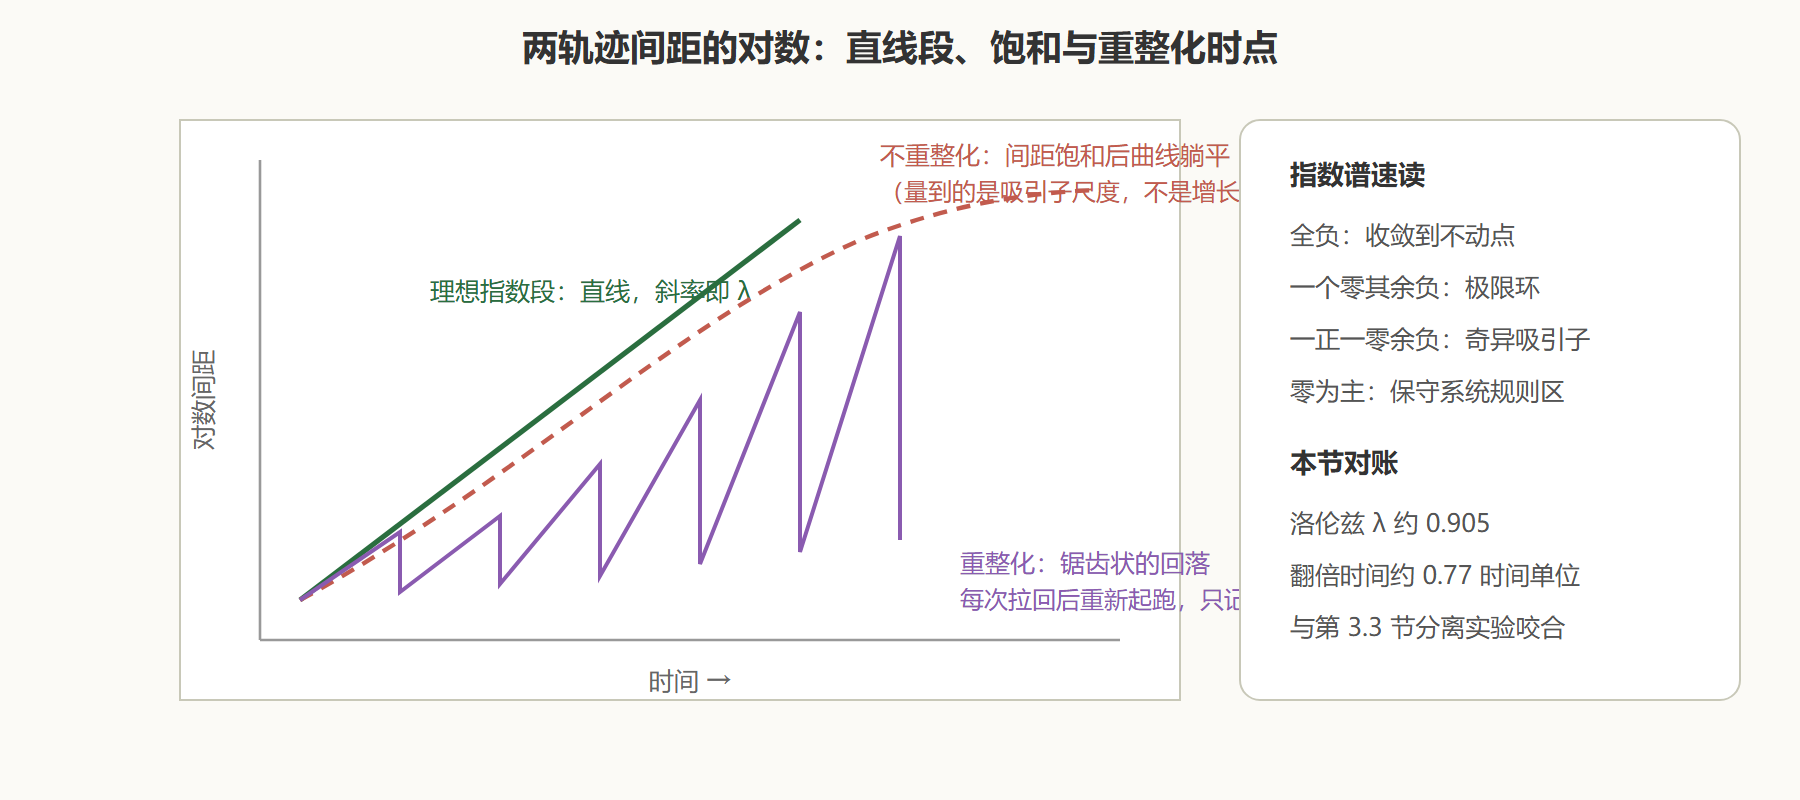
高维系统的指数没法手算,规范算法是 Benettin 的两轨迹法。思路朴素:让两条相距极近的轨迹同时演化,定期测量间距的对数增量;若不干预,间距很快涨到吸引子尺度饱和(对数不再增长,测出的就不是指数而是尺度),所以每次测量后把"测试轨迹"拉回参考轨迹附近,只把对数增量记进总账。拉回的动作就是"重整化",它保证我们量的始终是 infinitesimal 尺度上的增长率:
# Benettin 算法复盘(洛伦兹系统, sigma=10, rho=28, b=8/3) 参数: h=0.005 (四阶龙格-库塔), 重整化间隔 T=1.0, 共 200 段 初始: 参考轨迹 s, 测试轨迹 s + (1e-9, 0, 0) 循环 n = 1..200: 两轨迹同步积分一个间隔 T d = 测试轨迹与参考轨迹的距离 sum = sum + ln( d / d_prev ) # 本段的对数增量入账 测试轨迹 = 参考轨迹 + (测试轨迹 - 参考轨迹) * (1e-9 / d) # 重整化 lambda = sum / (200 * T) 本复盘输出: lambda 约 0.905 (文献参考值约 0.906) 误差翻倍时间 = ln 2 / lambda 约 0.77 个时间单位, 与第 3.3 节的目测一致
三处实现细节决定成败。其一,重整化距离要小而固定(百万分之一量级起步),太大则测到的是非线性饱和段的假斜率。其二,前若干段要丢弃——测试向量尚未对齐最不稳定的方向,早期增量偏低;丢弃二十段起步是稳妥习惯。其三,积分器精度要过关,第三章的步长验收流程在这里直接复用。完成后的核对方式也很直接:把算出的指数换算成翻倍时间,与第三章分离实验目测的翻倍节奏对账——两条独立途径咬合,指数才算立住了。
图 4-2 重整化为何必要:饱和前的斜率才是指数
四、谱的解读与数据口径的提醒
最大指数之外,完整谱(洛伦兹还有一个约负的余项与一个近零方向)用雅可比矩阵的乘积做 QR 分解可得,本节不展开实现,但符号判读必须掌握:一正一零余负是奇异吸引子的指纹;全负是不动点的;一零余负是极限环的。这张对照表配合 4.1 的维数,就是给系统做"动力学体检"的全部家底。
最后是一条实践警句:数据的指数比系统的指数便宜,也更危险。对一列观测用重构加近期邻预测误差估计指数(往往记作数据口径),不需要方程,但结果对参数、噪声、数据长度都敏感,文献中同一数据算出相反符号的案例并不罕见。规范做法是把数据口径的估计当作"候审证据",必须通过替代数据检验(把数据打乱成同一统计面貌的随机版本,指数应当转负;若仍为正,测到的可能是噪声的非线性而非混沌)——这套交叉验证流程在第 7.3 节的批判清单里正式化。
还有一个免费的交叉验证值得养成习惯:洛伦兹谱有两条理论约束——谱中应有一个指数精确为零(沿轨道方向既不放大也不收缩),三个指数之和应等于相体积收缩率(该参数下约负十三点七)。你算出的谱若不满足这两条,先怀疑自己的算法,而不是先宣布发现了新物理。多条理论约束互相咬合,正是数值实验复盘区别于“跑一遍软件看输出”的地方:软件给出数,约束告诉你这些数能不能互相作保。
本节要点回顾
- 定义两动作:对数化把翻倍折算成速率,长期平均抹平瞬时涨落;λ 的符号即混沌与否的判词。
- 手算标杆:参数四的 logistic 指数恰为 ln 2,与面包师变换同账——引擎相同则指数相同。
- Benettin 三细节:重整化距离小而固定、丢弃早期段、积分器验收;洛伦兹复盘值约零点九零五,与第三章目测对账。
- 谱速读:一正一零余负即奇异吸引子;全负、一零余负各有其主。
- 数据口径:不用方程可估指数,但必须过替代数据检验,否则噪声也能冒充混沌。
动力学的尺子有了,下一节换几何的尺子:给吸引子的分形褶皱计数——分形维数的箱计数与关联维数实操。