2.4 分子时代:指纹断亲缘
2.4 分子时代:指纹断亲缘
本节摘要:DNA 测序把分类学从"看长相断亲"推进到"读指纹断亲"。分子证据几度翻案——鲸入偶蹄目、鸟入恐龙、真菌出植物界——形态结论在深层亲缘上系统性失灵。但分子时代并未让形态退场,而是催生了整合系统学:分子、形态、生态、行为装进同一个概率框架,按证据权重协同断案。
上一站留了一个悬而未决的焦虑:形态到底可不可靠?这一站,答案以近乎残酷的方式到来。20 世纪 80 年代起,桑格测序、PCR、自动测序仪轮番登场,DNA 序列第一次成为分类证据。人类突然发现,在形态这层"表型面具"之下,还藏着一片由 ATCG 四个字母写成的"第二自然"——而这片第二自然,是写在生命底层的事实,面具可以骗人,源代码骗不了人。
一、分子证据为什么"硬"
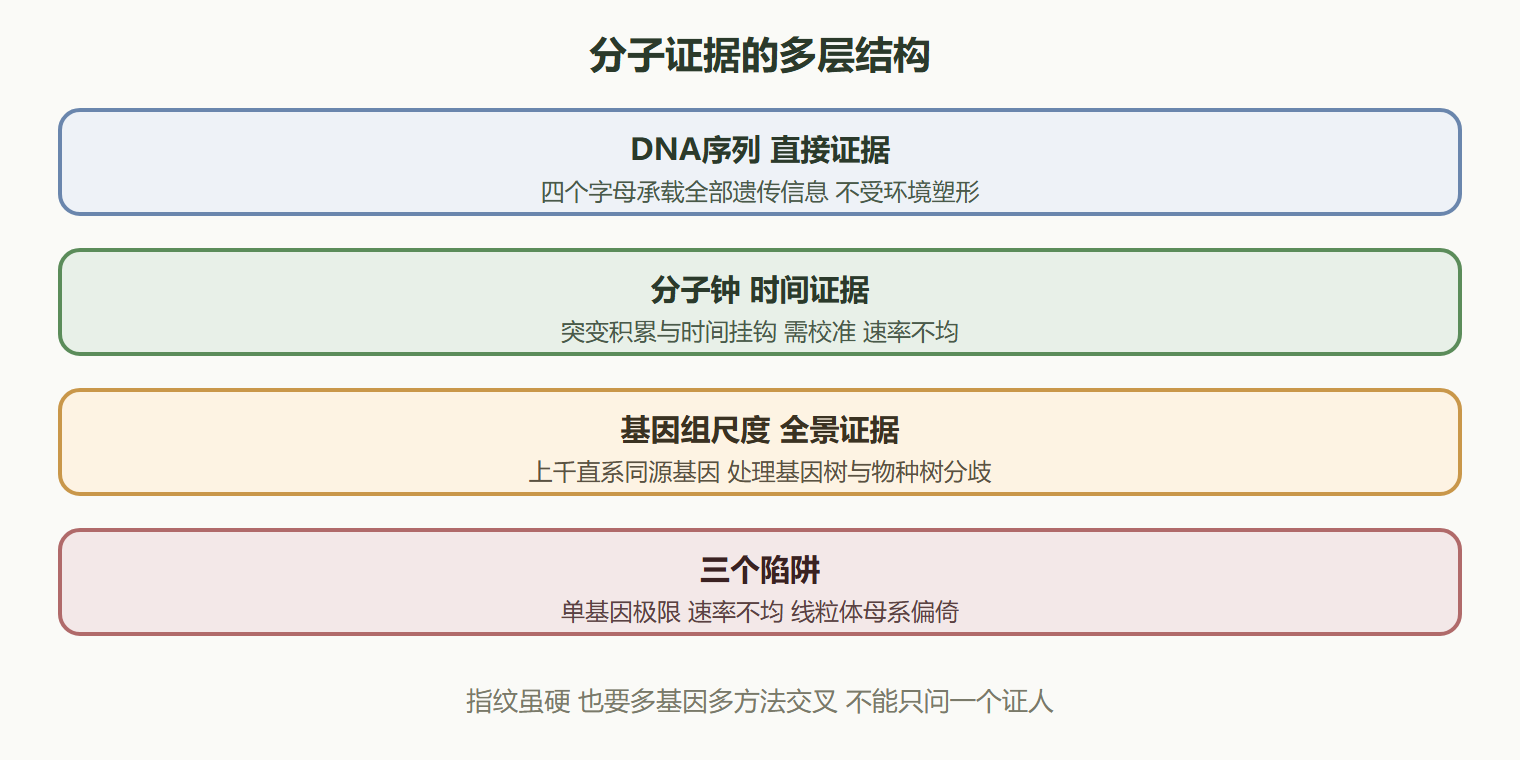
形态特征的问题是它混合了三种来源:遗传的、环境的(同一个体的形态会随环境改变)、历史的(趋同和返祖会制造假相似)。DNA 序列则绕开了大部分噪音——它是遗传信息的直接载体,不受环境塑形,突变按统计规律积累,于是序列差异天然携带"分化时间"的信息。
更关键的是,分子证据数量巨大且可量化。一条形态特征只能问"有或无、像或不像",一页 DNA 序列可以问"每个位点相同还是不同、差异是转换还是颠换、速率是快是慢"。数据从几十个离散特征跃升到上千个连续位点,分类学家第一次可以用统计模型检验自己的假设,而不是靠直觉加权。这就是为什么分子标记被形象地叫"指纹"——指纹不看你长什么样,只看你的唯一标记。
分子证据也带来了自己的陷阱,得提前说清楚。其一,单基因的极限:一个基因的树不一定是物种的树,基因树与物种树之间隔着"不完全谱系分选"和"杂交渐渗"两层滤镜。其二,速率不均:不同谱系的分子钟走速不同,把分子钟当匀速摆来读,会得出离谱的分化时间。其三,样本与标记的偏倚:只测一个线粒体片段,等于只问一个证人,证人恰好是母女系传承的(线粒体只随母系遗传),会漏掉父系的故事。这些陷阱在后面的第 5 章会逐一展开,本节先把"分子证据必须多基因、多方法交叉"这条规矩立下来。
二、分子革命的三次翻案
分子证据登场的第一个效果,是把几个"铁案"翻了个底朝天,每个翻案都像一记重锤砸在形态分类上。
鲸入偶蹄目:上一站已讲,鲸与河马互为姐妹群,颠覆了"水生哺乳动物自成一系"的直觉,也结束了"鲸近熊"的百年争论。
鸟入恐龙:形态分类把鸟单独设为纲,分子与化石证据合流后,鸟被确认为兽脚类恐龙的一个现存分支——如今"鸟纲"在系统发育框架里是恐龙纲下的一条支,蜥蜴、鳄鱼、鸟三者中,鳄与鸟最近,而不是鳄与蜥蜴。这个翻案直接打穿了"爬行纲"这个沿用几百年的单元——它不是单系,它的成员里混着不是一家的。
真菌出植物界:真菌曾经安稳地住在植物界,因为它们"长在地上、不会动"。分子数据显示真菌与动物共祖,同属后鞭毛生物,与植物亲缘甚远。于是真菌被整体搬出植物界——全世界的植物学教材都要改写法,所有数据库的层级都要重排。
三次翻案的共同点值得记牢:翻案不是因为旧观测错了,而是因为旧观测只看到了演化的表型面具。蝙蝠与鸟的翅膀像,是趋同;鲸与鱼的身体像,也是趋同;真菌与植物的"扎根",还是趋同。分子把趋同这层厚滤镜摘掉,露出下面的真实亲缘。
三、整合系统学:把证据装进同一个框架
分子时代真正的贡献,不只是"用序列取代形态",而是逼出了一套新方法论:整合系统学。今天的顶级分类研究早已超越"该用哪个基因"的技术争论,进入多证据协同决策的场域。它要求办案人同时驾驭四条证据线:分子线(基因组、转录组、表观组)、形态线(解剖、显微结构、几何形态计量)、生态行为线(声谱、食性、栖息地、环境 DNA 共现)、时空线(化石记录、分子钟、古地理模型)。这四线不是各自给答案再投票,而是装进一个统一的概率框架里,各自带权重地约束同一个系统发育假说。
一个具体的例子:2017 年前后对东南亚树蛙的研究,把鸣叫频谱的主成分、线粒体 16S 序列、核基因 RAG1、海拔分布模型四类证据放进同一框架,原被视为单一种的 Raorchestes chalazodes 被拆成五个隐存种——五个"长得几乎一样、叫声和基因各不同"的物种。这个案子告诉我们,整合系统学的信条是:物种边界是多维证据收敛的统计显著性区域,不是单一维度的绝对阈值。
用概念代码体会一下"多证据加权"的思路——这不是生产脚本,是把第 5 章会详细讲的贝叶斯思路压成可读形式:
# 概念示意:多证据整合判亲(伪代码,非生产实现) def estimate_tree(species_list, evidence_sets): # evidence_sets: 形态矩阵、序列比对、声谱数据、分布模型 prior = uniform_over_trees(species_list) # 树空间上先验均匀 for name, data in evidence_sets.items(): likelihood = fit_substitution_model(data) # 每种证据一个似然 prior = prior * likelihood.weighted(name) # 按证据可信度加权 return argmax_posterior(prior) # 输出最大后验的树
四、完整案例:iBOL 与 DNA 条形码的二十年
背景:2003 年,科学家提出用线粒体 COI 基因的一段约 650 碱基的序列作为动物的"条形码"——就像超市扫码一样,扫一段序列就知道是哪个物种。这个想法激进之处在于它把鉴定从"专家看标本"变成"机器比对序列"。操作:全球科研机构联合成立国际条形码生命计划(iBOL),建立参考数据库,先给已知种逐一"录入指纹",再让未知样本去比对。结果:截至 2023 年,数据库收录超过 1200 万条条形码序列,覆盖数十万物种,海关、检疫、生态监测大量改用条形码做初筛。解读:条形码的成功在于把鉴定门槛降到了"能测序就能鉴定",但它也暴露出边界——线粒体 COI 在近缘种、杂交种面前分辨率不足,隐存种会漏,快速辐射类群会错,单靠条形码定案仍需形态与核基因复核。变式:这正是 LN-2026-0717 的处境。给这只蛾扫一段 COI 条形码是标准动作,但条形码比对只回答"有没有已知种匹配",若匹配不上,要立新种还得回第 4、5 章做全套证据——条形码是入口,不是终点。
五、分子时代之后:谁退场,谁留下
一个常被问的问题:分子这么强,形态学是不是该退休了?答案是形态不仅没退场,反而被分子"解了锁"。分子给形态提供了校准坐标,形态反过来给分子提供了生态与功能含义——序列告诉你"它和谁一家",形态告诉你"它怎么过日子"。琥珀里的蚊子没有基因组,化石类群只能靠形态;形态学在古生物、生态功能、物种快速筛查上依然不可替代。分子与形态不是对手,是互补的证人:一个说身份,一个说生活。这也解释了为什么第 4 章会花一整章讲"如何把形态当证据",而第 5 章讲"如何把序列建树"——两套本事都得出,才能把这门生意做成。
本节要点回顾
- 分子证据硬在:直接承载遗传信息、不受环境塑形、差异可量化可建模;
- 分子陷阱要记牢:单基因极限、分子钟速率不均、线粒体母系偏倚;
- 三次翻案(鲸、鸟、真菌)证明形态在深层亲缘存在系统性盲区;
- 整合系统学把分子、形态、生态、行为装进统一概率框架,按权重协同;
- 形态没退场而是被解锁,两套证据一个说身份一个说生活;
- 条形码是鉴定入口不是终点,立新种仍需全套证据。
旧档翻完。第 3 章进入工序二——对名录,看看命名的国际法规怎么管住全世界的物种户口。