7.1 硬件加速接口:把编解码交给 GPU
7.1 硬件加速接口:把编解码交给 GPU
本节摘要:NVENC、QSV、VAAPI 分别对应 NVIDIA、Intel、通用 Linux 的硬件编解码接口。本节讲清各接口的归属、在 FFmpeg 里的参数写法,以及硬解硬编在速度、画质、兼容性上的真实取舍。
本节目标:阅读完本节,你应当能够:
- 说出 NVENC、QSV、VideoToolbox、VAAPI 对应哪家硬件、哪个平台
- 用
-hwaccel完成硬解,用-c:v h264_nvenc等完成硬编 - 判断什么场景该用硬解、什么场景别用,并说出代价
一、数字事实开场
一个 1080p 视频软转码,libx264 的 medium 预设大约能跑 2–4 倍实时速(一台普通服务器);换成 NVIDIA 的 NVENC 硬编,轻松 20 倍以上,CPU 占用从接近 100% 掉到个位数。同样一段 4K 视频,软解能把 CPU 打满还卡顿,硬解几乎不动 CPU。
这组数字解释了为什么所有直播平台、监控平台都在抢 GPU。但硬解硬编不是「免费的午餐」——它的画质受硬件能力限制,编码参数选择面窄,且不同平台接口不通用。本节把这些差异摆到台面上。
二、核心原理:四大硬件接口
| 接口 | 归属 | 平台 | 硬解写法 | 硬编写法 |
|---|---|---|---|---|
| NVENC/NVDEC | NVIDIA | 所有 NVIDIA GPU | -hwaccel cuda |
-c:v h264_nvenc |
| QSV | Intel | Intel 核显/独显 | -hwaccel qsv |
-c:v h264_qsv |
| VideoToolbox | Apple | macOS/iOS | -hwaccel videotoolbox |
-c:v h264_videotoolbox |
| VAAPI | 通用 Linux | AMD/Intel 等 | -hwaccel vaapi |
-c:v h264_vaapi |
选择逻辑很简单:先看自己机器的显卡,再看 ffmpeg 编译时带了哪个。ffmpeg -encoders | grep nvenc 能查 NVENC 是否可用。
硬解命令解剖
# CUDA 硬解:解码走 GPU,编码用软编码器 ffmpeg -hwaccel cuda -i input.mp4 -c:v libx264 -crf 23 output.mp4
-hwaccel cuda 只加速解码,编码仍是 CPU。这种「硬解 + 软编」组合常见于监控转码——解码路数多,CPU 省下来给编码用。
硬编命令解剖
# 解码软解、编码硬编:适合大批量转码 ffmpeg -i input.mp4 -c:v h264_nvenc -preset p4 -cq 23 output.mp4
NVENC 的码率控制参数和 x264 不同:-cq 类似 CRF(值越小越好),-preset 可选 p1–p7(p1 最快)。不要把 -crf 23 直接丢给 NVENC,它不认。
全硬:硬解 + 硬编
ffmpeg -hwaccel cuda -hwaccel_output_format cuda -i input.mp4 \ -c:v h264_nvenc -cq 23 output.mp4
-hwaccel_output_format cuda 让解码后的帧留在 GPU 显存,直接喂给 NVENC,避免「GPU→CPU→GPU」来回搬。这是真正的「全硬」链路,也是零拷贝思想的雏形(下节展开)。
三、工程实践要点
什么时候该用硬解
| 场景 | 建议 |
|---|---|
| 多路监控解码 | 必须硬解,CPU 扛不住几百路 |
| 批量点播转码 | 硬编值得,省电省机器 |
| 高画质存档 | 软编更好,硬编画质上限低 |
| 快速预览 | 硬解硬编都行,图快 |
硬编的画质代价
NVENC 的编码质量在低码率下和 x264 差距明显——相同体积下细节丢失更多。高码率(如 10 Mbps 以上)差距缩小。所以「省流量」和「硬编」是有张力的:硬编速度快,但要在画质上让步。
验证硬解生效
# 转码时看日志:出现 hwaccel 相关行说明硬解生效 ffmpeg -hwaccel cuda -i input.mp4 -c:v libx264 -y output.mp4 2>&1 | grep -i "hw"
硬解没生效的典型表现:CPU 依然打满,日志里找不到 hwaccel 字样。
用一张图总结「软/硬」的配合关系:
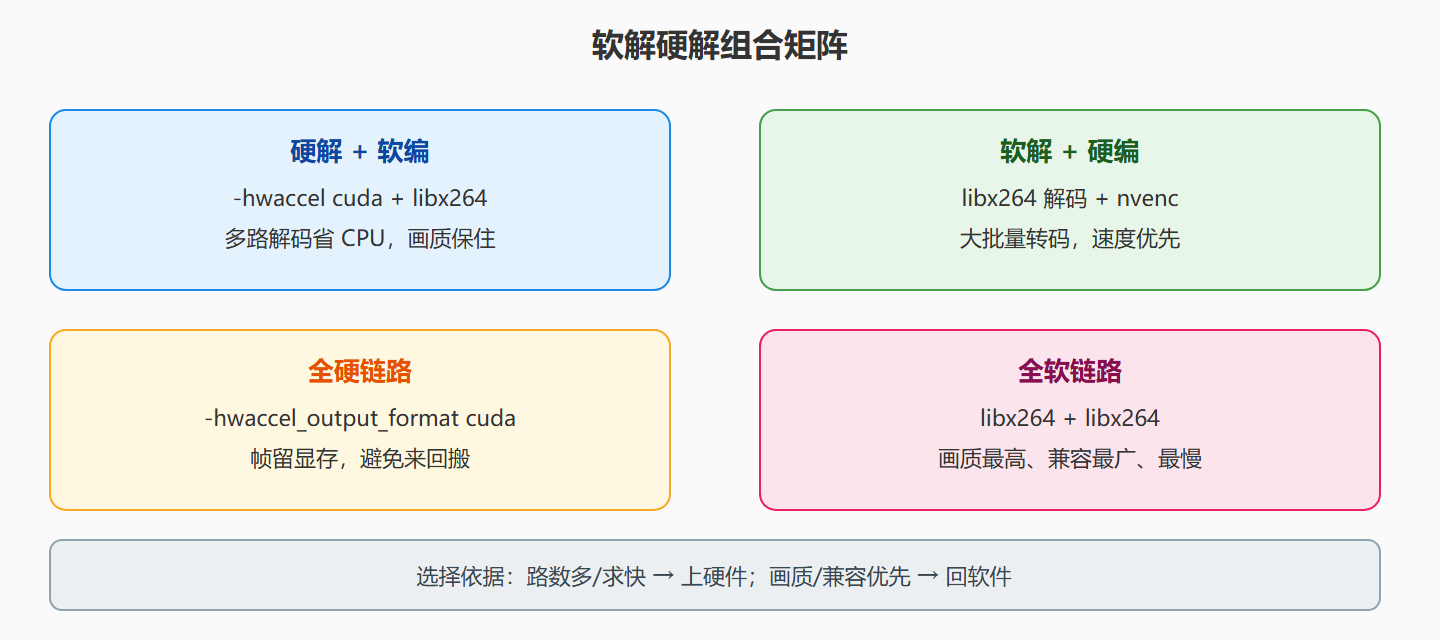
图说明:四种组合
软硬可以自由组合,每种组合都有典型场景。判断依据就一句话:瓶颈在速度还是在画质? 速度瓶颈上硬件,画质要求高回软件。
常见坑:NVENC 的参数和 x264 不通用(-crf 会报错或忽略,要用 -cq);硬解不是「加上就生效」,编码器选错(用了 -c:v libx264 却说没加速)CPU 依然打满;VAAPI 需要指定显存设备,多卡机器要 -vaapi_device 挑卡。
💡 关键直觉:硬件加速的本质是「用专用电路的固定逻辑换速度」。它擅长它被设计好的事(H.264/H.265 编解码),遇到不支持的格式或新参数,就会悄悄退化或报错——所以先查
-encoders确认支持,再谈提速。
硬解的另一个隐藏收益:省电
硬解带来的不只是速度,还有功耗的下降。同样解码一路 4K 视频,CPU 软解功耗可能到 30 瓦,NVDEC 硬解只有 3–5 瓦。对移动设备、电池供电的采集端、以及按功耗计费的数据中心,这个差距会直接变成成本差异。很多便携设备的续航焦虑,有一半就消耗在「用 CPU 软解视频」上。
不过省电的前提是硬解真的生效。用 nvtop、nvidia-smi 这类工具能看到 GPU 利用率,如果转码时 GPU 一直是 0%,说明你的命令根本没走上硬件路径——最常见的原因是滤镜把帧拉回了内存(第 7.2 节零拷贝会详述),或者编码器名字写错。学会确认「硬件到底干活没有」,是硬解这条路上比学会参数更重要的一课。
本节要点回顾
- 四大接口:NVENC(N 卡)、QSV(Intel)、VideoToolbox(Apple)、VAAPI(通用 Linux)
- 硬解命令:-hwaccel cuda 只加速解码;全硬再加 -hwaccel_output_format cuda
- 硬编命令:-c:v h264_nvenc + -cq + -preset p1–p7,参数与 x264 不通用
- 画质取舍:低码率下硬编画质弱于软编,高码率差距缩小
- 验证生效:日志里看 hwaccel 字样,CPU 是否降下来
下一节深挖「帧留在显存」背后的学问——零拷贝的成本与边界。