7.2 零拷贝:减少数据搬运
7.2 零拷贝:减少数据搬运
本节摘要:「零拷贝」在 FFmpeg 语境里指减少数据在 CPU 内存与 GPU 显存之间的反复搬运。本节讲清数据搬运的成本来源、FFmpeg 里零拷贝的具体形态,以及它为什么不是「万能加速键」。
学习目标
阅读完本节,你应当能够:
- 解释「数据搬运」的成本来源(内存拷贝、PCIe 传输)
- 说出 FFmpeg 里两种零拷贝形态:显存驻留与引用计数
- 判断一个场景是否真的需要零拷贝,并说出它的适用边界
一、一个反例开场
有同学听说「零拷贝能提速」,于是在所有转码命令里都加了 -hwaccel_output_format cuda。结果部分命令报错,部分变慢,反而比不用还糟。问题出在他没搞懂:零拷贝解的是「GPU 场景」的病,没有 GPU 时它连药都算不上。
先看数据搬运的成本。一次硬解硬编的默认路径是这样的:GPU 解码出帧 → 拷回 CPU 内存 →(可能加工)→ 拷进显存 → GPU 编码。每一步 PCIe 拷贝都是几百 MB/s 的吞吐损耗,路数一多,这部分开销甚至超过编解码本身。「零拷贝」的目标就是把这两次跨设备拷贝省掉。
二、核心原理:零拷贝的两种形态
形态一:显存驻留(GPU 场景)
这是 -hwaccel_output_format cuda 干的事:让解码后的帧留在显存,需要加工时用 GPU 滤镜(如 scale_cuda),最终直接喂给 NVENC,全程不碰 CPU 内存。
# 全硬 + GPU 缩放,帧全程留在显存 ffmpeg -hwaccel cuda -hwaccel_output_format cuda -i input.mp4 \ -vf "scale_cuda=1280:720" -c:v h264_nvenc -cq 23 output.mp4
注意滤镜换成了 scale_cuda——普通滤镜(scale)作用在 CPU 内存的帧上,会强制把帧搬回内存,零拷贝就失效了。这是最容易踩的坑。
形态二:引用计数(软件场景)
第 2 章提过引用计数:多个结构共享一块数据,不拷贝本体。在纯软件管线里,它避免的是「解码帧 → 滤镜 → 编码」之间的重复 memcpy。FFmpeg 内部大量使用这种机制,命令行用户感知不到,但 SDK 开发(第 8 章)里它是内存效率的命脉。
三、工程实践要点
什么时候零拷贝真有用
| 场景 | 零拷贝收益 | 说明 |
|---|---|---|
| 多路硬解硬编 | 大 | 省掉每路两次 PCIe 拷贝 |
| 单路转码 | 小 | 瓶颈常在编码本身 |
| 纯软件管线 | 无 | 没有跨设备拷贝可省 |
怎么判断要不要上
先测速再优化。三步走:
- 先跑一遍当前方案,记下耗时与 CPU/GPU 占用
- 加上零拷贝配置再跑一遍
- 对比两者,收益明显才保留
盲目加 -hwaccel_output_format cuda 却继续用普通 scale 滤镜,等于零拷贝被滤镜「打回原形」,还得不到任何好处——这是最常见的伪优化。
引用的代价
零拷贝(引用计数形态)省了拷贝,代价是「数据可能被共享修改」。多线程场景里,两个消费者共享一帧,一个在改、一个在读,就会数据竞争。FFmpeg 通过「写时复制」缓解,但写代码时仍要小心——这是 SDK 层反复出现的坑。
用一张图对比「默认搬运」与「零拷贝」两条路径:
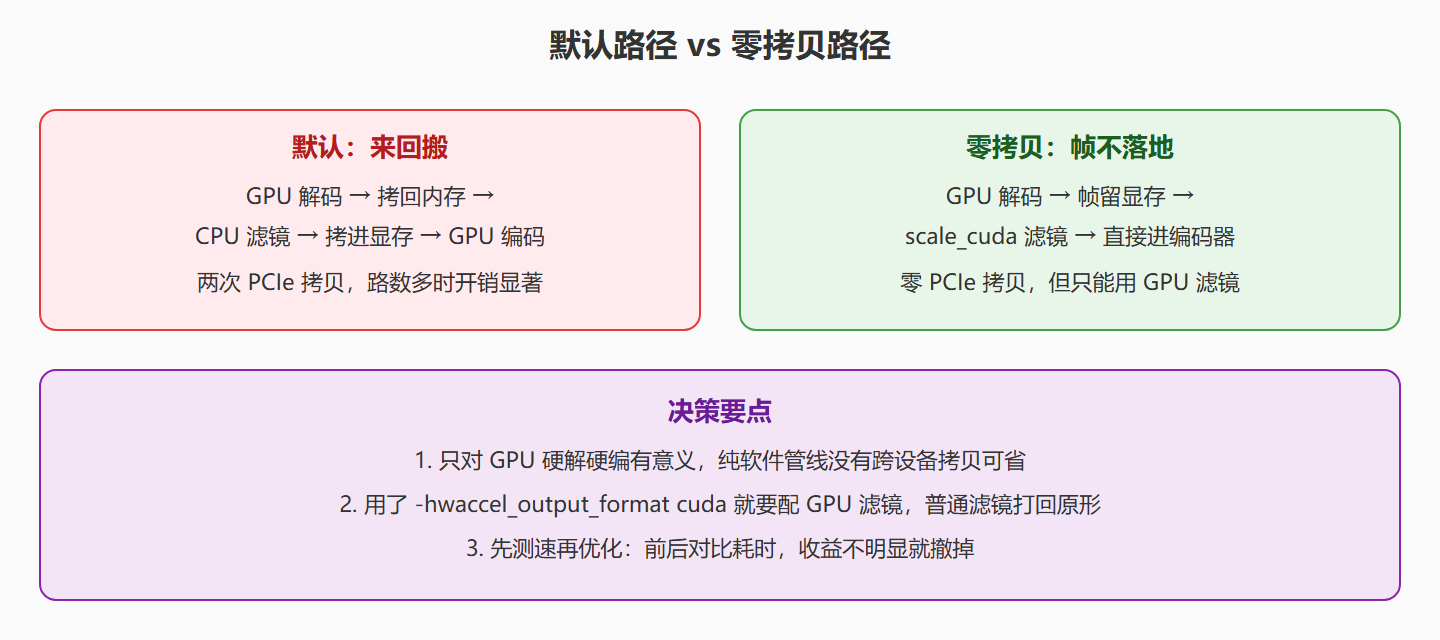
图说明:两条路径
左侧默认路径数据两度穿越 PCIe 总线,右侧零拷贝路径全程留在显存。零拷贝的优势只在这个「GPU 全链路」里成立,且强制你使用 GPU 滤镜。图下方的三条决策要点是实战总结,照做即可避免伪优化。
⚠️ 常见坑:
-vf "scale=..."配-hwaccel_output_format cuda,帧被 scale 拉回内存,零拷贝失效;GPU 滤镜名字都带_cuda(scale_cuda、overlay_cuda);某些滤镜根本没有 GPU 版,遇到就只能放弃该段的零拷贝。
💡 关键直觉:零拷贝的本质是「别搬数据,搬引用」。凡是涉及大块数据跨设备/跨线程流动的,先问一句:能不能只传指针?这个习惯在 SDK 开发里比命令行走得更远。
引用的代价:写时复制
引用计数省了拷贝,但带来了「共享可变」的隐患——两个结构共享同一块数据,一个改了一个还没反应过来。FFmpeg 的解法是写时复制(Copy-on-Write):当检测到有人要修改共享数据时,先复制一份再改,保证每个持有者看到的都是自己的版本。
这个机制的代价是:修改越频繁,复制越频繁,引用计数的收益就越小。如果一段滤镜链每个节点都要改帧(比如逐帧加文字),那么每一帧都要被复制若干次,零拷贝的优势就荡然无存。判断依据很简单:你的流程是「只读传递」还是「频繁改写」?只读多,零拷贝香;改写多,反而可能更慢。
实践中还有一个容易踩的点:av_frame_ref 建立的是浅引用,如果你在别的线程里持有这个引用,而主线程已经把原帧释放了,就会用到悬垂数据。多线程开发时,跨线程传帧一定要想清楚「谁负责释放」。
什么时候别折腾零拷贝
零拷贝不是万金油,有两个场景建议直接放弃它。第一个是纯 CPU 转码:没有 GPU 参与,数据都在内存里,所谓「零拷贝」无从谈起,FFmpeg 内部的引用计数已经做了该做的优化,你不需要额外操作。第二个是频繁读写帧数据的滤镜链:每帧都要被算法改写,写时复制会不断触发,拷贝次数反而上升。
判断是否值得折腾,最简单的办法是实测:先跑一遍默认配置,记录耗时,再上零拷贝配置,再记录耗时。如果提升不到 10%,就别为它增加命令复杂度。性能优化的悖论就在这——大多数时候,简单配置已经够快,真正该优化的是「别做多余的事」:少转一次格式、少一次滤镜、少一次跨设备搬运。
要点回顾
- 搬运即成本:GPU 场景下 PCIe 拷贝是真实瓶颈,路数越多越明显
- 两种形态:显存驻留(GPU 场景)与引用计数(软件场景)
- GPU 滤镜配套:零拷贝要求滤镜也走 GPU(scale_cuda),普通滤镜会打回原形
- 适用边界:单路转码收益小、纯软件无收益,别盲目上
- 先测速再优化:对比前后耗时,收益不明显就撤
下一节从硬件回到软件——多线程、滤镜并行这些不花钱的提速手段。