1.3 开发环境与编译器生态
1.3 开发环境与编译器生态
本节摘要:语法与哲学讲完,回到工程现实——怎么把代码跑起来、怎么管依赖、怎么补上标准库的缺口。本节介绍三条工具链主线:gfortran(开源基准)、ifx(LLVM 化的 Intel 编译器)、nvfortran(面向 GPU),以及 fpm 这一"约定优于配置"的构建工具如何终结 Fortran 项目的 Makefile 混乱,最后说明 stdlib 与编辑器 LSP 补上了生态的哪些窟窿。
一个新手最常见的劝退现场
你从同事手里接过一个科研代码包,里面是一个 300 行的 Makefile、三个不同版本的编译器都编译不过的源码、还有一个"记得加 -O2 否则会跑错"的口头嘱咐。这不是段子,是老 Fortran 项目的普遍生态。本节要解决的,就是让这个现场成为历史——现代 Fortran 的工具链已经能像其他主流语言一样干净利落。
三选一:gfortran、ifx 还是 nvfortran
编译器是性能的上限,也是兼容性的下限。当前主流是三家:gfortran 是 GNU 家族的开源基准,随 Linux 发行版自带,对新标准的支持稳健,是学习与一般科研项目的第一选择;Intel 的 ifx 基于 LLVM 架构,是 ifort(经典编译器)的接班人,对 x86 平台的自动向量化与 OpenMP 支持最深,工业与超算项目常见;NVIDIA 的 nvfortran 深度绑定 CUDA 生态,擅长把 OpenACC/OpenMP offload 到 GPU,异构计算的场景绕不开它。
# 三种编译器的入门用法(现代标准,自由格式) gfortran -std=f2018 -O2 -o demo demo.f90 ifx -std=f2018 -O2 -o demo demo.f90 nvfortran -std=f2018 -O2 -o demo demo.f90
选型没有银弹:追求省事与可移植选 gfortran;目标是跑在自家集群、想榨取 x86 向量性能选 ifx;要写 GPU 内核选 nvfortran。同一个 .f90 文件在三家之间通常能直接迁移,因为标准在前,厂商扩展在后。要注意的坑是各家对 Fortran 2018 新特性(子模块、错误终止)的支持进度不一,写代码时尽量停留在三家都支持的交集上。
fpm:把 Cargo 的思路搬进 Fortran
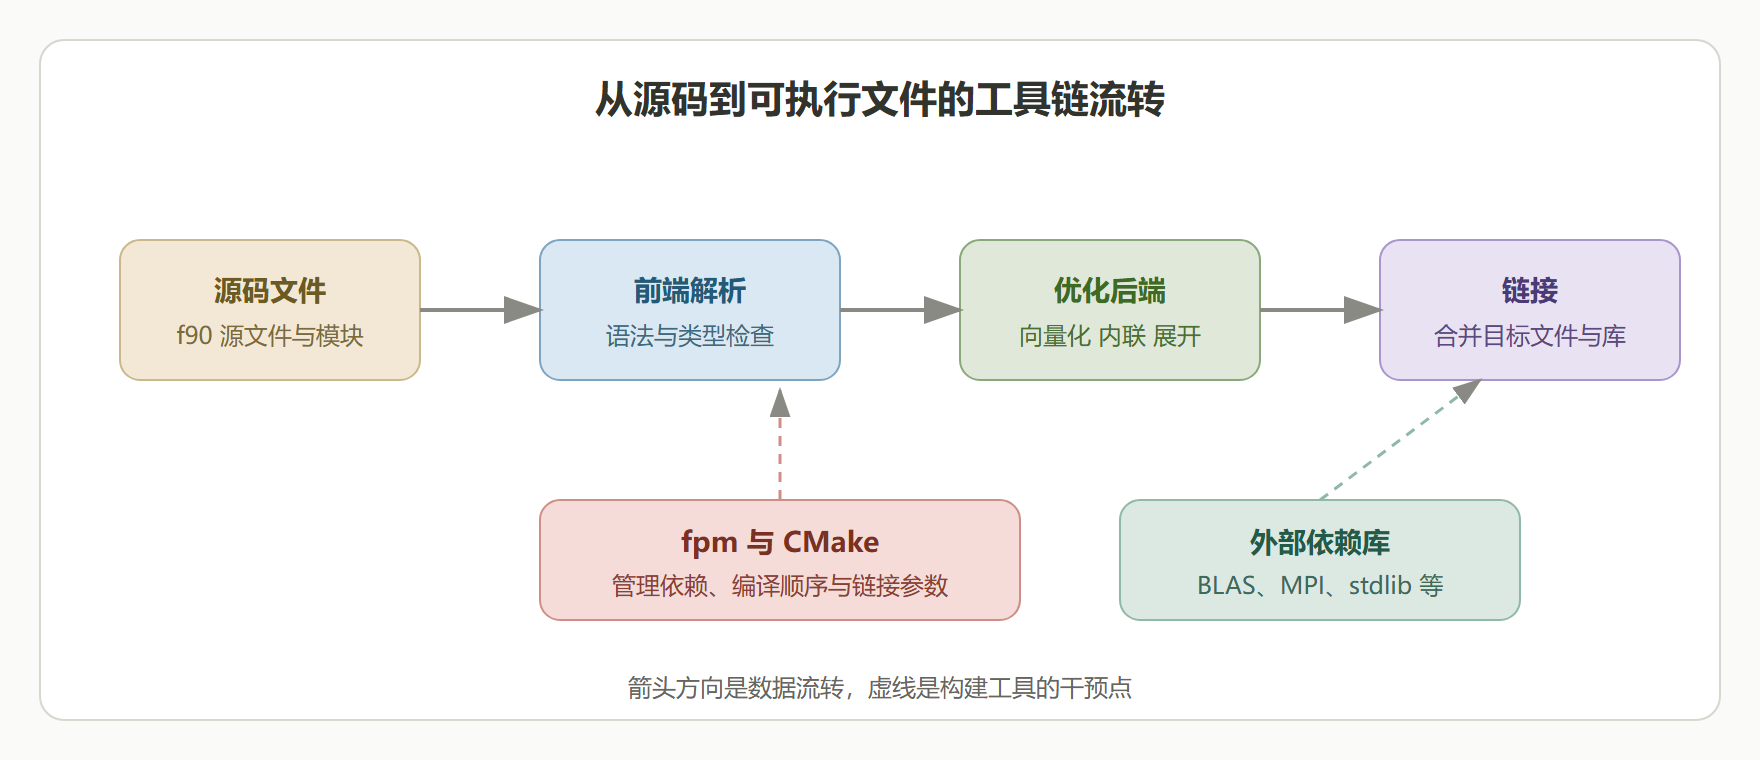
fpm(Fortran Package Manager)是 Fortran 社区补上"依赖管理"这块短板的关键工具。它的核心主张是约定优于配置:项目根放一个清单文件,声明元数据、依赖、可执行程序与测试,fpm 自动处理依赖下载、编译顺序与测试运行。
# 一条命令建起一个新工程 fpm new my_solver # 构建并运行 cd my_solver fpm run # 跑测试 fpm test
# 工程清单的核心字段(fpm 工程配置文件示例) name = "my_solver" version = "0.1.0" license = "MIT" [dependencies] stdlib = "2.1"
注意上面的依赖写法只是示意:真实项目里依赖名与版本号来自社区注册表,fpm 会按版本解析并锁定。有了 fpm,新成员接手项目不再需要背诵编译参数,一条 fpm build 就能复现环境——这直接解决了科研代码"换台机器就跑不起来"的老毛病。
CMake 何时登场
fpm 擅长纯 Fortran 库与应用的快速开发,但遇到混合语言工程(Fortran 内核 + C/C++ 外壳 + Python 扩展)时,CMake 依然是标准答案。CMake 的优势是跨平台抽象与庞大的工具链集成:它能同时生成 Make、Ninja 与 IDE 工程,能优雅地处理外部依赖查找,也能在同一个构建里混合编译 Fortran 与 C 源码。经验法则:纯 Fortran 小项目用 fpm;需要精密控制构建流程或要和其他语言混编的复杂系统,上 CMake。两者不冲突,很多现代项目先用 fpm 管理 Fortran 内部,再在 CMake 里以子目录方式接入。
补全生态:stdlib 与编辑器
Fortran 标准核心之外一度是真空:字符串处理、文件遍历、哈希表这类常用设施全靠自造,导致重复造轮子与兼容性问题。社区驱动的 stdlib 项目正在填补这个空缺,它按标准流程评审、跨编译器兼容,提供线性代数、排序、哈希、字符串等基础模块,目标是把常用设施收进统一接口,让 Fortran 项目不必为每个小功能重造轮子。开发体验方面,编译器前端 + 语言服务器(LSP)让现代编辑器获得了语法检查、自动补全与跳转定义,百万行代码库里定位一个符号不再是体力活。
图:编译工具链的数据流转
环境的坑与建议
装编译器优先用系统包管理或官方安装器,别从源码编译——Fortran 编译器自身依赖复杂,从源码装容易劝退。写新项目第一件事就建 fpm 工程并写一个冒烟测试,让"能不能跑"从一开始就有机器可查的标准。如果项目要交到别人手里十年后还能构建,把编译参数与依赖版本写进工程清单,而不是写在口头嘱咐里。
学习目标
阅读完本节,你应当能够:
- 说出 gfortran、ifx、nvfortran 三者的定位差异,并给出选型建议
- 用 fpm 从零建一个带依赖、带测试的最小工程
- 判断什么场景该换用 CMake 而非 fpm
- 了解 stdlib 提供的常用模块,以及 LSP 对现代 Fortran 开发的意义
本节要点回顾
- 三选一有明确场景:gfortran 开源可移植、ifx 榨 x86 性能、nvfortran 面向 GPU
- fpm 终结 Makefile 混乱:约定优于配置,一条命令完成构建、运行与测试
- CMake 留给混编工程:纯 Fortran 用 fpm,跨语言与复杂构建用 CMake
- stdlib 补标准库空缺:字符串、排序、哈希等基础模块免去重复造轮子
- LSP 提升大库可维护性:跳转定义与自动补全让百万行项目可导航
- 把环境写进配置而非口头:依赖与编译参数进清单,十年后还能复现构建
工具齐了,从第 2 章开始进入语法腹地:先看类型系统——数值计算的信任基石。