- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:读一本数值计算代码的演化日志
一句话定位:这是一本把 Fortran 当"数值计算代码演化日志"来读的教程——从 1957 年打孔卡片上的第一个公式翻译器,到今天与 Python、C 混编的 GPU 求解器,按语言与生态的演化阶段推进,每章是一个演化节点,回答同一个问题:为什么这套五十年前的老代码库仍然活着,而且活得比多数新语言更结实。
这个教程解决什么问题
气候模型、核反应堆安全分析、机翼气动仿真、等离子体约束模拟——这些每天吞吐万亿次浮点运算的代码,底层大多是 Fortran 写的。初学者最容易产生的误解,是把 Fortran 当成一门"考古语言":以为学会了它就能维护遗产代码,却不知道现代标准(2003、2008、2018,乃至 2023)里已经住进模块、派生类型、面向对象、协同数组这些现代特性。
另一个真实痛点来自技术选型。很多团队在 Python 里把数值原型跑通了,一上规模就发现性能不对,回头找底层引擎,发现最顺手的高性能库内核全是 Fortran。想把它接进自己的流水线,却读不懂接口,更不敢改。本教程要做的,就是把这些"演化档案"摊开:讲清楚每一代标准为什么这么改、老代码里的哪些习惯今天必须改掉、哪些设计反而是它活到现在的本钱。
适合谁读
- 已经在用 Python/NumPy 做科学计算,想理解底层"引擎"原理的工程师
- 气象、物理、力学、化学等方向的研究生,需要读懂甚至改写课题组遗留的 Fortran 求解器
- 需要把 Fortran 内核嵌入 C 或 Python 程序、做混合编程的开发者
- 想从零系统学现代 Fortran,而不是零散查手册的自学者
学完你能做什么
- 说出 Fortran 从 66 到 2023 各代标准的演化节点,以及每代标准解决的核心矛盾
- 用 kind 机制写出跨平台精度一致的数值代码,不再依赖编译器默认的坑
- 用派生类型与模块组织物理模型,把"一个物理对象"装进一个代码类型
- 熟练使用数组整体运算、掩码、构造与重构,写出能喂给编译器自动向量化的代码
- 用类型扩展与多态搭出可扩展的数值框架,并用参数化类型减少重复代码
- 区分协同数组、OpenMP、GPU 卸载三种并行模型各自的适用边界
- 通过 ISO C 绑定把 Fortran 内核接进 C 与 Python,完成一次真实的混合编程
- 为数值代码补上错误处理、测试与性能调优,让老库能继续活十年
全册知识地图
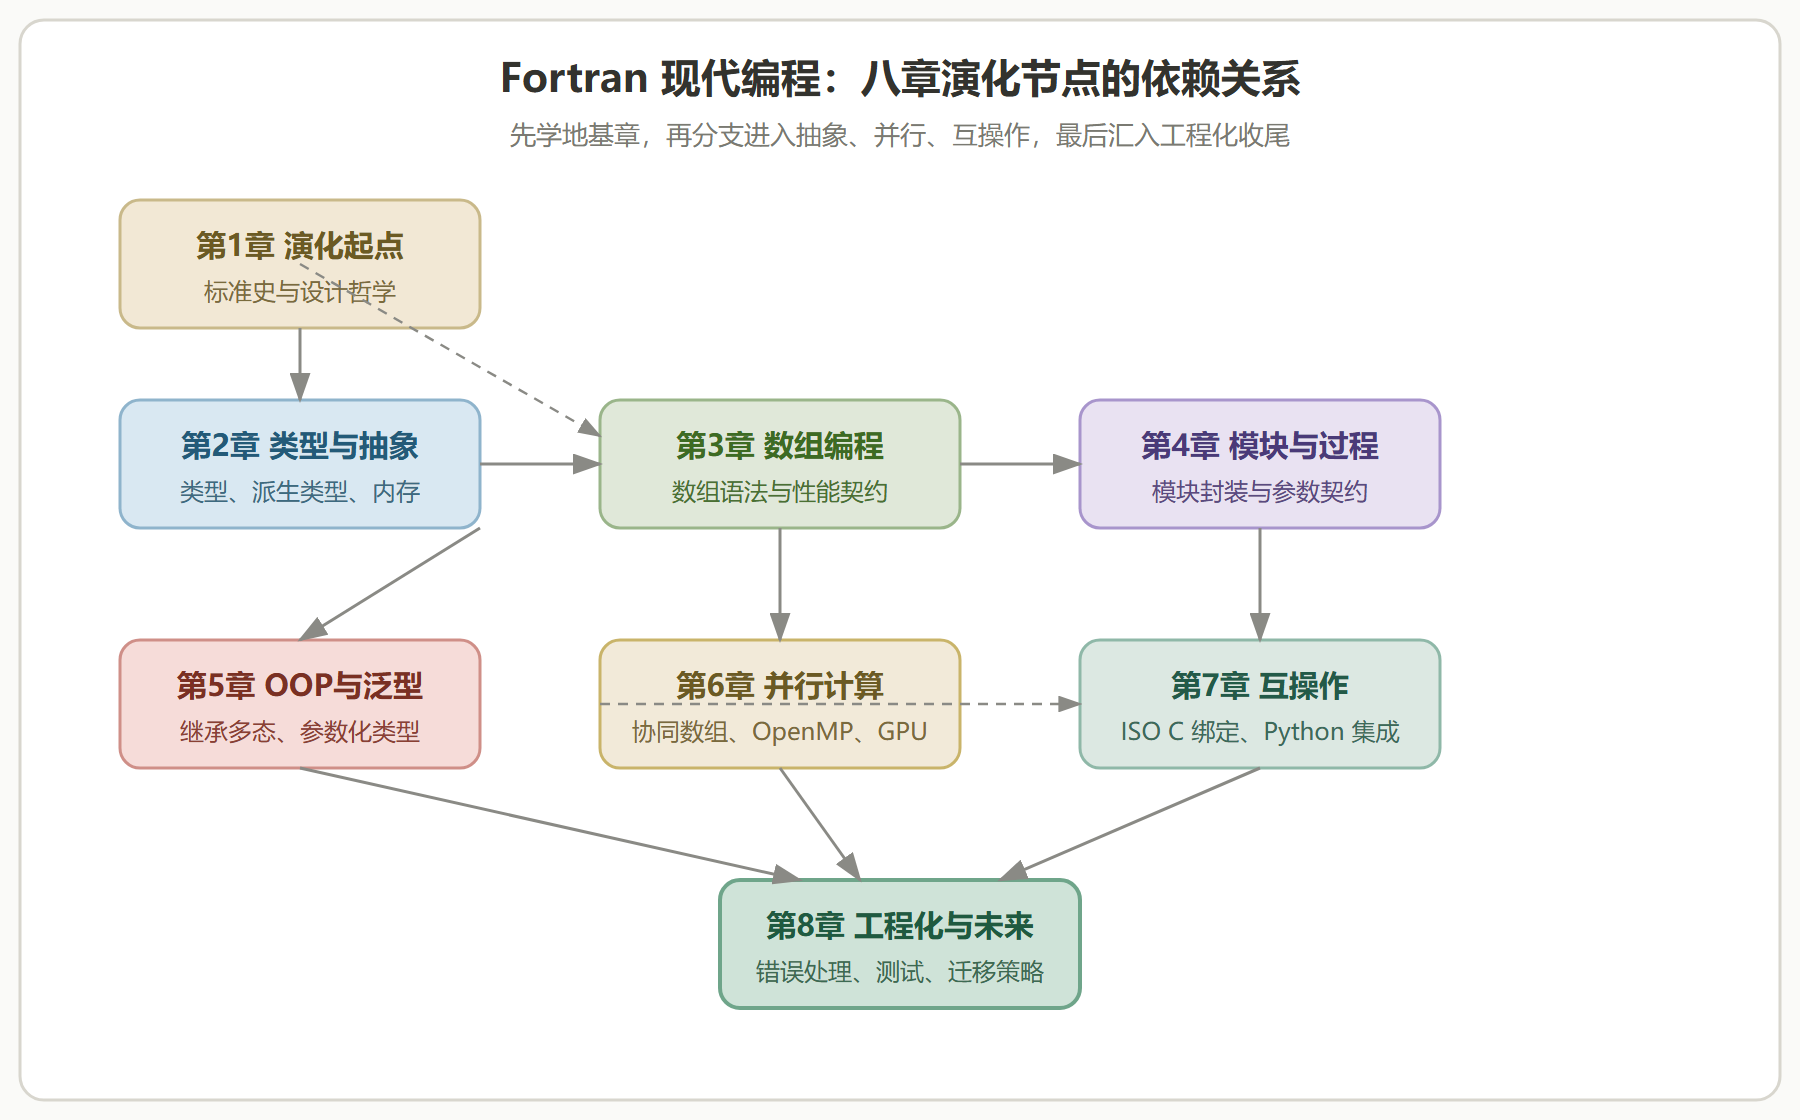
八章对应演化日志的八个节点。前三章是"地基":标准怎么来的、类型与数组这两套基本设施长什么样。第四章把过程式能力补全成可维护的模块体系,第五、六、七章分别铺开抽象(OOP 与泛型)、并行(多核到 GPU)、连接(与 C/Python 互操作)。第八章是收尾,讲工程化与迁移——为什么老代码库值得救,以及怎么救。
图:全册知识地图——八章的学习依赖关系
学习路线
第 1 到第 4 章建议顺序阅读,它们是后面一切内容的地基;第 5、6、7 章之间没有强依赖,可以按兴趣换序;第 8 章放在最后读,因为它综合使用了前面各章的工具。每章开头的支柱页会告诉你这一章在整个演化日志里的位置,以及读完该掌握哪些可检验的能力。
怎么用这个教程
动手环境只需要一台能跑 gfortran 的机器(Linux、Windows 或 macOS 都行,装法见第 1 章第 3 节)。节里的代码都是带注释的完整片段,建议边读边抄进编辑器跑一遍,改改参数看结果变化。并行与互操作的章节需要额外装 OpenMP、MPI 或 Python 解释器,相关环境在第 6、7 章开头单独说明。全书不依赖任何付费软件。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...