2.1 内置类型与精度选择
2.1 内置类型与精度选择
本节摘要:数值代码里最隐蔽的错误,往往不是算法写错,而是"这个数到底是几位精度"没说清楚。Fortran 用 kind 机制把"精度意图"写进声明,用 iso_fortran_env 的 real64、int32 等常量把精度标准化,用 parameter 与字面量后缀保证常量不被截断。本节从真实事故切入,讲清内置类型、kind 选择、初始化与保存语义,这些都是后续所有类型工作的原子。
一个反复出现的精度事故模式
数值计算领域反复出现过同一类事故:某段代码把物理常量写成 0.1 而不是 0.1d0。编译器先把 0.1 按单精度(约 7 位有效数字)存储,再转给双精度变量,误差在第 8 位就固化了;方程积分跑上百万步,这个固定偏差被一步步放大。早年就有长周期数值程序因此结果与实测系统性偏差,排查数年才定位到一行常量声明。这类事故的共同点:字面量的默认精度比想象中低,精度问题在声明期就埋下了。
kind:把"精度意图"写进声明
早期 Fortran 用 real*8、double precision 这类写法,把逻辑类型与具体字节数硬绑定。问题是"8 个字节"在部分平台上并不等于 64 位 IEEE 双精度。现代 Fortran 的做法是解耦"类型"与"表示":用 kind 参数声明精度意图,由编译器映射到具体存储。
program kinds_demo use iso_fortran_env, only: real32, real64, int32, int64 implicit none integer(int32) :: n ! 32 位整数 integer(int64) :: big_counter ! 64 位整数 real(real32) :: single_value ! 单精度:约 7 位有效数字 real(real64) :: double_value ! 双精度:约 15 位有效数字 single_value = 0.1_real32 double_value = 0.1_real64 ! 字面量后缀:直接以该精度存储 write(*,*) 'single =', single_value write(*,*) 'double =', double_value end program kinds_demo
use iso_fortran_env, only: ... 把精度常量导入当前作用域,real(real64) 声明一个双精度实数。字面量 0.1_real64 末尾的后缀是关键:它告诉编译器这个常量直接以 64 位精度存储,而不是先按默认的单精度存一遍再转换。习惯上,模块里通常定义一个 wp(working precision)常量,全工程统一使用,换精度时只改一处。
module precision_mod use iso_fortran_env, only: real64 implicit none integer, parameter :: wp = real64 ! 工程统一工作精度 end module precision_mod program use_wp use precision_mod, only: wp implicit none real(wp) :: x, y x = 1.0_wp y = 2.0_wp write(*,*) x + y end program use_wp
这样设计的收益是迁移成本趋近于零:某天需要从双精度换四精度,只改 precision_mod 里一行。代价是类型系统更严格——两个不同 kind 的变量做运算会编译报错或隐式转换,但正是这种"麻烦"在保护你。
parameter 与初始化:确定性从声明开始
parameter 属性定义编译期常量:值固定、类型受检查、能进符号表参与优化。物理常数、网格尺寸、数组边界这类"单一事实来源"都应该用它。
program constant_demo use iso_fortran_env, only: real64 implicit none real(real64), parameter :: c_light = 2.99792458e8_real64 real(real64), parameter :: gravity = 9.80665_real64 integer, parameter :: grid_size = 512 real(real64) :: field(grid_size) field = 0.0_real64 write(*,*) c_light, gravity end program constant_demo
声明时初始化则有一个陷阱:显式初始化隐含 save 属性。integer :: counter = 0 在过程里不是"每次进入都重置为 0",而是"第一次进入初始化为 0,之后一直保留"。这与 C/Python 里局部变量每次重建的直觉相反。若在递归或 OpenMP 线程里依赖"每次重置",就会得到无法理解的状态污染。所以规则是:需要每次重置的变量,在过程体内显式赋值;只有真正要跨调用保存状态,才在声明行初始化。
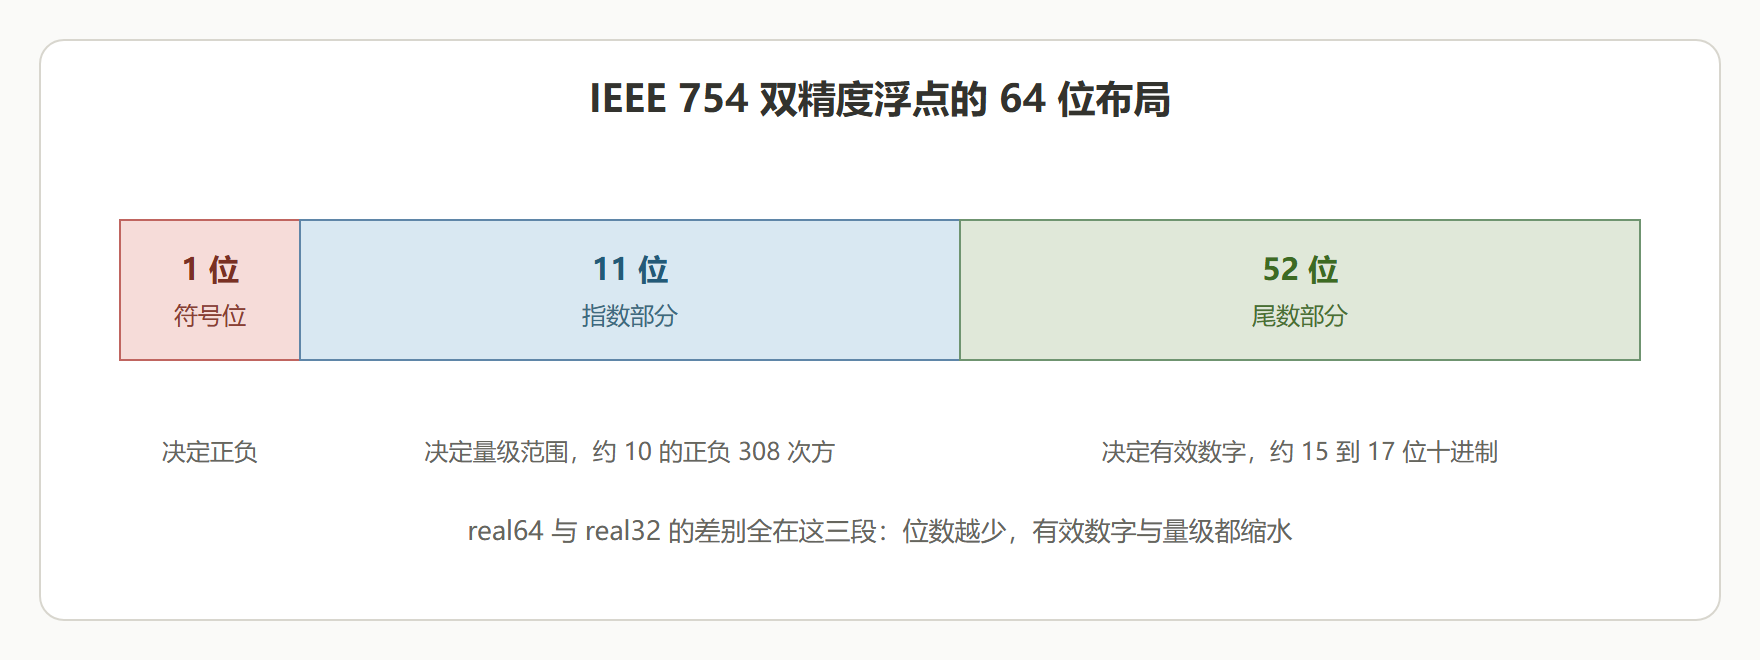
图:双精度数的内存布局——64 位里放了什么
精度选择的判断依据
没有"默认就该用双精度"这种简单答案,要看误差预算。判断顺序:先问结果误差的容许多大,再问中间量级跨度多大,最后问目标硬件向量宽度。气象与结构这类动辄迭代百万步的代码,双精度起步;机器学习的混合精度场景里,部分张量用单精度是刻意为之——因为误差可控且显存减半。整数则要算好上界:网格点索引 int32 够用(约 21 亿),累计计数器长跑几年就可能溢出,换 int64 更稳。宁可声明时多写几个字符,也不要在深夜调试一个"看起来正确"的数值漂移。
学习目标
阅读完本节,你应当能够:
- 说出 Fortran 五种内置类型,并用 iso_fortran_env 声明指定宽度的整数与实数
- 解释
1.0_real64这种字面量后缀为什么重要,缺了它会出什么精度事故 - 说明 parameter 常量与"声明时初始化隐含 save 属性"这条规则
- 判断什么时候该用 integer、real32、real64,并给出依据
本节要点回顾
- 内置类型是五兄弟:integer、real、complex、logical、character,各配 kind 参数
- iso_fortran_env 是精度的标准答案:real64、int32 等常量让声明跨平台一致
- 字面量后缀保精度:
0.1_real64缺了后缀,精度事故从声明期就埋下 - parameter 是单一事实来源:物理常数与数组边界一律用它,改一处全工程生效
- 初始化隐含 save:需要每次重置的变量,在过程体内赋值,不要在声明行初始化
- kind 选型看误差预算:双精度起步是常态,混合精度与 int64 是刻意选择而非偷懒
内置类型是原子,下一步把它们组装成分子:派生类型。