6.3 GPU异构计算与加速器卸载
6.3 GPU异构计算与加速器卸载
本节摘要:单节点的核榨干了,还有 GPU 这层加速度。本节讲清异构计算的基本盘:主机与设备两套内存、数据搬移往往比计算更贵、OpenMP offload 与 OpenACC 怎么把循环送去 GPU,以及写设备代码的硬约束(无递归、无动态分配、数据连续)。读完你会理解"计算跟随数据"这句话的工程含义。
为什么要多一套"设备"
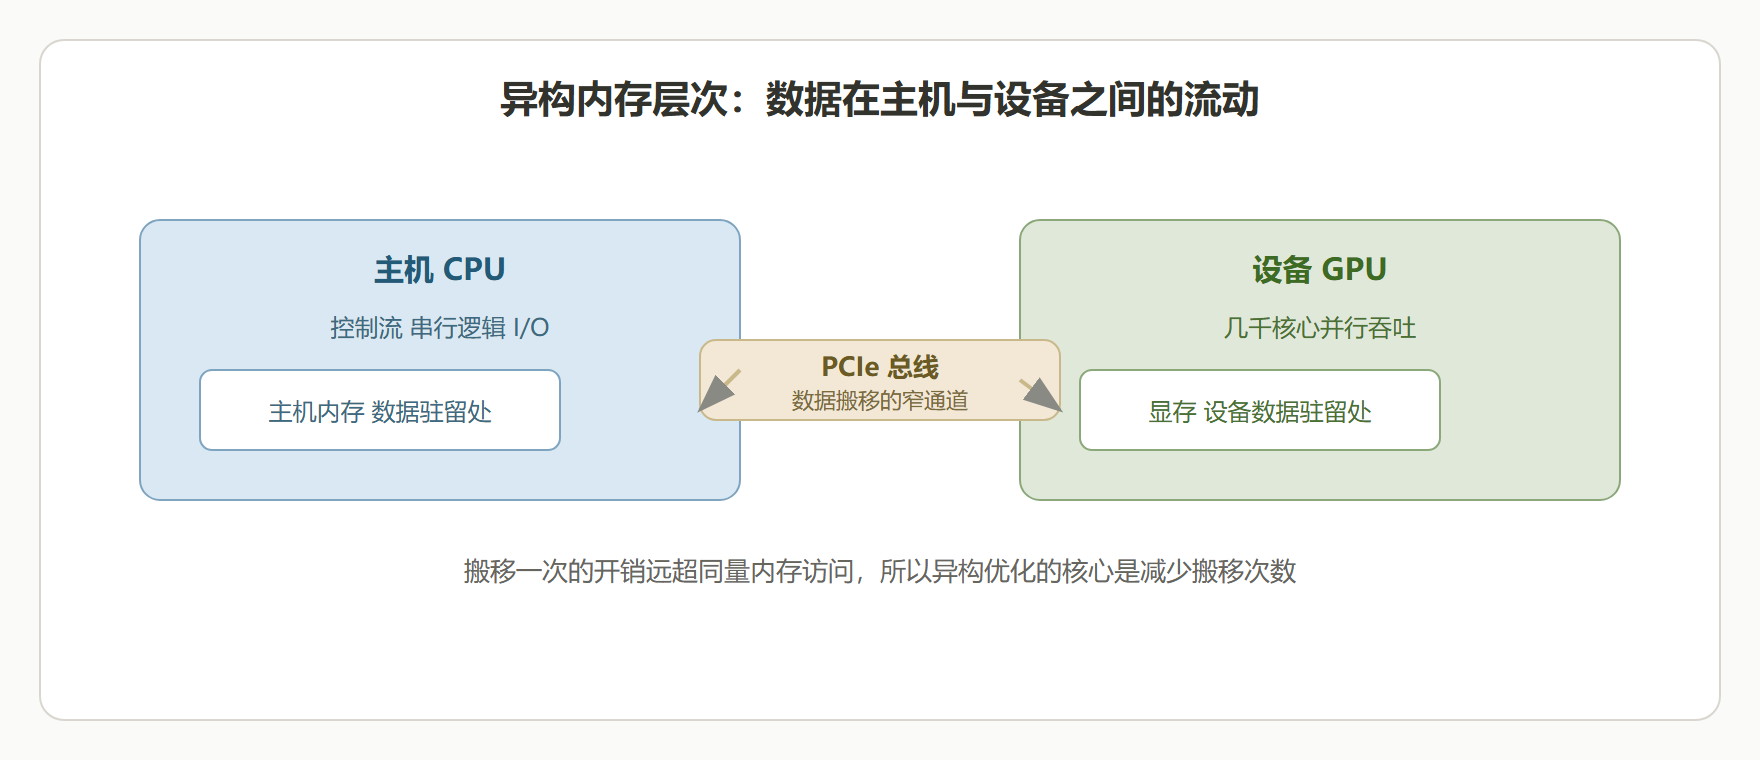
GPU 有几千个轻量核心,擅长大规模并行吞吐;CPU 核少但单个核强,擅长串行与分支。异构计算的思路是各取所长:控制与 I/O 留在 CPU(主机),数值热循环送去 GPU(设备)。但这套分工有一个隐藏成本:GPU 有自己的显存,与主机内存物理隔离,数据来回搬移走 PCIe 总线,速度比内存访问慢一个量级。搬数据常常比算数据贵——这是异构编程的第一课。
主机与设备:两套内存的代价
CPU 程序里,数组就在内存里,随处可用。GPU 程序里,设备只能访问显存里的数据。于是每个 offload 都要面对数据映射问题:哪些数组要送去设备?什么时候送?结果怎么拿回来?Fortran 里这套由指令描述,编译器生成搬运代码。
program gpu_demo use iso_fortran_env, only: real64 implicit none integer, parameter :: n = 1000000 real(real64) :: a(n), b(n), c(n) integer :: i a = [(real(i, real64), i = 1, n)] b = 2.0_real64 !$omp target map(tofrom: c) map(to: a, b) !$omp parallel do do i = 1, n c(i) = a(i) * b(i) + 1.0_real64 ! 这个循环在 GPU 上跑 end do !$omp end parallel do !$omp end target write(*,*) sum(c) end program gpu_demo
map(to: a, b) 把两个数组拷进显存,map(tofrom: c) 把 c 送去再拷回来。这段代码 gfortran 需要 -fopenmp -foffload=nvptx-none 之类的参数,ifx 用 -fiopenmp -fopenmp-targets=spir64,nvfortran 生态最顺。初学别在编译器参数上纠缠,先把指令结构看懂。
offload 指令:把循环送去 GPU
OpenMP 的 offload 由 target 指令承载:target 标记设备执行区域,parallel do 在区域内并行。OpenACC 是另一套类似思路的指令标准,更老牌、更声明式。两者选一即可,多数项目选 OpenMP 因为它与节点内并行是同一套语法。设备端代码的约束随之而来:
- 不能递归调用(GPU 栈管理复杂)
- 不能在设备代码里做动态分配(除非用统一内存等特殊模式)
- 数据要连续(回忆第 3 章:不连续数组在设备上是性能灾难)
这些约束本质上都在说同一件事:GPU 是"数据规整、逻辑简单、量大管饱"的执行器。把递归、动态结构、稀疏不规则逻辑留在 CPU,把规整的热循环送去设备。
数据搬移决定成败
异构程序的性能,通常不取决于 GPU 算得多快,而取决于数据搬得有多省。三条经验:一是尽量少搬——只送计算需要的部分,别把整个结构体全拷过去;二是搬一次算多次——外层 target 区域包住多次设备计算,避免循环里反复来回拷贝;三是想清楚 tofrom——只读数据用 to,只在设备算的结果用 from,能省一半搬运。
program gpu_batch use iso_fortran_env, only: real64 implicit none integer, parameter :: n = 1000000 real(real64) :: x(n), y(n), z(n) integer :: step, i x = 1.0_real64; y = 0.0_real64; z = 0.0_real64 !$omp target data map(tofrom: z) map(to: x, y) do step = 1, 100 !$omp target teams distribute parallel do do i = 1, n z(i) = z(i) + x(i) * y(i) * 0.001_real64 ! 100 步共用一次数据搬移 end do !$omp end target teams distribute parallel do end do !$omp end target data write(*,*) sum(z) end program gpu_batch
target data 区域把数据映射保持 100 步迭代,只搬一次;如果每步都单独 target,就是 100 次来回搬运,时间全花在 PCIe 上。这个模式(先布局数据、再循环计算)是异构编程的黄金法则。
图:主机与设备的异构内存层次
设备代码的调试与验证
GPU 代码的问题有两类:逻辑错与性能差。逻辑错先用单线程模式跑(多数编译器支持 CPU 回退,比如 gfortran 的 -foffload=none 之类),确认结果正确再上设备。性能差用事件计时量化搬移与计算各自的占比——如果搬移占大头,方向不是优化内核而是减少搬移。对照参考实现核对数值结果,GPU 浮点约化顺序不同,结果与 CPU 在最后几位有差异是正常的,判据要留容差。
学习目标
阅读完本节,你应当能够:
- 说出主机与设备内存分离带来的核心代价
- 用 OpenMP target 指令 offload 一个循环,并配置数据映射
- 解释数据搬移开销为何常超过计算本身,给出应对策略
- 列出设备端代码的三条常见约束
本节要点回顾
- 异构是两套内存的系统:数据搬移经 PCIe,往往比计算更贵
- target 区域承载 offload:map 子句声明数据流向,to 与 from 分清楚能省一半搬运
- 设备代码有三条约束:不递归、不动态分配、数据连续
- 少搬、搬一次算多次:target data 保持数据驻留,循环内避免反复拷贝
- 异构第一课是数据布局:把规整热循环送去 GPU,把不规整逻辑留在 CPU
- 验证留容差:GPU 归约顺序不同,与 CPU 末位差异属正常
并行层齐了,下一章把这些代码接进更大的世界——互操作与混合语言。