8.3 代码规范、遗留迁移与AI时代的角色
8.3 代码规范、遗留迁移与AI时代的角色
本节摘要:演化日志的收尾。为什么五十年前的代码还活着?因为它的数值内核没有替代品。本节给出让代码继续活下去的三件事:定规范(让下一代人读得懂)、做迁移(诊断、包壳、替换的渐进路线)、找位置(在 AI 时代当好"物理保真的求解器",与代理模型搭档)。读完你能为一段老代码做出"救、怎么救、救完放哪"的完整判断。
五十岁的代码为什么还活着
1957 年写的算法,今天还在产线数据里跑——这不是程序员恋旧,而是经济账:那些数值内核经过数十年验证与调优,物理行为、数值稳定性、性能特性都是真金白银换来的。重写一遍,等于扔掉几代人的调试经验。Fortran 老代码活着的真正原因,是"正确性积累"无法被语言的新鲜感替代。所以这一节不谈"抛弃旧代码",谈怎么让它继续产出价值。
规范:让代码能被下一个十年的人读
代码首先被人读,其次被机器跑。Fortran 工程规范的核心条目并不复杂:每个程序单元开头 implicit none;模块与类型用可读的命名并加注释说明物理含义;所有过程进模块、配显式接口;常量用 parameter 集中定义;变量作用域尽量小;数组访问遵守列优先;错误处理按 8.1 的防线执行。再加一条元纪律:代码评审里把"是否遵循规范"当成可审查项,而不是各写各的。规范的价值在项目换人时兑现——十年前的人写的代码,十年后的人能接手,这才是传承。
module diffusion_mod use iso_fortran_env, only: real64 implicit none real(real64), parameter :: diffusivity = 1.0e-5_real64 contains !> 一维显式扩散推进一步,返回是否稳定的标志 subroutine advance_1d(u, dt, dx, stable) real(real64), intent(inout) :: u(:) real(real64), intent(in) :: dt, dx logical, intent(out) :: stable real(real64) :: coeff, d(0:size(u)) integer :: i coeff = diffusivity * dt / (dx * dx) stable = coeff <= 0.5_real64 ! 显式格式的稳定性条件 d(0) = u(1); d(size(u)) = u(size(u)) ! 边界值 do i = 1, size(u) - 1 d(i) = u(i) end do do concurrent (i = 1:size(u)) u(i) = d(i) + coeff * (d(i-1) - 2.0_real64*d(i) + d(i+1)) end do end subroutine advance_1d end module diffusion_mod
这段代码示范了规范的具体样子:模块封装、parameter 常量、intent 全标注、稳定性条件显式返回、DO CONCURRENT 表达并行意图。读的人不需要翻手册就能理解每行在干什么。
诊断老代码:先判断年代
迁移的第一动作是诊断,不是动手。按第 1 章的标准史给代码定年代:F66/F77 代码的典型特征是固定格式、隐式类型、COMMON 块、GOTO 控制流——风险在全局状态与隐式类型;F90 代码引入自由格式与模块,风险在"模块用了一半"的半吊子状态;2003 之后的代码才有 OOP 设施,风险在过度抽象。诊断清单对照:有没有 implicit none?有没有 COMMON?数组按什么顺序访问?过程有没有显式接口?有没有边界检查?这份清单输出一份风险地图,迁移优先级按风险排序:先处理静默错误风险(隐式类型、无边界检查),再处理可维护性风险(COMMON、GOTO)。
迁移路线:包壳、渐进、替换
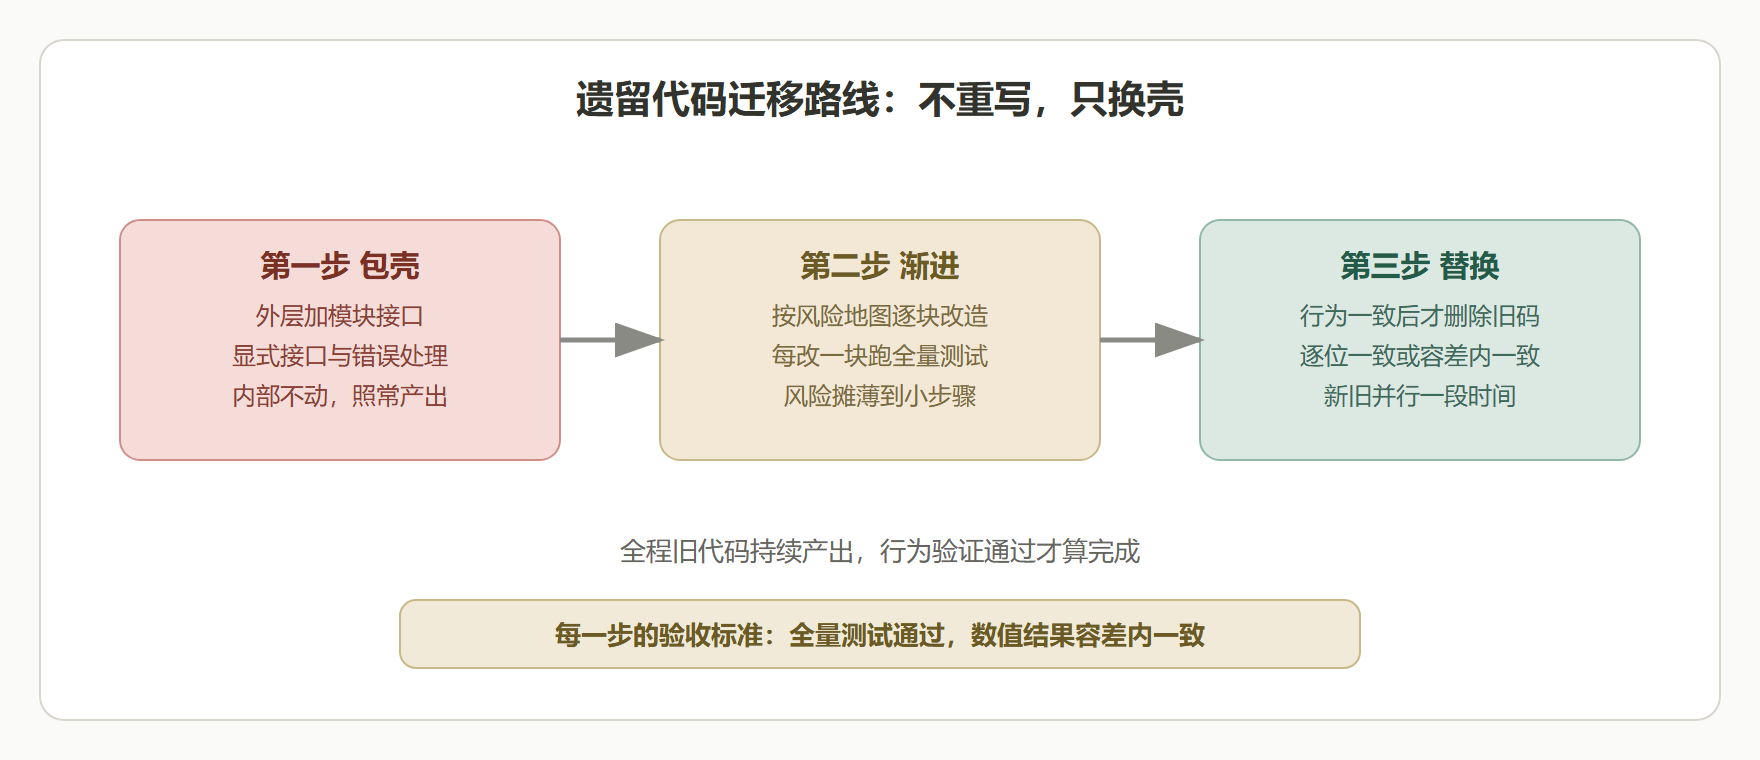
迁移的大忌是"重写"。数值代码重写最容易引入精度漂移与行为差异,而行为差异恰恰无法通过测试完全覆盖。工程上认可的路线是"包壳、渐进、替换"三步。第一步包壳:给老代码外面包一层现代接口——模块、显式接口、错误处理,老代码内部先不动;第二步渐进:按诊断清单的风险优先级,逐块把内部迁到新风格,每迁一块就跑一遍全量测试(8.2 的基础设施在这里兑现);第三步替换:确认数值行为逐位一致或容差内一致后,才允许删除旧实现。整个过程旧代码一直在产出,风险被摊薄到每个小步骤里。
图:遗留代码迁移路线——包壳、渐进、替换
AI 时代的位置:物理内核加代理模型
AI for Science 的混合建模给 Fortran 找到了新位置。传统物理求解器保证守恒律与物理一致性,神经网络代理模型提供加速与补全——两者的结合是"物理保真 + 数据驱动"的典型分工。Fortran 内核在这里的角色没变:它依然是那个把偏微分方程算准的引擎,只是现在旁边多了个"学生"在向它学习、加速它。具体形态包括:用 Fortran 求解器生成训练数据(这是高质量数据的来源),把训练好的代理模型嵌入求解流程(通过第 7 章的互操作接进 Fortran),以及在混合精度场景里让 Fortran 内核负责关键精度、代理负责速度。这个分工意味着 Fortran 掌握的东西——数组语义、数值稳定性、并行性能——在新的工作流里依然是稀缺能力。
收尾的判断:救不救、怎么救、放哪
面对一段老代码,完整的决策链是:先诊断(年代、风险地图),再评估(它是不是仍有不可替代的数值内核),然后迁移(包壳、渐进、替换),最后定位(在混合工作流里它该站在哪一层)。如果内核已被现代库覆盖且无性能差异,弃用是理性的;如果它的物理行为是几十年验证积累,救它比重写便宜得多。判断的底线永远是数值行为的一致性——重写带来的行为差异,比技术债更难偿还。
学习目标
阅读完本节,你应当能够:
- 列出 Fortran 代码规范的核心条目(命名、隐式声明、模块组织)
- 按标准年代诊断一段遗留代码的风险点
- 复述"包壳、渐进、替换"的迁移流程
- 说出 Fortran 内核在 AI 与科学计算混合工作流里的分工
本节要点回顾
- 老代码活着的理由是正确性积累:数值内核的验证经验无法被语言新鲜感替代
- 规范让代码可传承:implicit none、模块、intent、parameter 是基本盘
- 先诊断后动手:按标准年代给代码定级,风险地图决定迁移优先级
- 迁移走包壳、渐进、替换:不重写、摊薄风险、行为一致才换
- AI 时代 Fortran 是物理内核:与代理模型搭档,守恒律由它兜底
- 决策链完整走完:诊断、评估、迁移、定位,数值一致性是最终验收线
演化日志到此收尾——回到第 1 章重读标准史,你会看到同一个故事的两副面孔。