1.1 为什么是 FPGA:可编程硬件的生态位
1.1 为什么是 FPGA:可编程硬件的生态位
本节摘要:FPGA(现场可编程门阵列)是一种能在制造完成后继续改写内部电路的芯片。本节用"能效比 × 灵活性"这把尺子,把它放到 CPU、GPU、ASIC 的计算谱系里定位,给出"什么时候该上 FPGA"的工程判据,并拆解其可重构性的物理来源——SRAM 配置单元与控制开关。
一句老话的来历
软件工程师第一次看到 FPGA 项目,常丢下一句话:"你们就是在玩积木。"这话不好听,但方向是对的——FPGA 的英文全称 Field-Programmable Gate Array,字面意思就是"现场可编程的门阵列"。"现场"二字是全部奥义所在:别的芯片在出厂那一刻电路就焊死了,FPGA 的电路却可以到用户手里再"编程"。这个能力在 1985 年 Xilinx 推出第一款商用 FPGA 时是离经叛道的——当时主流观点认为,硬件就该一次做对,哪有出厂后还让客户随便改的道理。事实证明这个"怪主意"活到了今天,而且活得越来越好。
理解它为什么能改,要从制造工艺说起。FPGA 内部布满了海量的可编程开关,这些开关的状态由片上 SRAM 单元里存的一串比特决定。芯片上电后,SRAM 内容是空的,系统必须先从外部存储器(通常是 SPI Flash)把配置比特流加载进来,SRAM 单元才"记住"每个开关该合上还是断开,从而把成千上万个逻辑单元连成一个你设计的电路。
一个直接的工程后果:基于 SRAM 的 FPGA 断电即失忆,所以每次上电都要重放配置,启动时间比 MCU 慢。这是用灵活性换来的代价,接受它,后面所有环节都好理解。
能效与灵活性:一把尺子量四种平台
先别急着背定义。我们建立一个简单的坐标系:横轴是能效比(每瓦特能算多少),纵轴是灵活性(逻辑能不能改)。四个平台往上一摆,位置一目了然。
计算平台能效与灵活性定位图
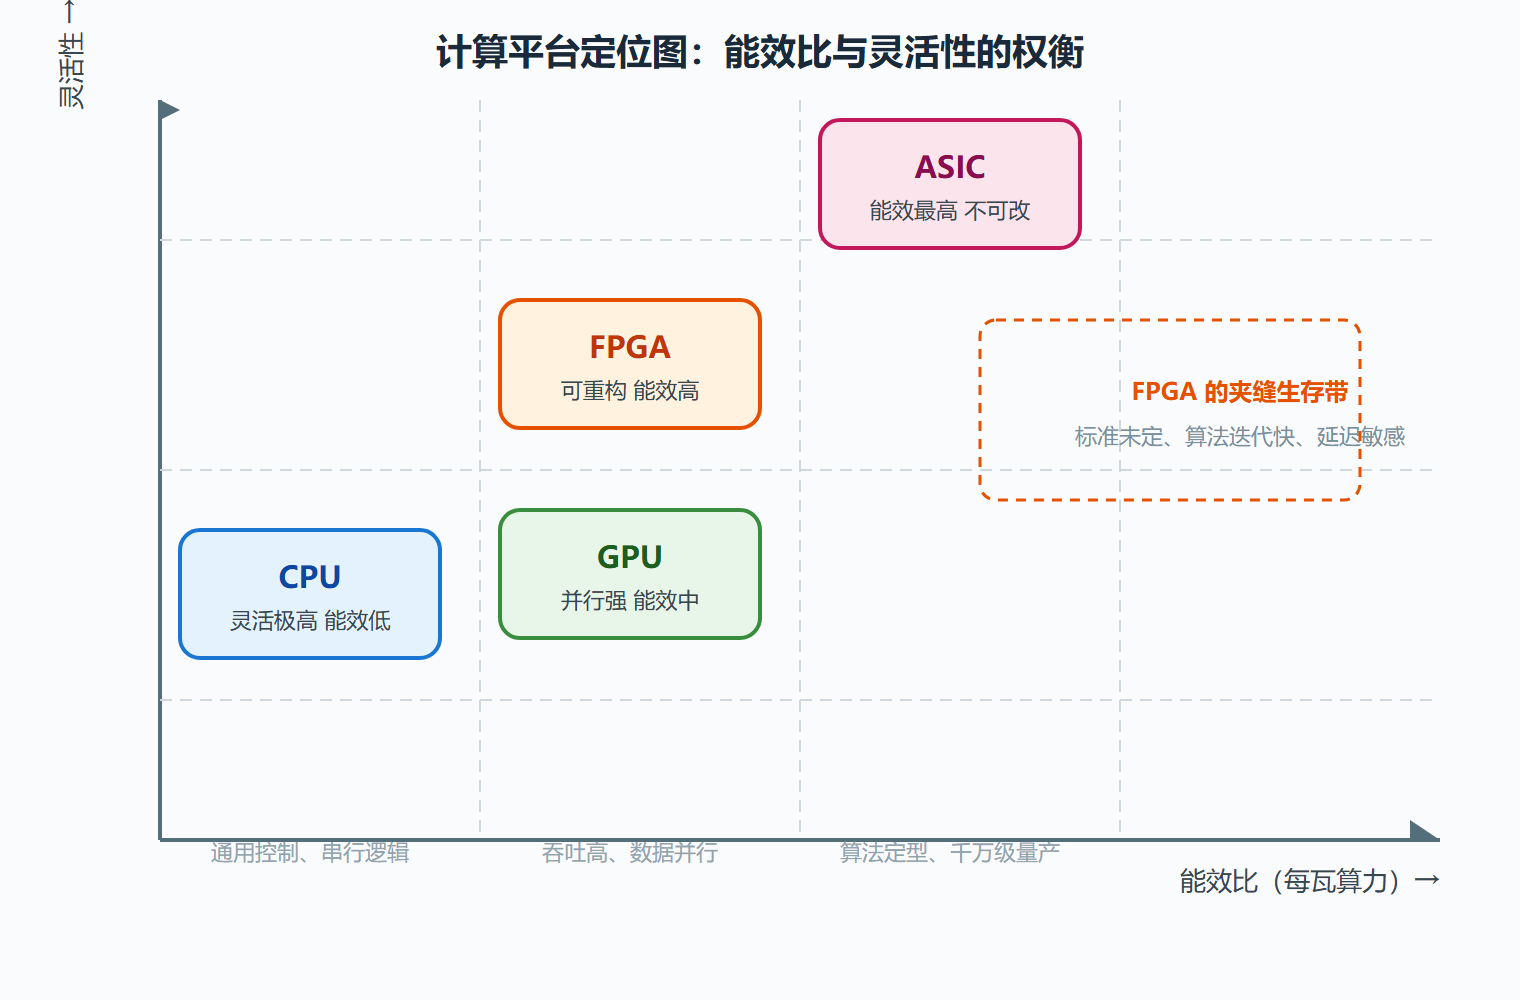
图里的四个角值得记住:ASIC 能效最高但灵活性归零,CPU 灵活至极但能效垫底,GPU 靠海量并行卡在中间偏下,FPGA 独占"高灵活性 + 高能效"这个别人进不来的象限。这不是宣传话术,而是架构决定的:FPGA 不做取指译码、不维护缓存一致性,数据沿定制的通路直接流动,所以能效远高于通用处理器;它的电路又能随时重排,所以灵活性远超 ASIC。代价是时钟频率上不去(通常一两百兆赫兹量级,远低于 CPU 的数 GHz),以及单位逻辑的成本和功耗高于 ASIC。
四种平台的取舍账
纸上谈兵没意思,落到数字上才见真章。假设要把一段图像滤波算法搬到某个平台上:
| 平台 | 每瓦算力 | 开发周期 | 灵活性 | 典型场景 |
|---|---|---|---|---|
| CPU | 低 | 数周(软件) | 极高,改代码即改功能 | 控制流、生态、复杂分支 |
| GPU | 中高 | 数周(CUDA 等) | 较高,仅限并行算法 | 训练、渲染、大数据并行 |
| FPGA | 高 | 数月(硬件) | 高,可反复重配 | 协议多变、低延迟、边缘推理 |
| ASIC | 最高 | 一年以上(流片) | 无,出厂即定 | 百万量级以上的固定算法 |
读这张表有个关键判断:开发周期是隐性的最大成本。ASIC 流一次片动辄千万级费用、一年周期,算法稍有变动全部推倒;FPGA 改一版比特流只需要重新综合布局布线,几天就能迭代一轮。所以"标准尚未冻结、算法还在演进、量级又不够大"的产品,几乎只能选 FPGA——通信基站的协议更新、工业现场多协议网关、交易撮合的前端加速,都是这么活下来的。
什么场景该上 FPGA
把上面的讨论收成三条可操作的判据,项目立项时对着打钩:
- 算法变还是不变:算法一年内还可能大改 → FPGA;五年不变且量百万级 → ASIC。
- 延迟能不能等:微秒级甚至亚微秒级硬实时(高频交易、工业伺服、雷达)→ FPGA;毫秒级可接受 → CPU 足矣。
- 算力形态是否规则:规则的大规模并行(矩阵、卷积)→ GPU 更划算;不规则、数据流型、要求确定时延 → FPGA。
顺带说一个反例,避免把 FPGA 神化:深度学习训练用 FPGA 是常见的错误选择。训练需要灵活的浮点精度和海量显存带宽,FPGA 在浮点上吃亏,训练场景 GPU 优势明显;倒是推理(尤其是低精度、定制化算子的边缘推理)FPGA 常能反超。选型不是看名气,是看数据流形态。
一个真实的选型案例:协议网关
把三条判据用到具体产品上,看看"为什么是 FPGA"在现实里怎么落地。
背景:某工业设备厂商要做一个多协议网关,把现场设备的数据采集上来,转成统一格式上报云端。现场协议五花八门:Modbus、CAN、私有串口协议,而且每年都会冒出新的协议变种。
操作:方案对比——ASIC 方案:把主流协议做成固定芯片,开发周期一年以上,新协议一出就作废;CPU 方案:协议软件解析,灵活但延迟大、实时性差,现场总线时序要求苛刻,软件经常赶不上;FPGA 方案:协议栈做成硬件模块,现场需要哪个加载哪个,新协议来了重配比特流即可。
结果:最终选了 FPGA。原因按三条判据对号入座:协议在变(算法变还是不变 → FPGA)、总线有时序硬要求(延迟能不能等 → 硬实时必须 FPGA)、协议处理是典型数据流(算力形态 → 数据流型适合 FPGA)。成本虽然比 MCU 方案高,但避免了"每出一个新协议就重新流片或换板"的隐性深渊。
解读:这个案例最有价值的一点:FPGA 的采购成本高,但全生命周期成本低。把"换 ASIC 的流片费"和"协议迭代的改板费"算进去,FPGA 反而是便宜的选择。这是选型时最容易漏算的一笔账。
变式:同样的逻辑适用于无线通信的协议演进、视频编解码的标准更替、加密算法的升级——凡是"标准还在变、量又不够大"的领域,FPGA 都是那个"扛迭代"的选项。
💡 关键直觉:把 FPGA 想成一个"可以反复重写的专用芯片"。它贵在灵活性,用在 ASIC 不敢投、CPU 顶不住的地方,才是它的正确打开方式。
一句可被引用的总结
FPGA 站在"软件的灵活性"与"硬件的能效"之间的桥头:算法没定稿时它替你扛住迭代,算法定稿后它替你扛住性能,两头都接得住,两头都不完美。
本节要点回顾
- 现场可编程:SRAM 工艺的配置单元控制内部开关,出厂后仍可改电路,代价是断电失忆、启动需外部重放配置。
- 四象限定位:CPU 高灵活低能效,ASIC 高能效零灵活,GPU 卡在中间偏下,FPGA 独占高灵活高能效象限。
- 工程取舍:开发周期是隐性成本,算法未定 + 延迟敏感 + 量级不够大,就是上 FPGA 的时机。
- 反直觉点:FPGA 在推理上常优于 GPU,在训练上几乎总是输给 GPU,选型要按数据流形态定。
- 效率来源:数据沿定制数据通路流动,无取指译码、无缓存一致性开销——这是它高能效的根本原因。
下一步进入 1.2:既然 FPGA 这么能打,它内部到底堆了哪些"建材"?LUT、触发器、BRAM、DSP 逐一登场。