1.2 FPGA 内部资源解剖:LUT、FF、BRAM、DSP
1.2 FPGA 内部资源解剖:LUT、FF、BRAM、DSP
本节摘要:FPGA 芯片内部主要堆着四类施工材料——查找表 LUT(组合逻辑)、触发器 FF(时序状态)、块存储 BRAM(片内大容量缓存)、DSP 切片(硬核乘法器),外面再包一圈 IO 与互连资源。本节逐一解剖它们的原理、容量与用法,并解释为什么互连会吃掉芯片一半面积。
先看一组数字
一块中端 FPGA 里装着什么?拿常见的 Artix-7 系列举例:约 5 万个 6 输入查找表,约 10 万个触发器,约 270 个块存储(每个 36 Kbit,合计约 1 MB),约 200 个 DSP 切片。一块几厘米见方的芯片,集成了超过十亿个晶体管。三十年前这些资源只够做一个"胶合逻辑"(把几块芯片粘起来的那点连线逻辑),今天它装得下一整个带缓存和多核处理器的迷你计算机。
关键不是记住这些数字,而是明白每个数字背后是一类"施工材料"。下面逐个解剖。
四样主材:LUT、触发器、BRAM、DSP
查找表 LUT:组合逻辑的万能积木
LUT 的学名是 Look-Up Table。它的本质是一小块 SRAM:给你几个输入,输出就是这个输入组合查表出来的结果。一个 6 输入 LUT 有 6 根输入线,可以视为一张有 64 行的真值表,你能把任意 6 变量布尔函数塞进去。
例如要实现 Y = A & B | C(与或逻辑),综合工具算好三种输入组合下的输出,把这 8 个值写进 LUT 的存储单元,电路就"长"出来了。换个函数?重写存储单元即可——这就是 FPGA 可重构的最小单元。
// 概念示例:一段组合逻辑,综合后会被映射进一个或多个 LUT // 输入 4 位,输出 2 位,功能:检测 A 是否大于 B,并给出两数按位与 module lut_demo( input [3:0] a, input [3:0] b, output a_gt_b, output [3:0] a_and_b ); assign a_gt_b = (a > b); // 比较器:综合工具用 LUT 搭 assign a_and_b = a & b; // 逐位与:4 个 LUT 就够 endmodule
注意第二行赋值:a & b 只用了 4 个 LUT(每输出位一个),比较器 a > b 稍复杂,需要几张 LUT 级联。从代码到 LUT 的映射,就是"逻辑综合"这门工序——第 3 章会专门讲。
触发器 FF:时序逻辑的记忆单元
LUT 记不住状态——它只做纯组合变换,输出完全由当前输入决定。要记住"上电以来发生过的历史",需要触发器。触发器在时钟沿到来时把输入锁进内部,输出保持到下一个时钟沿。
// 一个 8 位寄存器:时钟上升沿采样输入,输出在下一拍才更新 module reg8( input clk, input [7:0] d, output reg [7:0] q ); always @(posedge clk) begin q <= d; // 非阻塞赋值:描述"下一拍生效"的时序语义 end endmodule
这里有个易错点提前敲黑板:锁存器(latch)不是触发器。如果组合逻辑的 always 块里少写了 else 分支,综合工具可能推断出一个锁存器——电平敏感、不按时钟工作,往往引起时序问题。第 2 章会教你怎么避免,先记住"FPGA 的时序逻辑必须基于触发器"。
块存储 BRAM:片内大仓库
逻辑靠 LUT 和 FF,数据量大一点就需要存储。FPGA 提供两类片内存储:分布式 RAM(用 LUT 拼出来的小容量存储,几十到几百比特,读写快但费逻辑)和块存储 BRAM(专用硬核存储单元,单个 18~36 Kbit,容量大、不占逻辑资源)。工程惯例:小查找表用分布式 RAM,大缓冲、FIFO、帧缓存用 BRAM。
BRAM 有一手绝活——双端口:两个端口可以同时读、同时写、甚至一边读一边写。这个特性让它天生适合做跨时钟域的数据中转站,第 4 章讲异步 FIFO 时会再碰到它。
DSP 切片:硬核乘法器
乘法是 FPGA 里最贵的组合运算之一。用 LUT 拼一个 18×18 位乘法器,要吃掉几百个 LUT 和好几级组合延迟;用 FPGA 内置的 DSP 切片(硬核乘法器),一个时钟周期出结果,不占逻辑资源。中端 FPGA 通常有几百个 DSP 切片,数字信号处理、神经网络卷积、FFT 全靠它们撑吞吐。
// DSP 切片的使用:声明时让综合工具推断乘法,工具自动映射到硬核 module mul_demo( input clk, input [17:0] x, input [17:0] y, output reg [35:0] p ); always @(posedge clk) begin p <= x * y; // 综合工具默认映射到 DSP 切片(可配置强制) end endmodule
用 DSP 还有个隐藏收益:它自带流水寄存器,乘完一拍就能进下一级流水,时序好收敛得多。这是后边时序章节反复强调"能硬核就别用逻辑拼"的原因。
剩下的面积:互连与时钟
看一张 FPGA 芯片的版图,逻辑单元之间挤满了密密麻麻的连线与开关。现代 FPGA 有 50%~70% 的面积花在互连资源上——可编程开关矩阵、分段导线、纵横走线。原因很朴素:逻辑单元本身小,但"单元之间怎么连"必须预留大量可能性,才能覆盖各种设计需求。
互连是双刃剑。它给了灵活性,也带来了不可预测的布线延迟——同样的逻辑,摆法不同延迟差出一大截。这正是 FPGA 时序比 ASIC 难收敛的根源,第 4 章会正面迎战这个问题。
芯片内部资源分布示意
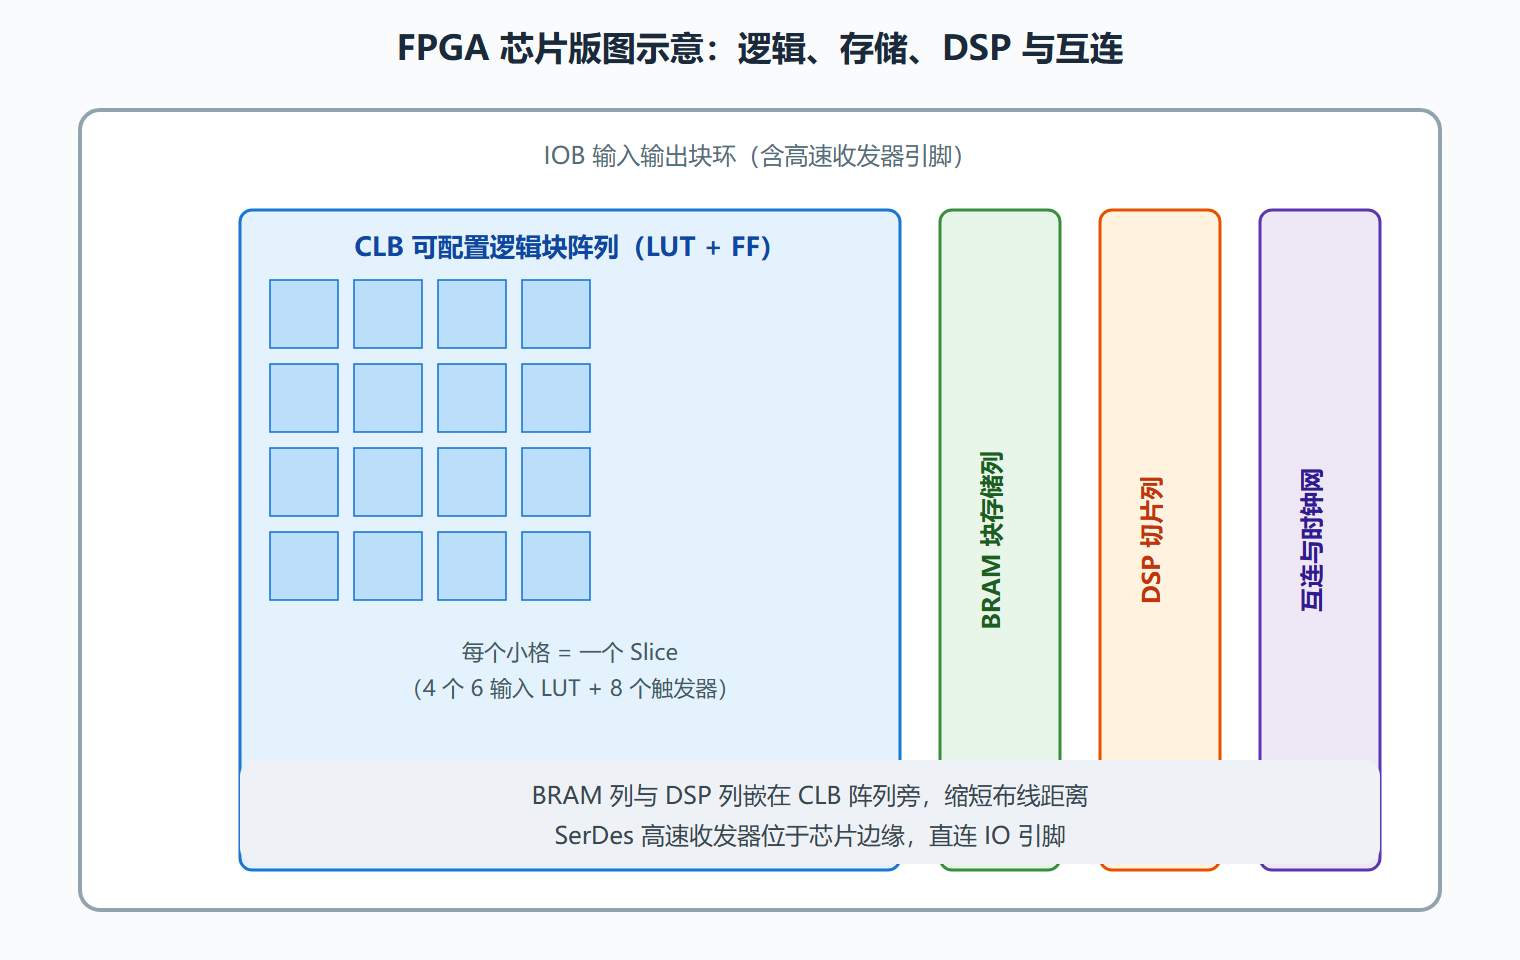
图里有两点值得记忆:一是 BRAM 和 DSP 以"列"的形式嵌进逻辑阵列——这是为了缩短关键布线,DSP 算完就近存进 BRAM;二是高速收发器 SerDes 都在芯片边缘,信号路径最短,第 5 章讲高速接口时会展开。
时钟网络:全厂的"打铃"系统
还有一类资源常被忽略——时钟。触发器统一在时钟沿采样,所以时钟到达每个触发器的时间差(时钟偏斜)必须控制得极小,否则全厂节奏就乱了。FPGA 内部为此铺了专门的时钟树:全局时钟资源从芯片中央往四面八方分发,配合 PLL/MMCM(锁相环)做倍频、分频、相位对齐。这也是为什么 FPGA 设计里"时钟"永远是一等公民,第 4 章会证明它。
资源怎么选,一张表收尾
| 需求 | 首选资源 | 理由 |
|---|---|---|
| 任意组合逻辑 | LUT | 一个 6 输入 LUT 吃下任意 6 变量函数 |
| 时序状态(寄存器、计数器) | 触发器 | 时钟沿采样,时序可控 |
| 小容量缓存(几百比特内) | 分布式 RAM | 不占 BRAM,读写快 |
| 大缓冲 / 帧缓存 / FIFO | BRAM | 容量大、可双端口 |
| 乘法 / 卷积 / FFT | DSP 切片 | 不占逻辑、自带流水、省功耗 |
| 大量数据搬运 | 别用 FPGA 逻辑 | 用 BRAM + DMA 或高速接口 |
⚠️ 常见坑:把存储全部写进触发器(寄存器堆),小型设计没事,一旦缓存超过几千比特,逻辑资源直接爆炸——该用 BRAM 就明确声明,别让工具猜。
本节要点回顾
- LUT 是万能组合积木:6 输入 LUT 实现任意 6 变量函数,可重构的最小单元。
- 触发器记住历史:时序逻辑必须以触发器为基座,锁存器是综合里要警惕的"野生"结构。
- BRAM 与分布式 RAM 分工:小缓存用分布式,大缓冲用 BRAM,BRAM 的双端口是跨时钟域的中转利器。
- DSP 切片是真香:硬核乘法器不占逻辑、自带流水,DSP 类设计先想乘法。
- 互连吃掉半壁江山:布线延迟不可预测,这是时序收敛难的根源。
- 时钟树是厂级基础设施:PLL 倍频、全局时钟资源低偏斜,时钟设计从第 1 天就要正经对待。
下一步进入 1.3:看懂资源之后,面对淘宝上几十种开发板,你该买哪块?工具链怎么装才不会卡在第一步?