3.3 临界区保护的三层手段
3.3 临界区保护的三层手段
本节摘要:内核的就绪链表、你的共享计数器,都会在"读到一半被切走"的瞬间毁掉。FreeRTOS 提供三层防护:中断屏蔽(关掉一部分中断,最硬)、调度器挂起(按停任务切换,中等)、互斥量(只防别的任务,最轻)。本节从一次丢失更新事故讲起,拆解三层手段的作用范围、嵌套规则与各自的禁区,再补上编译器重排与多核内存屏障这两层"看不见的竞争"。读完你能为任何一段共享数据选对防护级别——不多不少。
调度器给了我们并发的自由,也带来了账单:两个执行流同时伸手拿同一份数据,谁都不知道对方的动作会落在自己两次操作的中间。上一节的移植契约里,临界区进出是内核的命门;本节把这套工具完整交到你手上——它们是内核自我保护的手段,也是你保护自己数据的三层防线。
一、先看一场事故:丢失的更新
一段最普通的共享计数器代码,任务与中断同时更新它:
volatile uint32_t g_count = 0; void counting_task(void *arg) { for (;;) { g_count = g_count + 1; /* 读 改 写 三步 */ vTaskDelay(pdMS_TO_TICKS(1)); } } void EVENT_IRQHandler(void) /* 中断也在加它 */ { g_count = g_count + 1; }
"加一"在 C 语言里是一行,在机器里是三步:把值读进寄存器、寄存器加一、写回内存。如果中断恰好落在任务读完旧值之后、写回之前——中断把自己的加一基于同一个旧值——任务恢复后写回的值会把中断的贡献覆盖掉。这就是丢失更新:两次加一,账面只多了一次。它不出现在功能测试里(时序要对上才触发),却在量产现场以"计数偶尔少加"的面目出现。
修复要用对级别的药。这里的数据被"任务与中断"共享,调度器挂起救不了(它管不了中断),互斥量救不了(中断不能拿锁)。只有中断屏蔽对症:把任务里那段读改写包进临界区,确保执行期间相关中断进不来。
/* 正确的一对:进出必须严格配对 */ taskENTER_CRITICAL(); { g_count = g_count + 1; /* 三步读改写,此刻不可分割 */ } taskEXIT_CRITICAL();
二、第一层:中断屏蔽——硬而贵
任务级临界区接口在 Cortex-M3/M4 上的实现不是全关中断,而是设置基地址屏蔽寄存器:数值上低于某阈值的中断(更急的那些)照常响应,其余被挡住。这个阈值就是配置文件里"允许调用内核中断安全接口的最高中断优先级"——被挡住的范围恰好是"可能调用内核接口、因而可能与内核数据竞争"的范围,急中断不受牵连,这是精打细算的折中。M0 上没有这个寄存器,只能全关,代价与粗度都上一个台阶(3.2 节已对比过)。
三条使用纪律。短:临界区内的每一微秒都是所有可屏蔽中断的延迟,标准是几行代码、无循环无调用(确有必要时只调内核的中断安全接口)。配对:进出接口支持嵌套(内部有计数),但多进少出或少进多出都会让中断状态永久错乱,症状是"系统莫名卡顿或某中断永不响应"。不带阻塞:任何可能让任务挂起的调用都禁止出现在临界区内——你把中断都挡了,再去等一个要靠中断推进的条件,就是自锁。
中断里也有对称的一对接口:进入时保存当前屏蔽状态并升级屏蔽,退出时恢复。它解决"中断自身也要碰内核数据"的场景——中断里的临界区用的是同一套机制,只是进出接口不同。
三、第二层:调度器挂起——软而宽
把调度器挂起,任务切换被冻结:当前任务独占处理器直到恢复,但中断照常运行。它的保护范围是"防任务不防中断",好处是禁区小得多——挂起期间可以调用不少函数,也可以干相对长的活(比如几百微秒的内存操作),不至于像临界区那样把中断延迟当赌注。典型用途有两类:一是长时间操作共享结构又不想让中断背延迟;二是调用某些"内部不可分割、但耗时超出临界区预算"的库函数。
vTaskSuspendAll(); { /* 对共享链表的批量整理,任务侧没有竞争者 */ rebuild_cache(); } xTaskResumeAll();
两条红线。挂起期间禁止任何可能阻塞的调用:调度器停了,阻塞接口要么断言拦截、要么把系统带进未定义状态——这是内核文档里加粗的禁令。挂起期间中断照常来:中断里唤醒的高优先级任务不会立刻运行,但会被记为"待切换",恢复调用的瞬间补上切换;所以挂起期间的系统行为是"响应被延迟但不会丢",账要算进实时性预算。
挂起与临界区可以组合(先挂调度器再进临界区),也各自支持嵌套,但反过来"在临界区里挂调度器"没有意义——临界区本来就不让出。
四、第三层:互斥量——轻而专
前两层是"掀桌"手段:要么挡中断、要么冻切换,系统并行度都受损。第三层只针对"多个任务抢一份资源":互斥量像一把钥匙,谁拿到谁进,其余任务睡在锁的等待队列里——不烧处理器、不挡中断。它还有一项独家本领:优先级继承(持锁的低优先级任务被临时抬升,第 4 章展开),把"锁带来的优先级反转"压到可控。代价是它防不了中断(中断不能拿锁)、进出有系统调用开销。
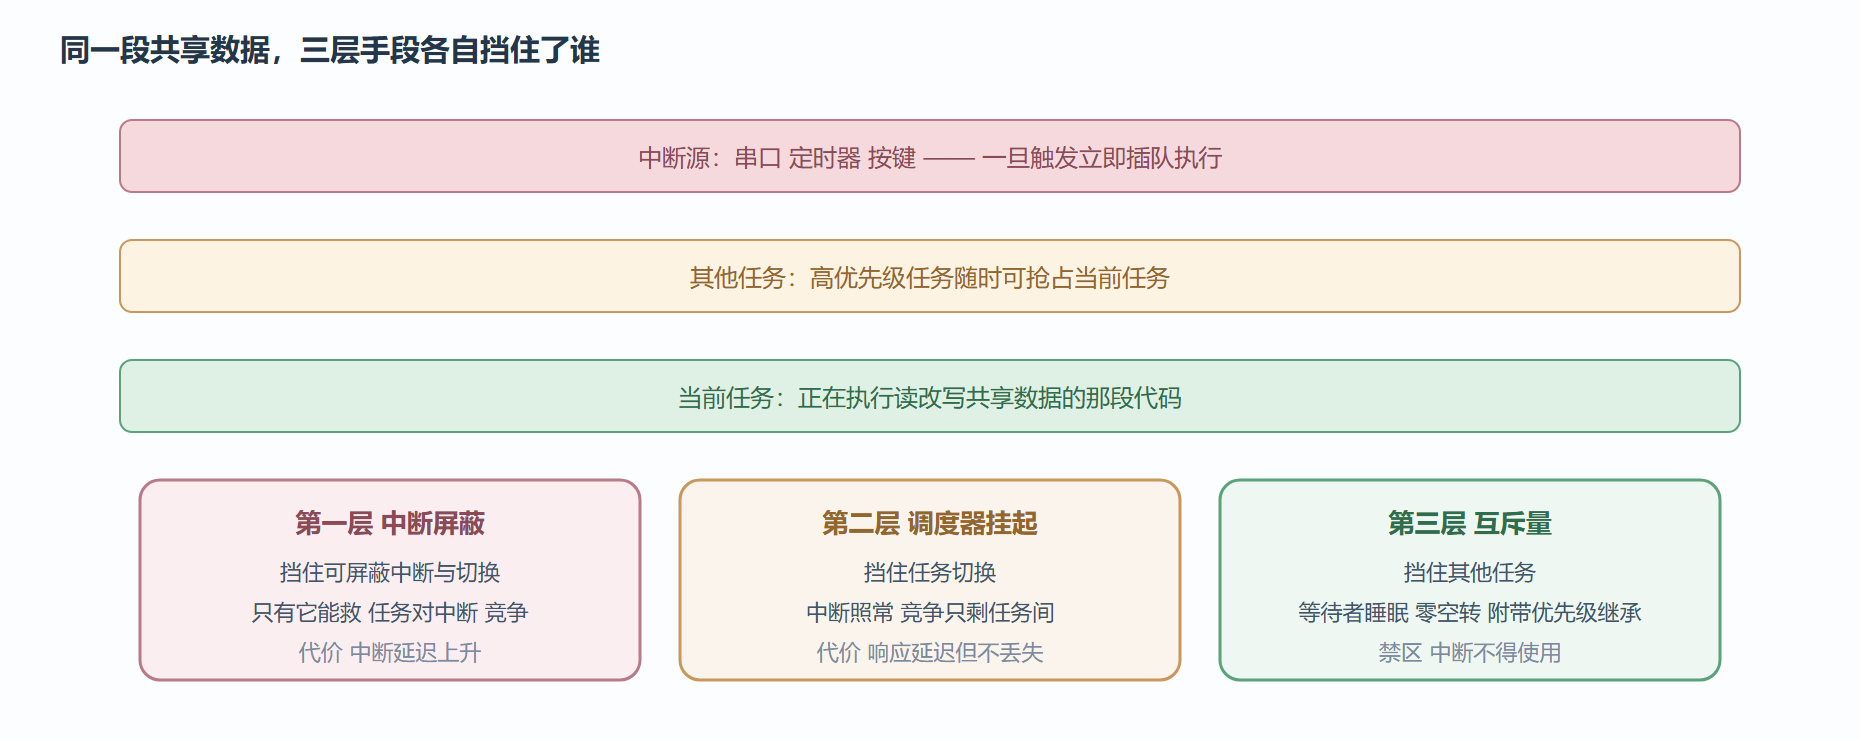
三层防线的本质差别在"挡谁":
| 手段 | 防中断 | 防任务 | 可用时长 | 典型场景 |
|---|---|---|---|---|
| 中断屏蔽 | 部分 | 全部 | 极短(几行) | 任务与中断共享的变量、链表 |
| 调度器挂起 | 不防 | 全部 | 较长(微秒到毫秒级) | 任务间共享结构的批量操作 |
| 互斥量 | 不防 | 全部 | 任意 | 任务间共享资源、外设占用 |
选型口诀:**有中断参与的竞争只有第一层能救;纯任务间的竞争优先第三层(别牺牲并行度);夹在中间的长操作用第二层。**层次用高不用低是浪费系统性能,用低不用高是埋雷。
三层防线的覆盖范围
五、看不见的竞争:编译器与多核
还有两类竞争不靠"切换时机"作案,三层防线对它们无效,必须单独防御。
编译器重排与缓存。编译器为了优化会把无关的读写指令重新排序,你的"先置标志再写数据"在机器里可能顺序颠倒;单核下中断看不见这种重排(中断也走同一套编译结果),但硬件外设与 DMA 看得见。防御手段是屏障:内核的临界区接口自带屏障语义,单独防护时用易失限定符阻止编译器优化,必要处加硬件屏障指令保证写序。经验法则:跨执行流通信的共享变量一律加易失限定,且"数据写完最后写标志"的顺序要用屏障钉死。
多核竞争。单核上"关中断"能让全世界安静,多核上别的核照样跑——V11 内核为多核引入自旋锁:锁住的核原地忙等(而不是睡眠,因为持锁时间必须极短),内核内部结构在多核构建下全部改用自旋锁加临界区组合。应用层的变化不大(内核替你挡了大部分),但"自以为关了中断就绝对安全"的旧直觉必须升级为"关本核中断加拿全局锁"。这也是把临界区纪律压缩到几行的另一个理由:自旋等待的其他核在烧处理器。
💡 防护级别的最低充足原则:先问"竞争者里有中断吗",有则第一层起步;再问"保护的动作有多长",越长越往下层走;最后问"能不能用更高层的原语(第 4 章的队列)干脆消灭共享"——最好的临界区是不存在的临界区。
本节要点回顾
- 丢失更新是读改写被插队:一行 C 是三步机器码,任务与中断共享的数据必有一战;
- 第一层中断屏蔽是唯一能挡中断的手段,M3 用基地址屏蔽保留急中断、M0 只能全关;纪律是短、配对、不阻塞;
- 第二层调度器挂起防任务不防中断,适合较长操作;挂起期间禁止阻塞调用,中断唤醒记为待切换;
- 第三层互斥量零空转、带优先级继承,但防不了中断;三层按"挡谁"选择,用高浪费、用低埋雷;
- 易失限定与屏障防编译器与硬件重排,跨执行流的共享变量与写序必须显式钉死;
- 多核时代关中断不再绝对安全,自旋锁接管内核内部保护——临界区纪律因此更要紧。
内核机构已看完,契约也签了。下一节进入实战:拿一颗全新芯片,把本章三节的知识组装成一次完整的移植交付。