3.2 移植层解剖:把内核接到真实芯片
3.2 移植层解剖:把内核接到真实芯片
本节摘要:内核能在数百种芯片上跑,靠的是一份极薄的契约——移植层。它由三样东西构成:声明架构特性的宏定义头文件、实现切换与启动的移植源文件、按架构定制的栈初始化。本节逐项过这份契约的内容:每个必须声明的特性宏、Cortex-M 上三个异常的分工与优先级安排、滴答源的选择、以及不同内核(M0 与 M3/M4、带浮点与不带)之间的实现差异。读完你能看懂任何一个移植目录,也为下一节亲手移植做好准备。
上一节看完切换的汇编接力,一个自然的问题冒出来:这些汇编凭什么"知道"芯片长什么样?答案是它们不猜——内核把所有架构相关的假设集中隔离在移植层里,其余代码只面对统一接口。这是全软件工程最经典的依赖倒置之一:内核定义"我需要什么",移植层回答"这颗芯片上怎么做"。
一、一份几百行的契约
移植层的目录名按"编译器加架构"组织,里面的宏定义头文件是契约正文,声明内核需要的全部架构事实。逐类看:
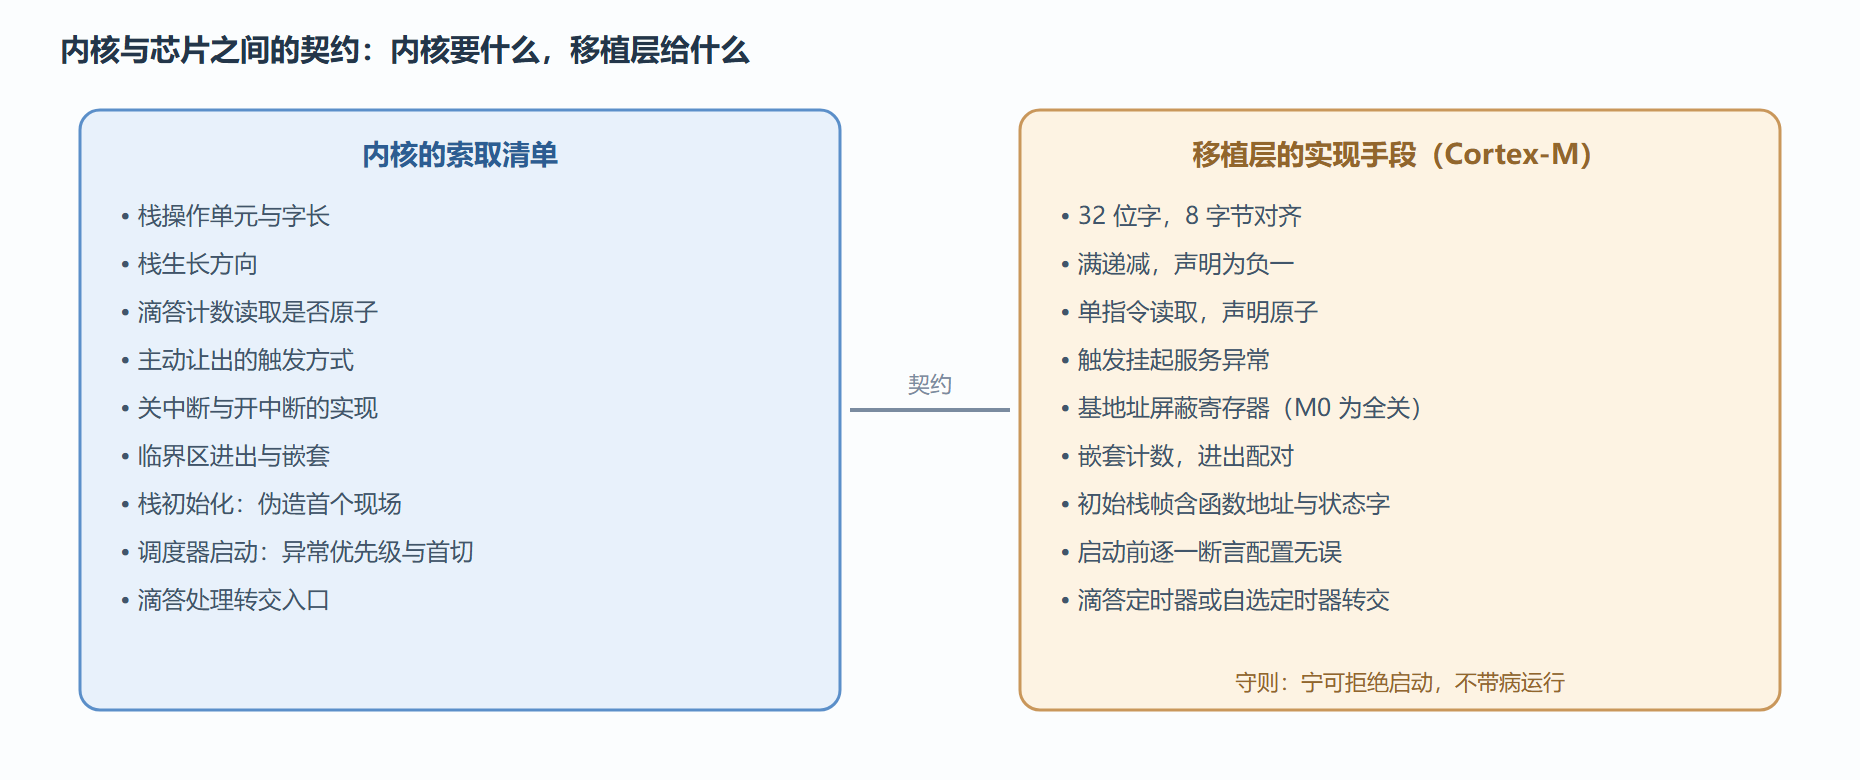
/* portmacro.h 契约要点(以 Cortex-M3 为例的示意) */ #define portCHAR char #define portSTACK_TYPE uint32_t /* 栈操作单元:32 位字 */ #define portTICK_TYPE_IS_ATOMIC 1 /* 滴答读取是原子的,免关中断 */ #define portSTACK_GROWTH (-1) /* 关键:满递减,向下生长 */ #define portTICK_RATE_MS 1 /* 供毫秒换算 */ #define portYIELD() 触发切换异常指令 /* 主动让出 */ #define portNOP() #define portINLINE inline #define portFORCE_INLINE inline __attribute__((always_inline)) /* 临界区入口出口:本架构用基地址屏蔽寄存器实现,见 3.3 节 */ #define portDISABLE_INTERRUPTS() 设置基地址屏蔽 #define portENABLE_INTERRUPTS() 清除基地址屏蔽
两个声明值得单独点出。栈生长方向:内核链表管理不在乎这个,但内存布局全在乎——向下生长意味着栈顶指针从高地址出发、溢出时踩低地址邻居(2.4 节已实战过);有的架构向上生长,同一套检测代码靠这个宏走不同分支。滴答类型原子性:32 位滴答计数在 8 位机上要用两条指令读,读取中途被切换就会得到拼接错的高低位——声明"非原子"后,内核会在读取处自动加保护;32 位平台声明"原子"则省掉这笔开销。契约的意义就在此:内核不需要知道你是什么芯片,只需要知道这些"事实"。
契约的另一半在移植源文件里,实现四个函数:栈初始化(3.1 节已见,伪造初始现场)、调度器启动(配异常优先级、开滴答、送出第一个任务)、滴答处理(喂给内核的滴答服务函数)、切换与启动的汇编例程。四个函数写完,移植就完成了八成——剩下的就是配置与联调。
二、三个异常的分工与优先级安排
Cortex-M 移植的精妙之处集中在三个异常的使用上。启动服务调用:只干一次活——系统启动时把第一个任务的现场装进处理器,之后终身退休。挂起服务调用:所有上下文切换的家,3.1 节讲过它被安排在最低优先级的理由(切换逻辑天然串行化)。系统滴答:心跳源,默认由芯片自带的滴答定时器产生,中断里调用移植层的滴答处理函数转交内核。
优先级安排有条铁律:切换异常与滴答必须处于最低优先级,且数值上等于"全关"的那个级别。原因在 3.1 节埋过——切换不可重入,排在最低就能保证它执行时再无中断来抢。移植的启动函数会亲自设置这两个异常的优先级(不完全信任用户配置,就是为了守住这条铁律),并在启动前逐一断言"配置无误",断言失败直接停机报错。这类"宁可拒绝启动也不带病运行"的防御,是移植层的道德底线。
滴答源有灵活的一面:芯片自带的滴答定时器不合适时(比如低功耗设计里想用别的时间源、或时钟域不一致),移植允许你关掉自带滴答,改用任一定时器,在它的中断里手动调用移植层提供的滴答处理入口。配套还提供一个宏声明滴答时钟频率,供重装载值计算。第 6 章的无滴答低功耗正是建立在这套灵活性上——平时滴答可以整个停掉。
三、架构差异:从 M0 到带浮点的 M4
同一份内核,不同内核形态的移植实现差异不小,理解差异才能选对移植目录。
| 差异点 | Cortex-M0 系 | Cortex-M3 | Cortex-M4F/M7 带浮点 |
|---|---|---|---|
| 临界区手段 | 只能全关中断(无基地址屏蔽寄存器) | 基地址屏蔽,可保留高急中断 | 同 M3 |
| 切换的浮点部分 | 无 | 无 | 惰性压栈,用过浮点才保存 |
| 优化任务挑选 | 无前导零指令,位图扫描 | 前导零指令一条定位 | 同 M3 |
| 字长与对齐 | 32 位但指令集精简 | 32 位 | 32 位,双精度浮点另议 |
三处差异各有一段故事。M0 的全关中断:小核砍掉了基地址屏蔽寄存器,临界区只能把所有中断一关了之——简单但粗暴,中断延迟的抖动因此变大;也正因为如此,M0 项目的临界区更要"短",第 6 章中断延迟分析对它格外敏感。惰性浮点压栈:带浮点的核若每次切换都保存整套浮点寄存器(几十个 32 位字),开销惊人;硬件的惰性机制让"压栈"只先记个账,真有中断要用浮点时才补压——任务从未用过浮点则分文不花。但排障时要记得:开了浮点的任务,栈深预算要把浮点现场算进去,否则就是给 2.4 节的溢出工单添料。前导零指令:一条指令从位图里找出最高非空优先级,这就是 3.1 节"常数时间挑选"的硬件靠山,M0 没有它,退化为软件循环扫描,任务多的系统里这笔差异能被测出来。
选移植目录的口诀随之而来:按内核形态与浮点有无精确对号——M0 的目录给 M0 用(不是"兼容"而是必须),带浮点的核若用无浮点目录,轻则性能浪费,重则浮点现场不保存导致偶发计算错乱,那又是一张难缠的工单。
移植层接口契约全景
四、对齐与时钟:两处最细的针脚
栈对齐。调用约定要求公共接口处栈按八字节对齐,栈初始化函数伪造现场时必须算准:初始栈顶起止地址、帧的大小、压入顺序,差一个字节都会让某些优化选项下的代码读错参数。这也是为什么"参考移植改一改"比"从零手写"靠谱——对齐细节在参考实现里已验证过千百遍。滴答时钟源。某些芯片上滴答定时器的时钟可以与内核时钟不同频,移植为此准备了一个可选的频率声明宏;漏配的典型症状是"所有延时都按固定比例偏差"——延时想睡 1 秒实际睡 8 秒或八分之一秒,一眼看不出但示波器一量就穿帮。这张工单在 8.1 节的坑点清单里会再次出现。
⚠️ 移植层变更的三条军规:一,永远从最接近你芯片的官方参考移植出发,不从空白文件写起;二,动过任何汇编或对齐相关代码后,压测必须包含浮点密集任务与中断密集任务两类负载;三,把移植层的修改记录成文档——它是最容易被"顺手优化"弄坏、又最难排查的代码。
本节要点回顾
- 契约正文是宏定义头文件:字长、栈向、原子性、让出方式、临界区手段——内核只认事实不认芯片;
- 移植源文件实现四函数:栈初始化、调度器启动、滴答处理、切换汇编,写完即移植八成;
- 三个异常分工:启动服务调用只活一次、挂起服务异常承包全部切换、系统滴答供心跳;切换与滴答必须最低优先级,启动函数会亲自断言;
- 架构差异三要点:M0 只能全关中断、浮点用惰性压栈省开销(栈预算要算浮点现场)、前导零指令是常数挑选的硬件靠山;
- 两处针脚最细:八字节对齐靠参考移植传承,滴答时钟频率漏配会让全体延时按比例漂移;
- 三条军规:从参考出发、两类负载压测、修改留档。
契约看完了,但内核还有一块命门没讲:它自己的就绪链表、延迟链表这些全局数据,在任务与中断同时伸手时怎么不被改坏?下一节的临界区保护,就是内核给自己上的锁。