7.1 空间大数据处理
7.1 空间大数据处理
本节摘要:海量轨迹、遥感、传感器数据超出传统 GIS 处理能力。本节讲 Spark、GeoMesa 等空间大数据技术——处理 TB 级空间数据。
本节目标
阅读完本节,你应当能够:
- 理解空间大数据挑战
- 用 Spark 处理空间数据
- 知道 GeoMesa 等技术
概念脉络
一、空间大数据的挑战
传统 GIS 处理 GB 级,大数据是 TB/PB 级:
- 轨迹数据:百万车辆/手机轨迹,持续产生
- 遥感影像:卫星每天 TB 级
- 物联网:海量传感器空间数据
- 社交数据:带位置的海量文本
传统单机 GIS 跑不动,要分布式。
二、空间大数据技术栈
图 7-1 空间大数据技术栈
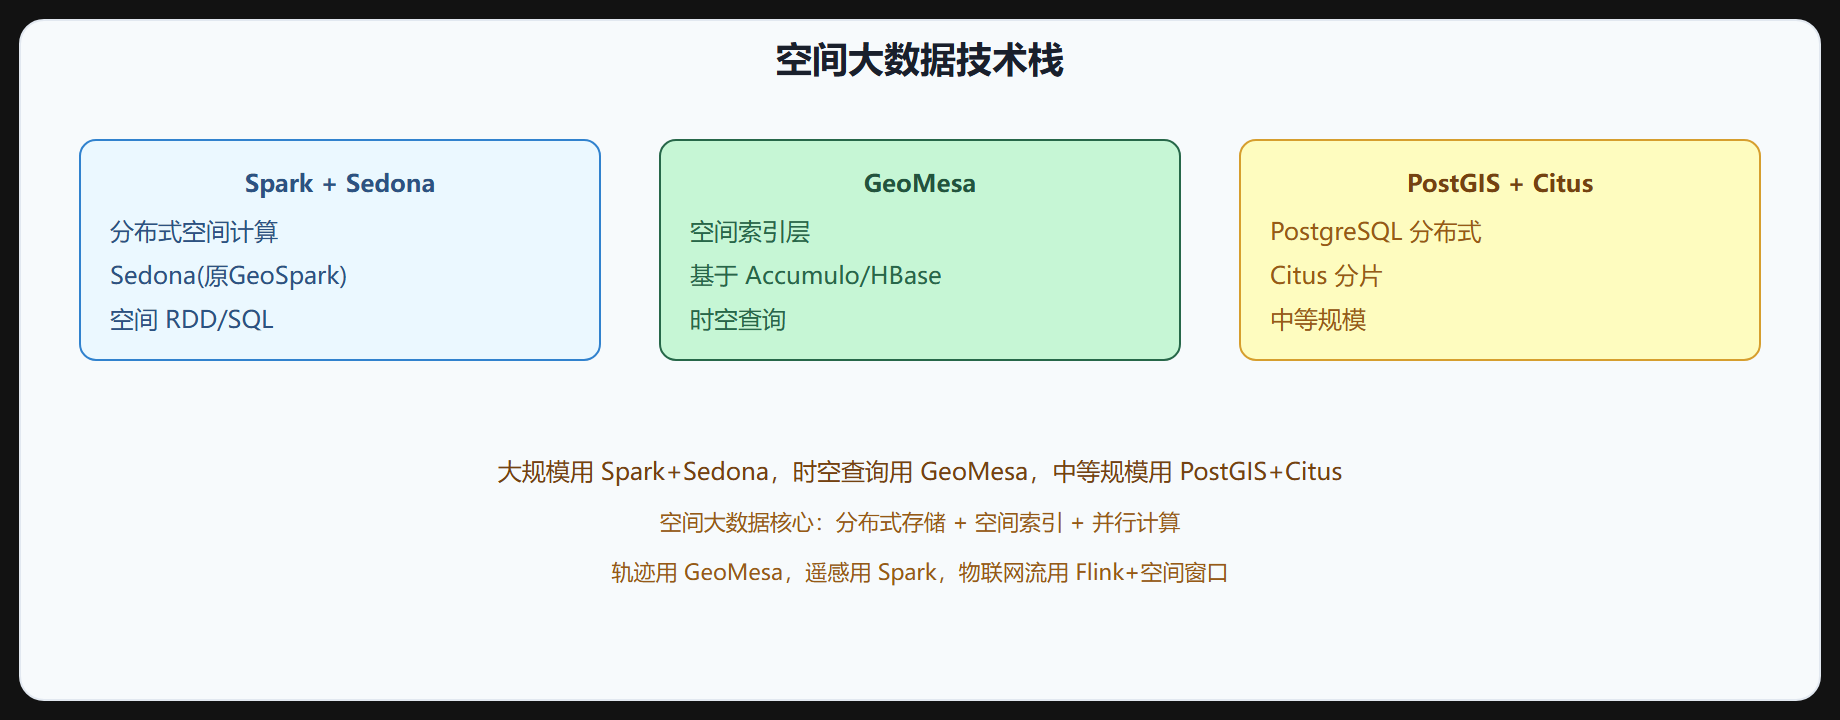
| 技术 | 特点 | 适合 |
|---|---|---|
| Spark + Sedona | 分布式空间计算 | 大规模分析 |
| GeoMesa | 时空索引 | 时空查询 |
| PostGIS + Citus | 分布式 PostgreSQL | 中等规模 |
三、Sedona(GeoSpark)
Sedona 在 Spark 上加空间能力:
from sedona.register import SedonaRegistrator from sedona.core.SpatialRDD import PolygonRDD SedonaRegistrator.registerAll(spark) df = spark.read.parquet("trajectories") df.createOrReplaceTempView("traj") result = spark.sql(""" SELECT id, count(*) FROM traj WHERE ST_Contains(ST_PolygonFromText('...'), geom) GROUP BY id """)
Sedona 提供空间 RDD、空间 SQL、空间索引(R-树),在 Spark 集群并行算空间。
四、GeoMesa
GeoMesa 在 NoSQL(Accumulo/HBase/Kafka)上加时空索引:
- Z-order/GeoHash:空间填充曲线索引
- 时空查询:高效时空范围查询
- 流式:支持 Kafka 流式空间数据
适合轨迹数据、物联网传感器数据。
五、遥感大数据
遥感影像用 Spark + 阿里开源的 GeoPySpark 或 Google Earth Engine:
- 影像分块并行处理
- 时间序列分析(NDVI 时序)
- 大区域镶嵌
六、空间索引在大数据
大数据空间索引要分布式:
- Z-order/GeoHash:一维编码,分布式友好
- R-树:传统空间索引,单机强
- KDB-树/四叉树:分层划分
七、流式空间数据
物联网/轨迹是流式数据,用 Flink + 空间窗口:
- 空间范围订阅
- 轨迹实时聚合
- 移动对象持续查询
⚠️ 常见坑:用单机 PostGIS 处理 TB 级——跑不动。大数据用 Spark+Sedona 或 GeoMesa 分布式处理。
💡 关键直觉:空间大数据用分布式:Spark+Sedona 做大规模分析,GeoMesa 做时空查询,PostGIS+Citus 中等规模。核心是分布式存储+空间索引+并行计算。
八、空间数据分布式分区的策略
分布式系统把数据切分到多台机器,切分方式直接决定空间查询效率:
- 按空间区域切分(空间分区):按网格或行政区把数据分到不同分区,查询时只扫描相关分区。缺点是热点区域(城市中心)数据集中,负载不均。
- 按属性哈希切分(哈希分区):把空间对象按哈希散到各节点,负载均匀,但空间相邻的数据可能分到不同机器,范围查询要广播所有分区。
- 空间填充曲线(Z-order/GeoHash):把二维坐标编码成一维,让空间相邻的点在排序上尽量靠近,兼顾负载均衡和空间局部性,是分布式空间系统的常用方案。
Sedona 默认对空间 RDD 做网格分区,并能为 join 建立空间索引;GeoMesa 用 Z-order 曲线存储,查询时空范围时只读相关文件块。
九、空间 Join 的分布式写法
空间 join(如"每个网格内的轨迹点数量")在 Spark 里用 Sedona 的 SQL 很方便:
from sedona.register import SedonaRegistrator from sedona.utils import SedonaKryoRegistrator, KryoSerializer from pyspark.sql import SparkSession spark = SparkSession.builder \ .config("spark.serializer", KryoSerializer.getName) \ .config("spark.kryo.registrator", SedonaKryoRegistrator.getName) \ .getOrCreate() SedonaRegistrator.registerAll(spark) grids = spark.read.parquet("grids.parquet") points = spark.read.parquet("traj_points.parquet") grids.createOrReplaceTempView("grids") points.createOrReplaceTempView("points") result = spark.sql(""" SELECT g.gid, count(*) AS cnt FROM grids g, points p WHERE ST_Contains(g.geom, p.geom) GROUP BY g.gid """) result.show()
要点:Spark 任务前必须注册 Sedona 的 Kryo 序列化器和 UDT,否则空间类型无法跨节点传输;join 会先做网格分区和空间索引,再广播小表,这部分由框架自动完成,但理解原理有助于调参。
十、GeoHash 的编码与解码
GeoHash 把经纬度编码成字符串,长度越长精度越高。理解它的性质对做数据分片很有帮助:
# Python 示例:GeoHash 编码 import geohash2 code = geohash2.encode(39.9, 116.4, precision=6) print(code) # 6 位精度约 1.2km # 前缀相同的点空间上相邻,适合做分组聚合
用途很多:相同前缀归组做热力图、按前缀建分区表、轨迹压缩等。注意它适合"邻近搜索、聚合"这类场景,不适合精确距离计算,精度不够时要用更长的编码或回到精确几何。
十一、一个空间大数据的实践案例
某共享单车公司要分析"每个运营网格内早高峰的骑行量"。原始数据是每天上亿条 GPS 轨迹点,流程是:
- 轨迹数据入库到 HDFS/对象存储,按天分区。
- Spark + Sedona 把轨迹点与网格做空间 join,过滤漂移点(速度异常的记录)。
- 按网格、小时聚合,得到骑行量统计表。
- 统计表再回同步到 PostgreSQL,供业务系统查询展示。
这个流程的关键教训:不要用数据库做海量点级别的空间 join,它属于分析型负载,交给 Spark 批处理;汇总后的结果才是数据库该管的。分层处理(明细层、汇总层、应用层)是大数据 GIS 的标准结构。
温故知新
- 挑战:TB/PB 级轨迹/遥感/物联网,单机跑不动。
- Spark+Sedona:分布式空间计算,空间 RDD/SQL/索引。
- GeoMesa:NoSQL 上时空索引,Z-order/GeoHash。
- PostGIS+Citus:分布式 PostgreSQL,中等规模。
- 遥感:GeoPySpark/Earth Engine,分块并行+时序。
- 流式:Flink+空间窗口,实时空间查询。
- 索引:Z-order/GeoHash 分布式友好。
下一节讲 AI 和 GIS 融合。